
如何最大化提升 AI 智能体的检索效率
返回
在当前 AI Coding Agent 的工程实践中,代码检索通常以工具调用(Tool Call)的形态嵌入主 Agent 的推理循环:主模型根据用户意图生成检索请求,调用搜索工具获取代码片段,再将结果拼接到上下文中继续推理。这种"主模型直接检索"的范式看似自然,但随着任务复杂度的攀升,其固有短板日益凸显:
把检索从“单次工具调用”升级为专属子智能体的自主探索。引入独立 Search Agent:主模型只给目标与约束,Search Agent 在独立上下文中规划策略、并行搜索、迭代收敛、过滤精炼,最终返回高密度结果。价值:
Search Agent 被设计为只负责检索,不参与推理与生成,因此其上下文更“干净”、目标更单一:围绕“找到信息”展开。这使得我们可以在 prompt 中加入更强的检索指令与高质量工具调用轨迹(tool traces),让每一步搜索更可控、可复用、可评估。
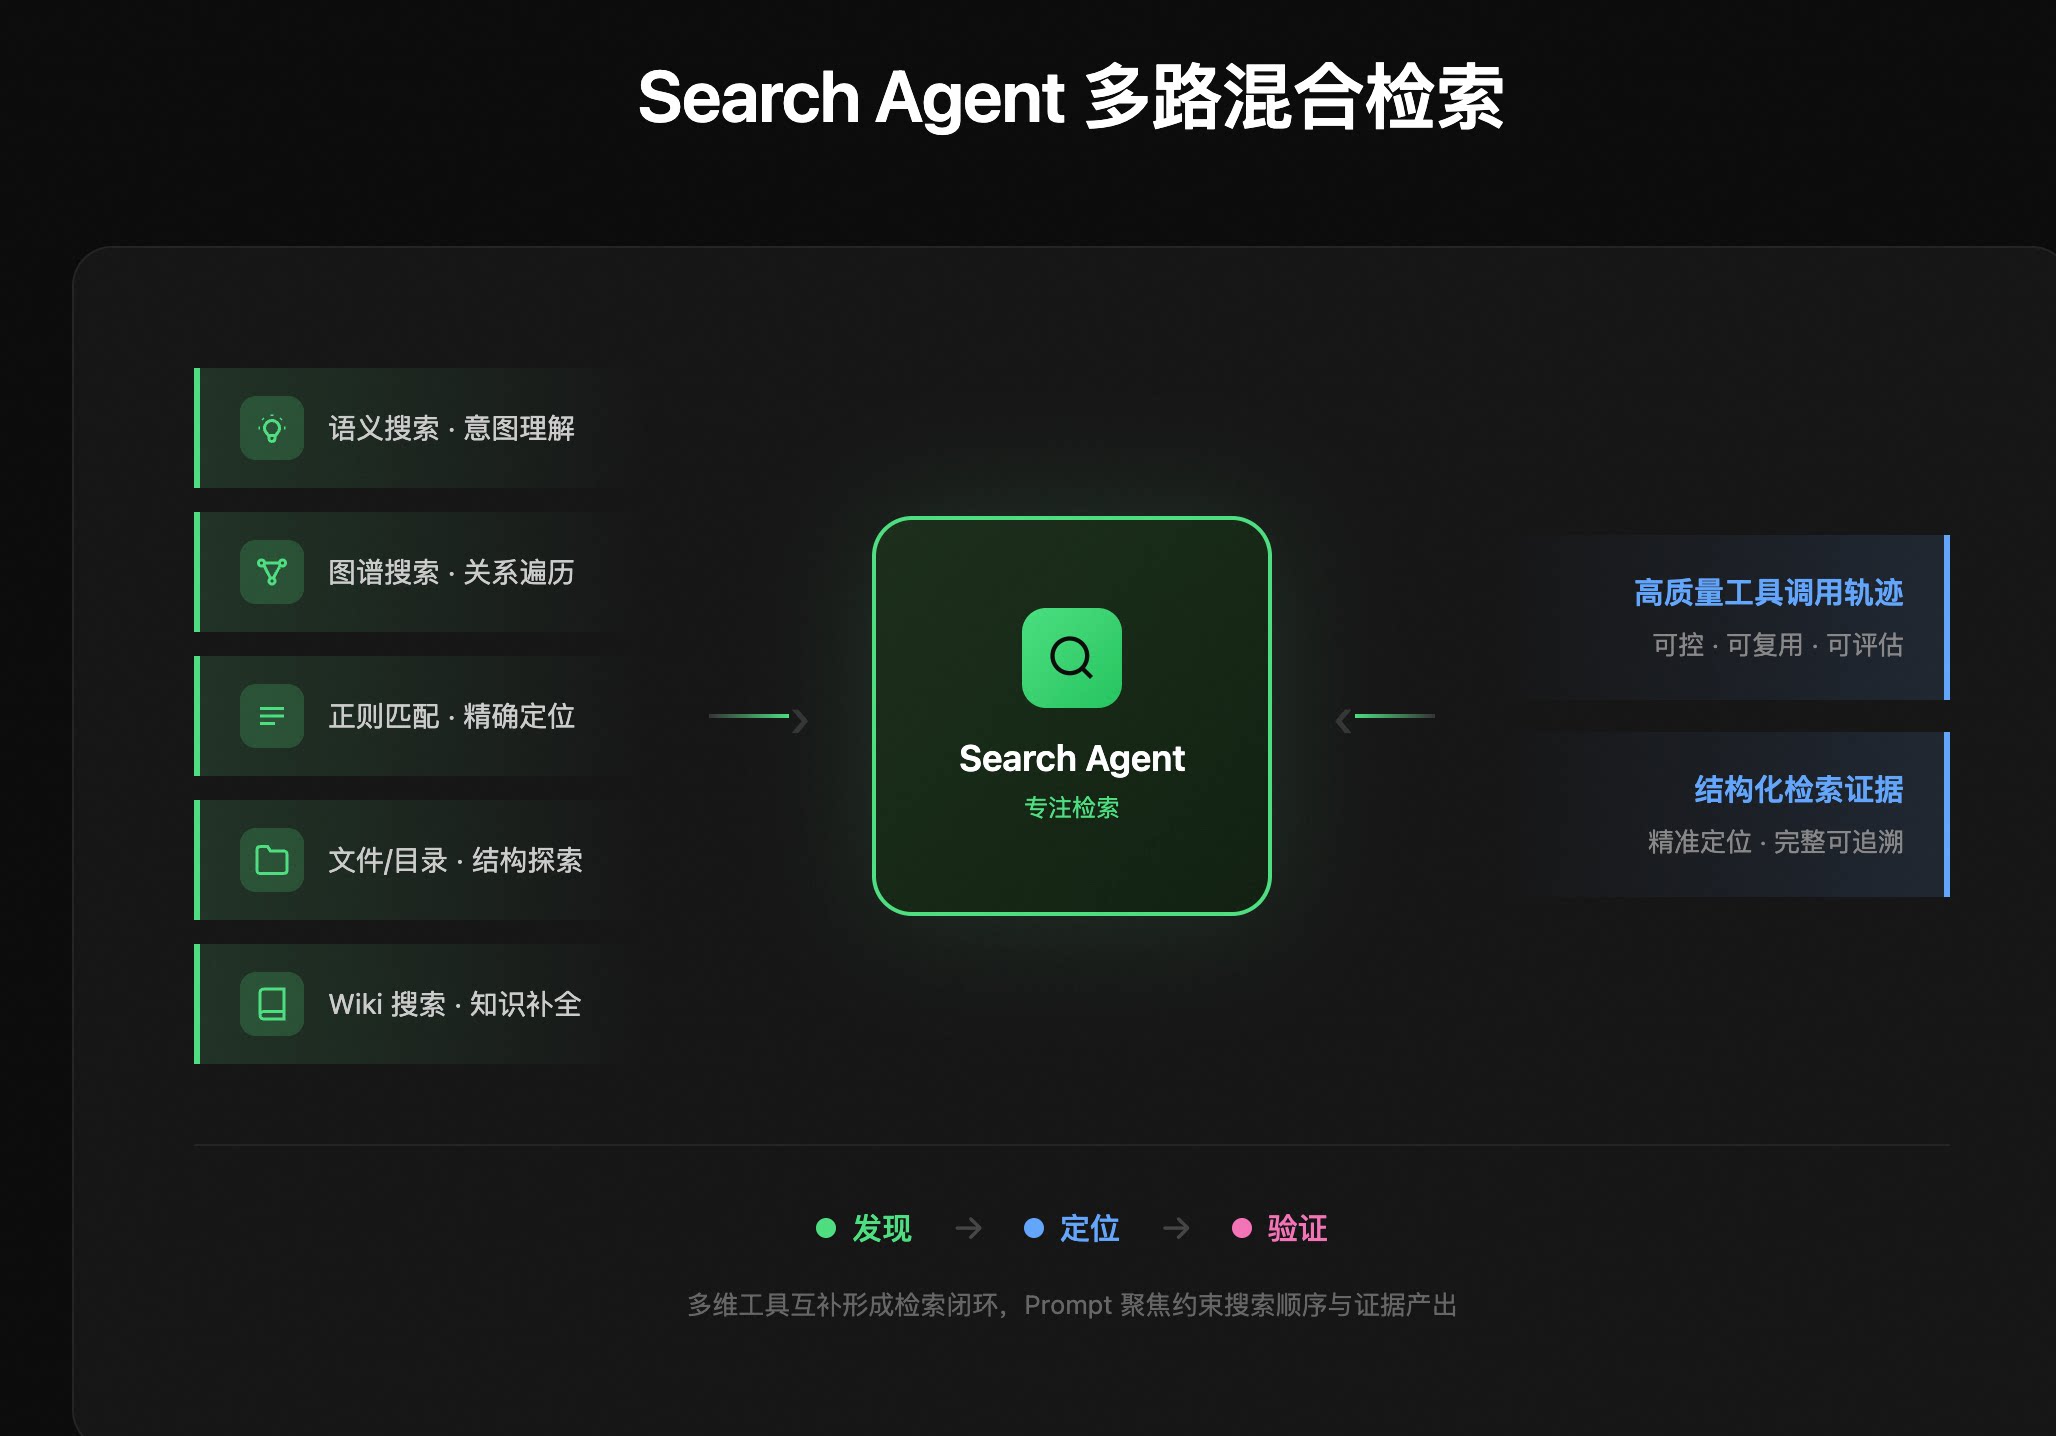 Search Agent 配备覆盖不同检索维度的工具组合:
如下示例case的演示说明,在同等基座模型下,引入 Search Agent 实现了检索职责的解耦。主模型通过异步分发任务,直接获取精炼后的检索结果进行代码生成。该方案显著压缩了推理轮次,使主模型 Token 消耗降低 30.2%。
针对需要深度工程上下文感知能力的复杂任务,我们上线了 Search Agent 并进行了 A/B 对照实验。实验数据表明,该方案在降低主模型 Token 推理开销方面表现优异,且优化幅度随代码仓库规模的扩大而显著递增:
检索质量决定了 AI 智能体的认知上限。从“主模型亲自检索”到“Search Agent 代理探索”,实现了从被动单次检索到主动多轮探索的跃迁:在提升完成质量的同时降低成本。根本原因是检索与推理是不同任务,应由不同智能体承担。未来将继续强化自适应策略、自评估与多级协作,让 Agentic Search 从“能用”走向“好用”。
为什么需要 Agentic Search
传统检索范式的困境
在当前 AI Coding Agent 的工程实践中,代码检索通常以工具调用(Tool Call)的形态嵌入主 Agent 的推理循环:主模型根据用户意图生成检索请求,调用搜索工具获取代码片段,再将结果拼接到上下文中继续推理。这种"主模型直接检索"的范式看似自然,但随着任务复杂度的攀升,其固有短板日益凸显:
- 检索策略的单一性:主模型的单次调用往往局限于单一检索模态(如仅向量搜索或仅符号跳转)。面对"找到鉴权模块的所有中间件实现及其调用链路"这类复合检索需求,主模型不得不在多个推理轮次中反复调用不同的检索工具,推理效率严重退化。
- 上下文窗口的浪费:每一次检索返回的原始结果直接灌入主模型的上下文窗口,其中包含大量低相关性的代码片段。主模型需要在"理解用户意图"与"筛选检索噪声"之间分配有限的注意力,既做推理又做过滤,两者兼顾却都做不好。
- 启发式检索的收敛滞后:单次检索难以命中分散在多个文件、多个层次中的关键信息。主模型只能通过反复的"检索—分析—再检索"循环逐步拼凑完整的信息拼图,每一轮都消耗宝贵的 Token 预算和用户等待时间。
- 角色错配:主模型的核心能力在于逻辑推理与代码生成,而非检索策略的规划与优化。让一个通用推理模型来决定"先搜什么、再搜什么、如何组合多路结果",本质上是在用高成本的推理能力做低层次的信息调度。
Agentic Search 的核心思想
把检索从“单次工具调用”升级为专属子智能体的自主探索。引入独立 Search Agent:主模型只给目标与约束,Search Agent 在独立上下文中规划策略、并行搜索、迭代收敛、过滤精炼,最终返回高密度结果。价值:
- 职责解耦: 实现“高阶逻辑推理”与“低阶信息检索”的解耦,主模型聚焦于意图理解与代码生成,Search Agent 垂直深耕检索广度与深度。
- Token 更省:用更小/更便宜模型先筛选,精炼后再喂给主模型。
- 能力更强:可并行、多轮迭代、策略组合,覆盖更深更广。
技术方案设计
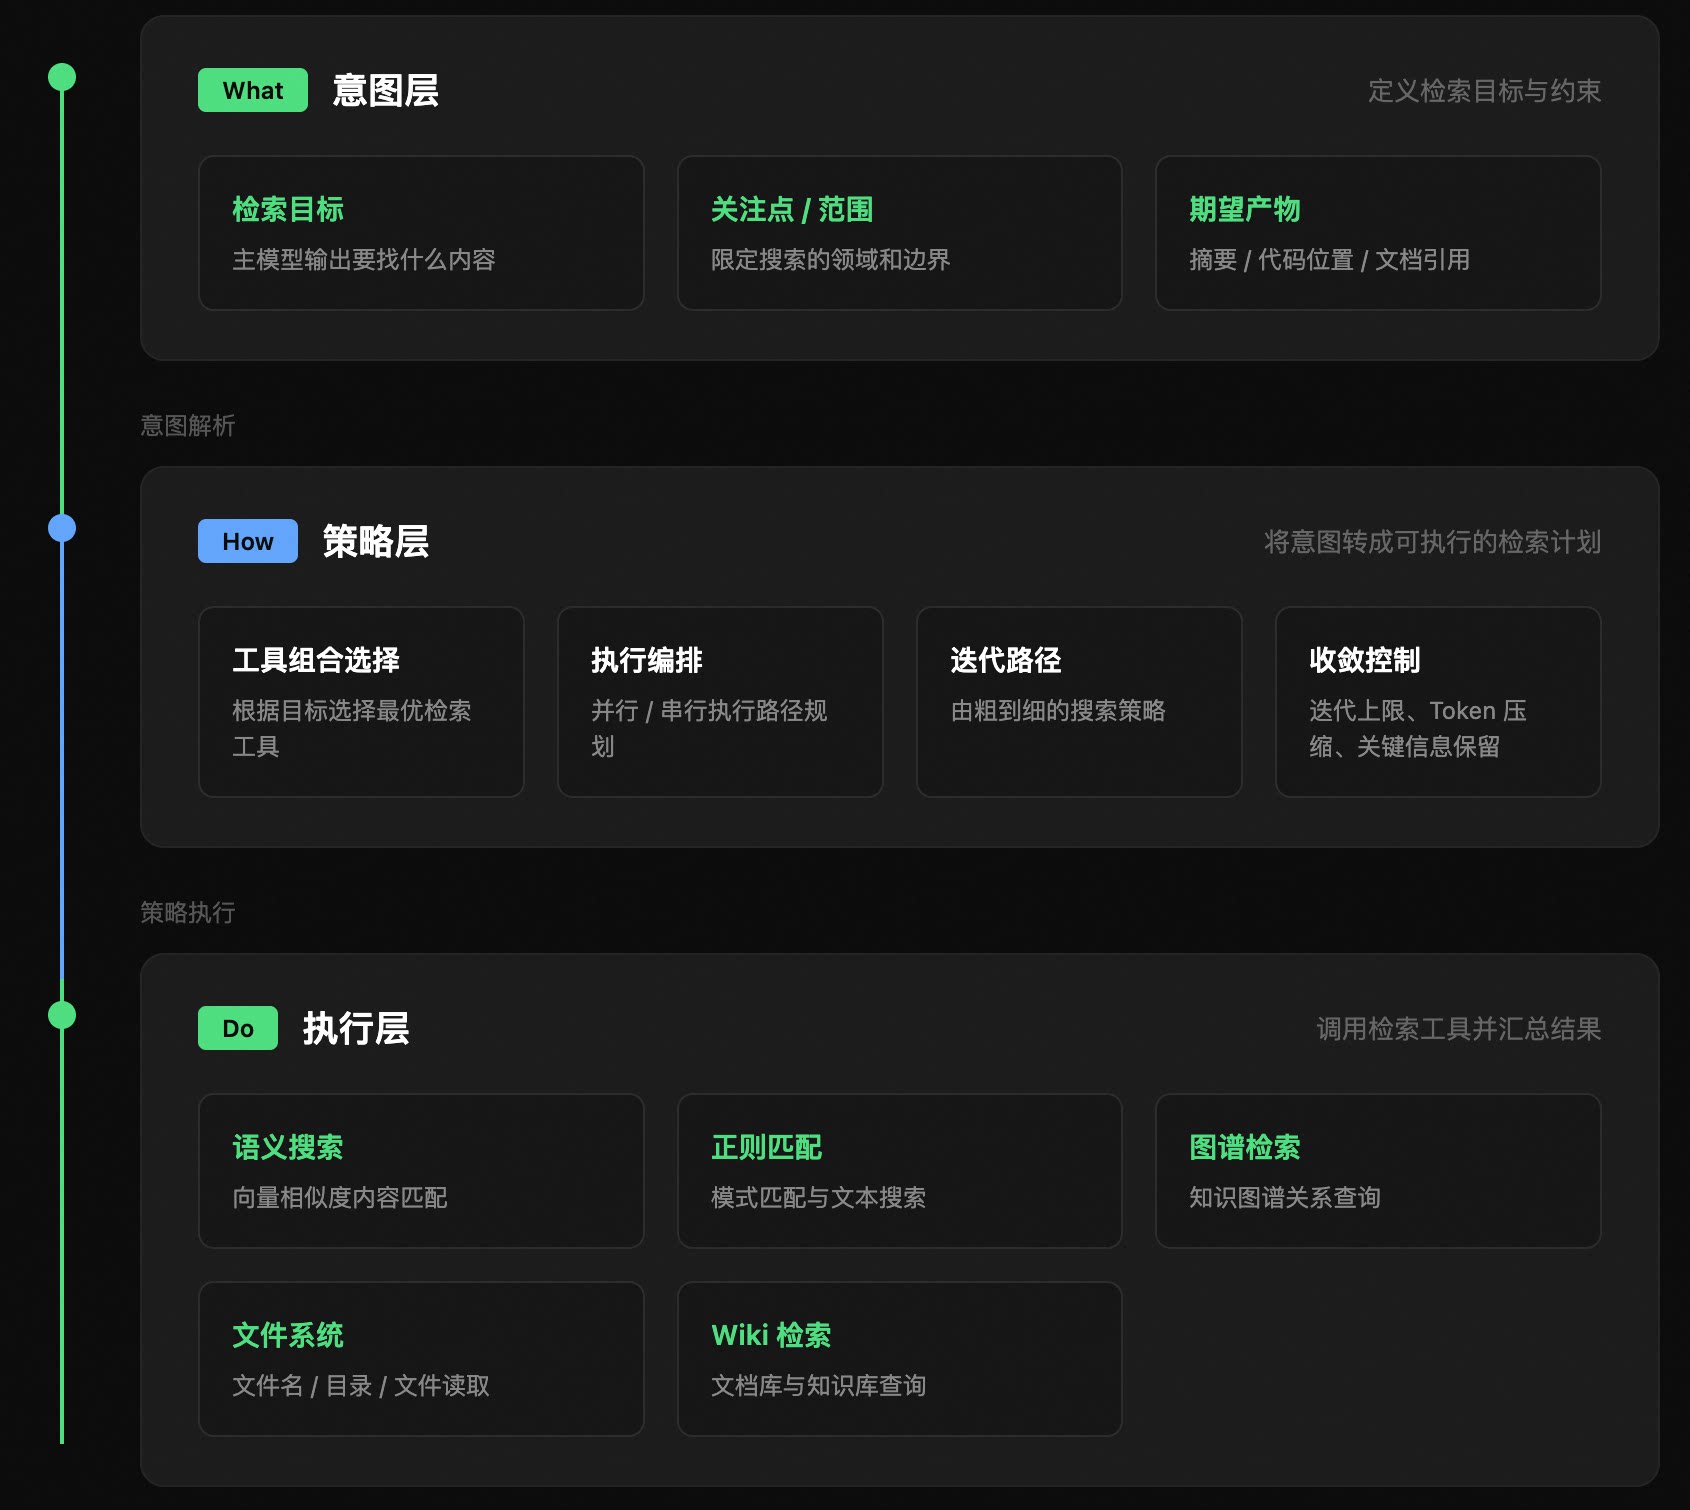
整体架构(三层)
- 意图层(What):主模型给检索目标/范围/产物形式,不指定步骤与工具。
- 策略层(How):转成可执行计划(工具组合、并行/串行、由粗到细),并控制迭代与压缩。
- 执行层(Do):调用语义/正则/图谱/文件/目录/读取/Wiki 等工具,输出摘要 + 文件路径与行号索引。
多路混合检索
Search Agent 被设计为只负责检索,不参与推理与生成,因此其上下文更“干净”、目标更单一:围绕“找到信息”展开。这使得我们可以在 prompt 中加入更强的检索指令与高质量工具调用轨迹(tool traces),让每一步搜索更可控、可复用、可评估。
- 语义搜索:理解自然语言意图,做模糊匹配与概念检索
适用:概念性搜索、初始探索、同义表达/命名不一致场景 - 图谱搜索:沿调用链、继承关系、引用关系做图遍历
适用:追踪函数调用链、定位影响面、理解类继承与依赖结构 - 正则匹配:按精确模式在全代码库中搜索
适用:错误信息定位、特定配置项/常量/关键字的精准落点 - 文件检索:按文件名/路径模式查找
适用:快速定位入口文件、配置文件、模块边界 - 目录浏览:查看项目结构与目录层级
适用:理解工程布局、识别模块划分与代码组织方式 - 文件读取:读取已定位文件的具体内容
适用:精读实现细节、确认参数/边界条件/真实调用方式 - Wiki 搜索:检索项目文档、开发规范、架构说明
适用:补齐背景知识、对齐术语、理解约定与整体架构
效果数据
效果演示
如下示例case的演示说明,在同等基座模型下,引入 Search Agent 实现了检索职责的解耦。主模型通过异步分发任务,直接获取精炼后的检索结果进行代码生成。该方案显著压缩了推理轮次,使主模型 Token 消耗降低 30.2%。
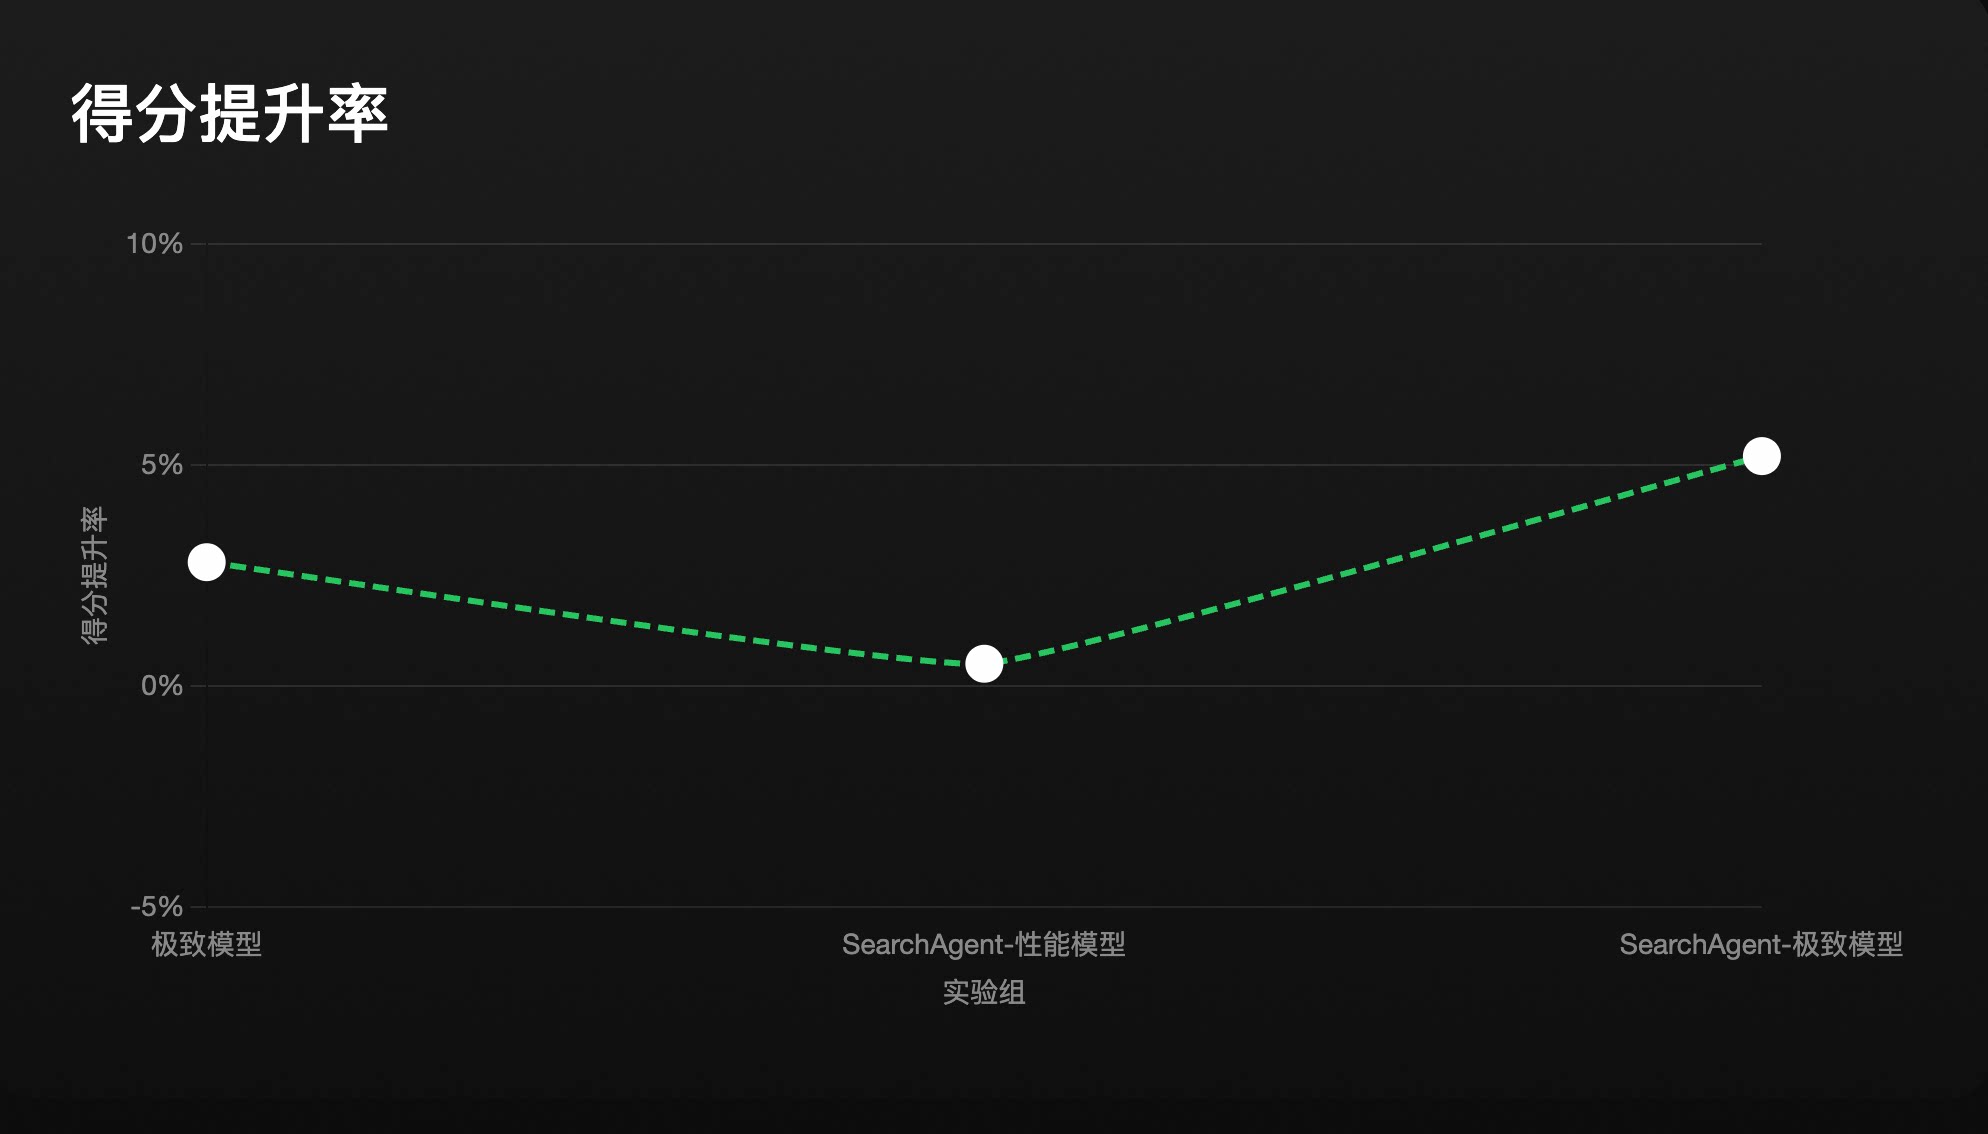
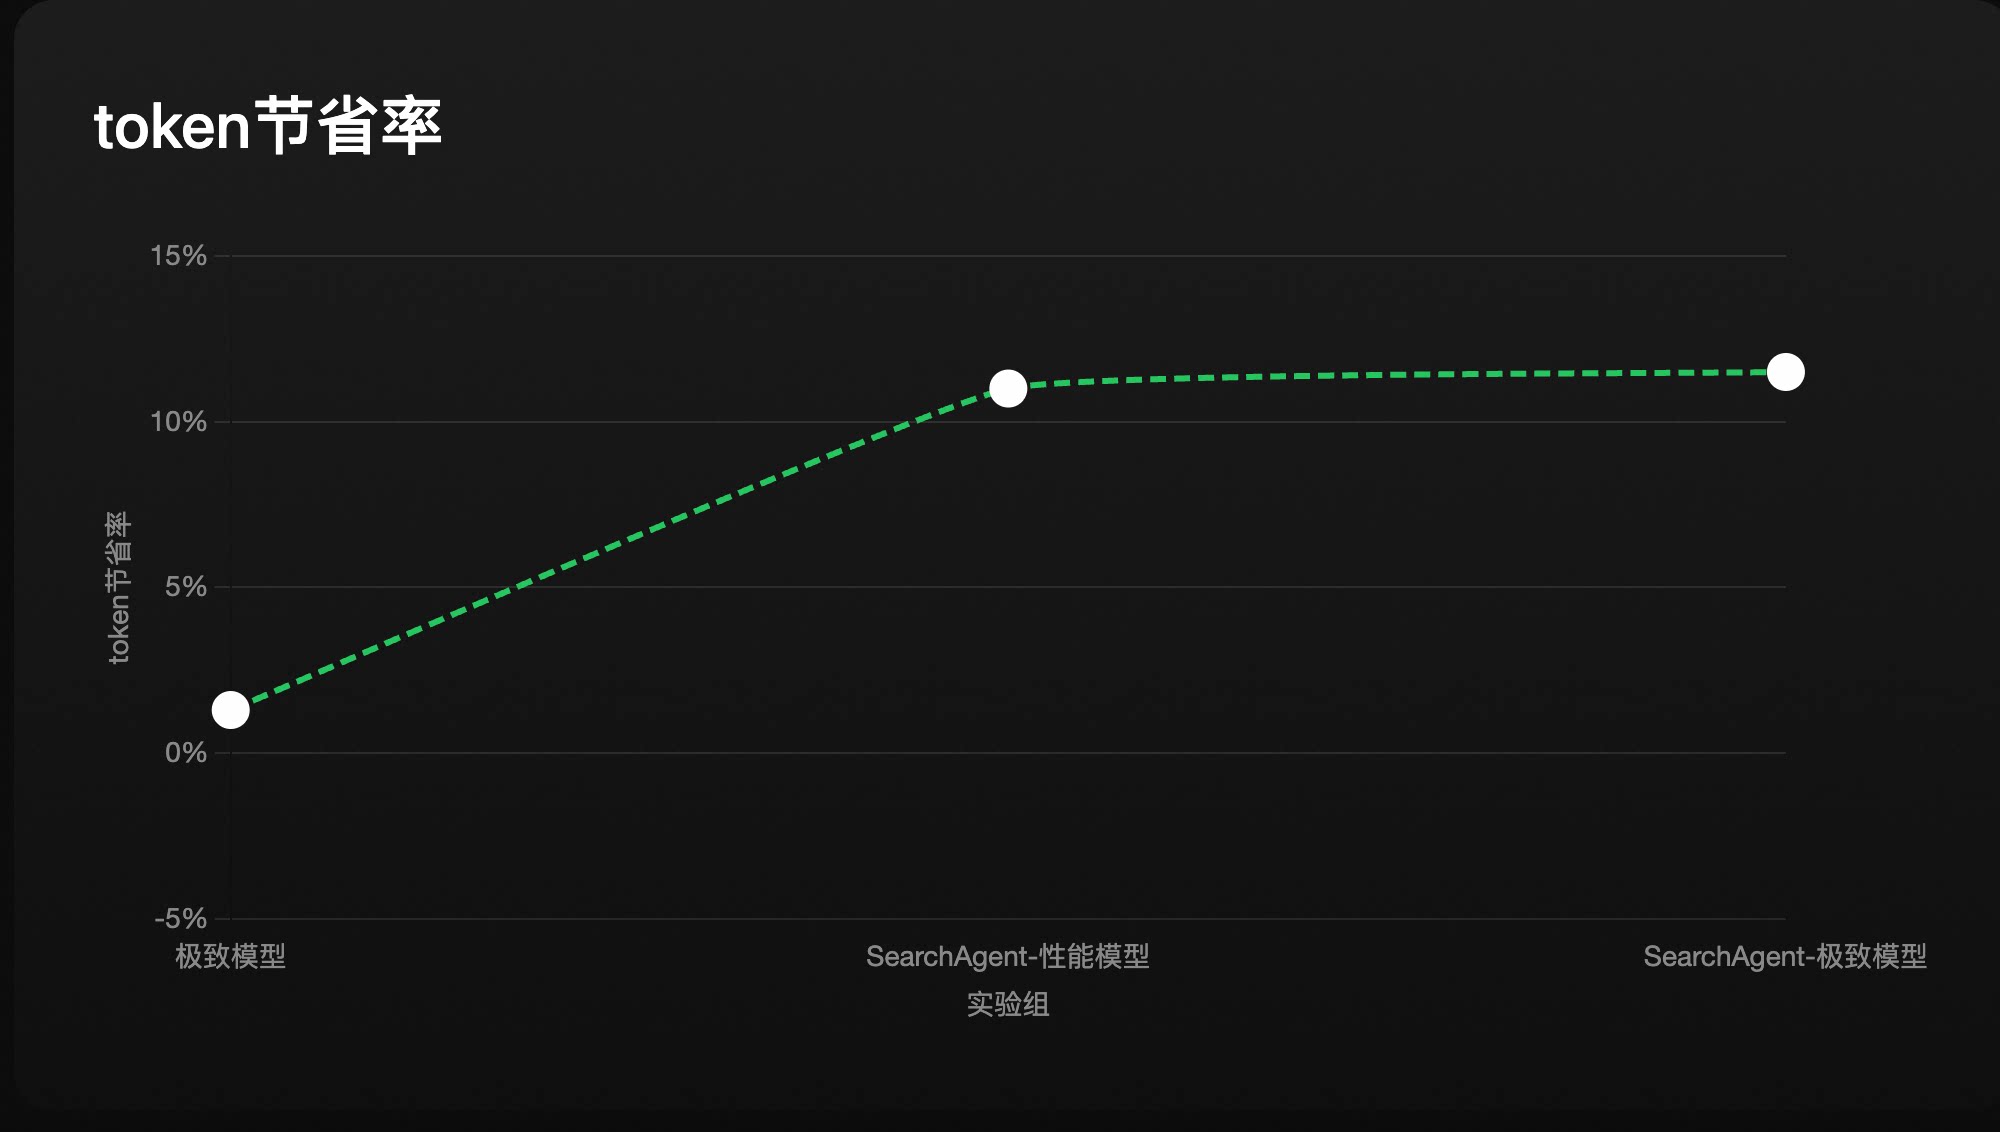
线下评测
- 线下测评集:Agent Bench(45 个真实任务,多语言):
- 极致模型:分数提升 2.3%,主模型 Token消耗降低 10.4%
- 性能模型:分数提升 0.5%,主模型 Token消耗降低 11%
线上AB实验
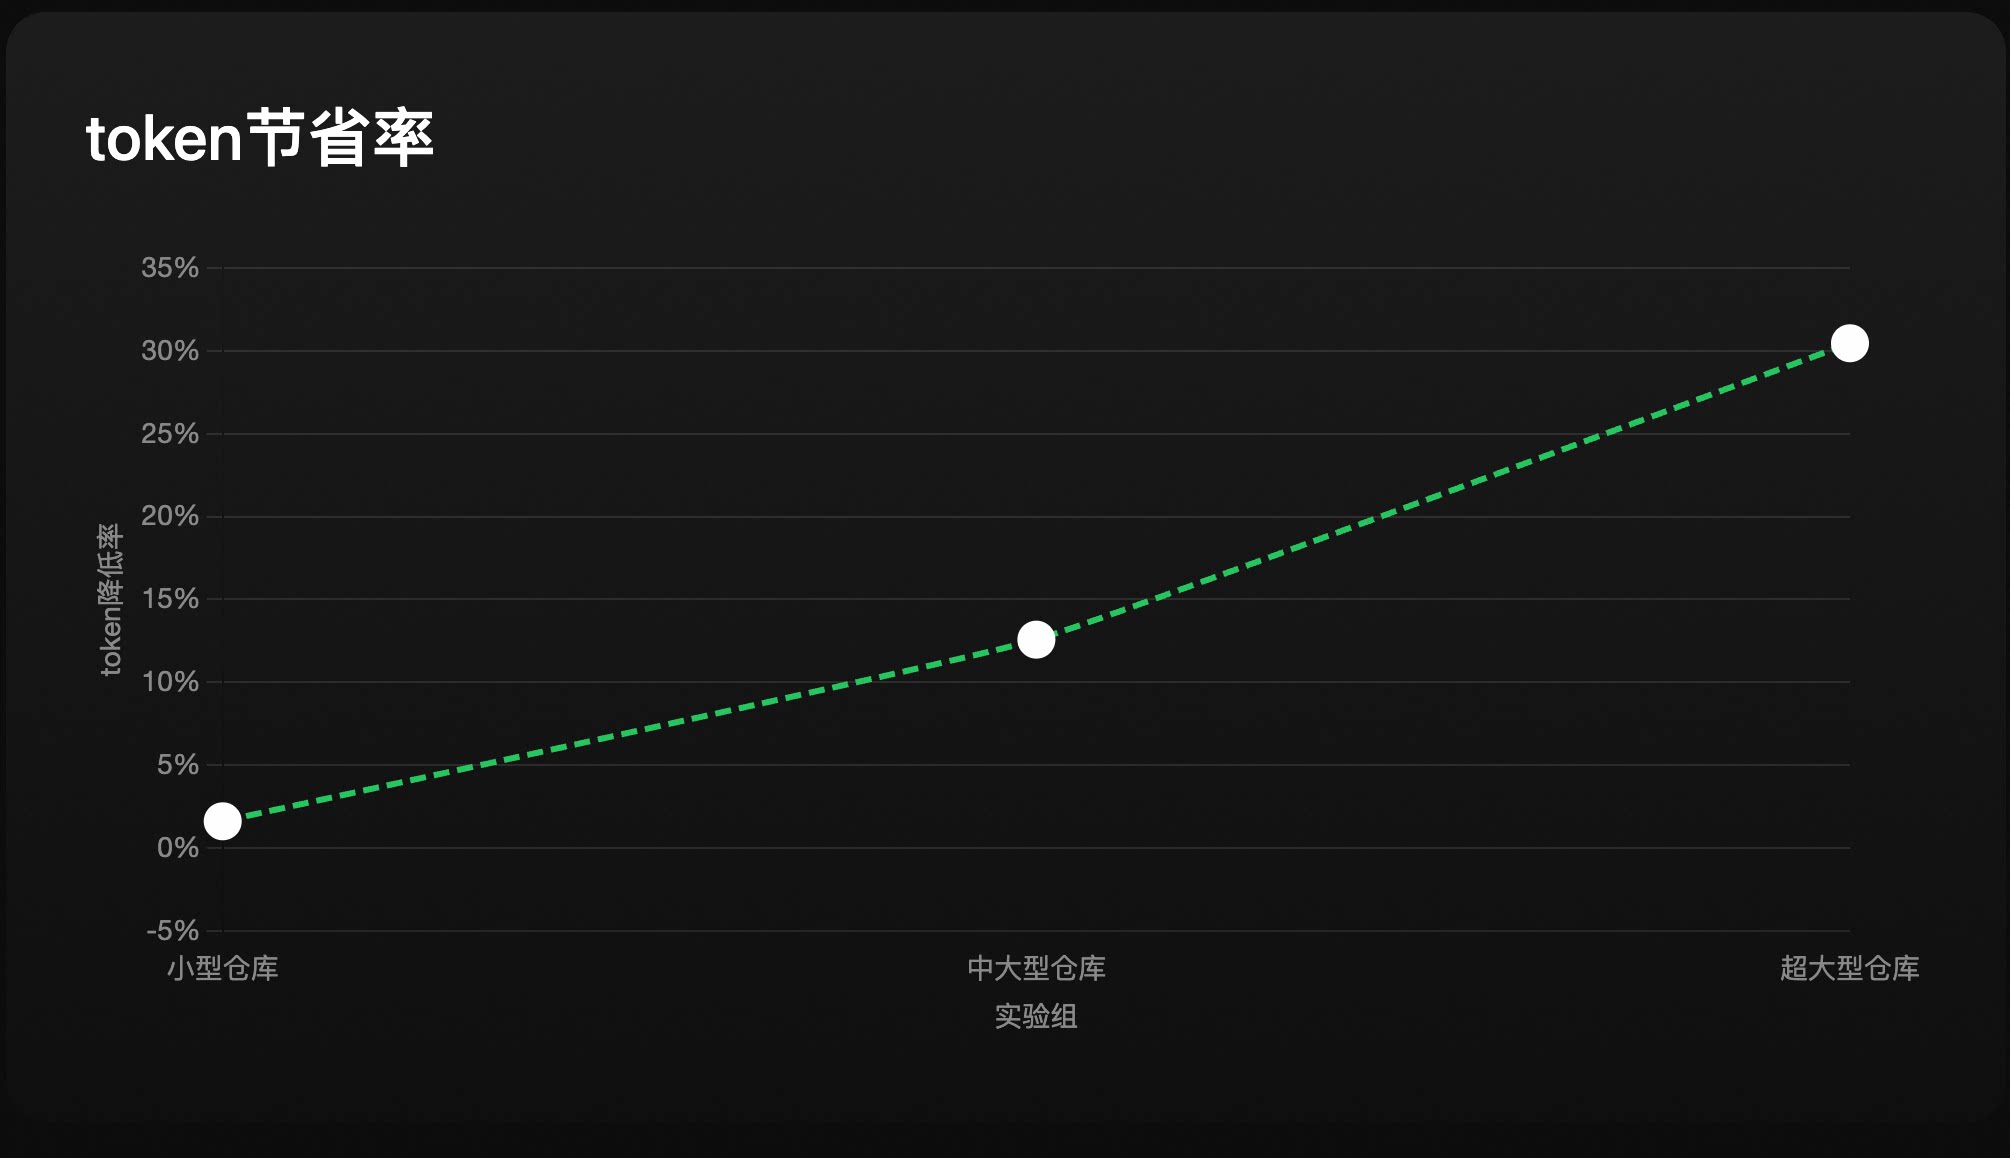
针对需要深度工程上下文感知能力的复杂任务,我们上线了 Search Agent 并进行了 A/B 对照实验。实验数据表明,该方案在降低主模型 Token 推理开销方面表现优异,且优化幅度随代码仓库规模的扩大而显著递增:
- 测评数据:
- 小型仓库 (0-1k 文件): Token 消耗降低 1.61%;
- 中大型仓库 (1k-100k 文件): Token 消耗降低 12.57%;
- 超大型仓库 (100k+ 文件): Token 消耗显著降低 30.46%。