
不是把通用知识管理工具搬到代码场景,而是从第一行代码起就为软件工程而生,并且能在企业里真实落地、方便集成。
返回
AI 编码助手已经很强了,它不认识你的代码,也不记得你的项目。再大的通用模型,如果对你的项目一无所知,就永远无法真正为你服务。
个人开发者的困境——每天协作,却每天从零开始
Andrej Karpathy 提出了 LLM Wiki 的理念,随后 GBrain 把它做成了开源产品。他们指出了一个有参考的方向。
卡帕西的洞察很关键:人类为什么会放弃维护 Wiki?不是不会写,而是维护的"记账成本"——更新交叉引用、保持摘要时效、标注矛盾——增长得比知识本身的价值更快。但 LLM 不会累,它的维护成本趋近于零。
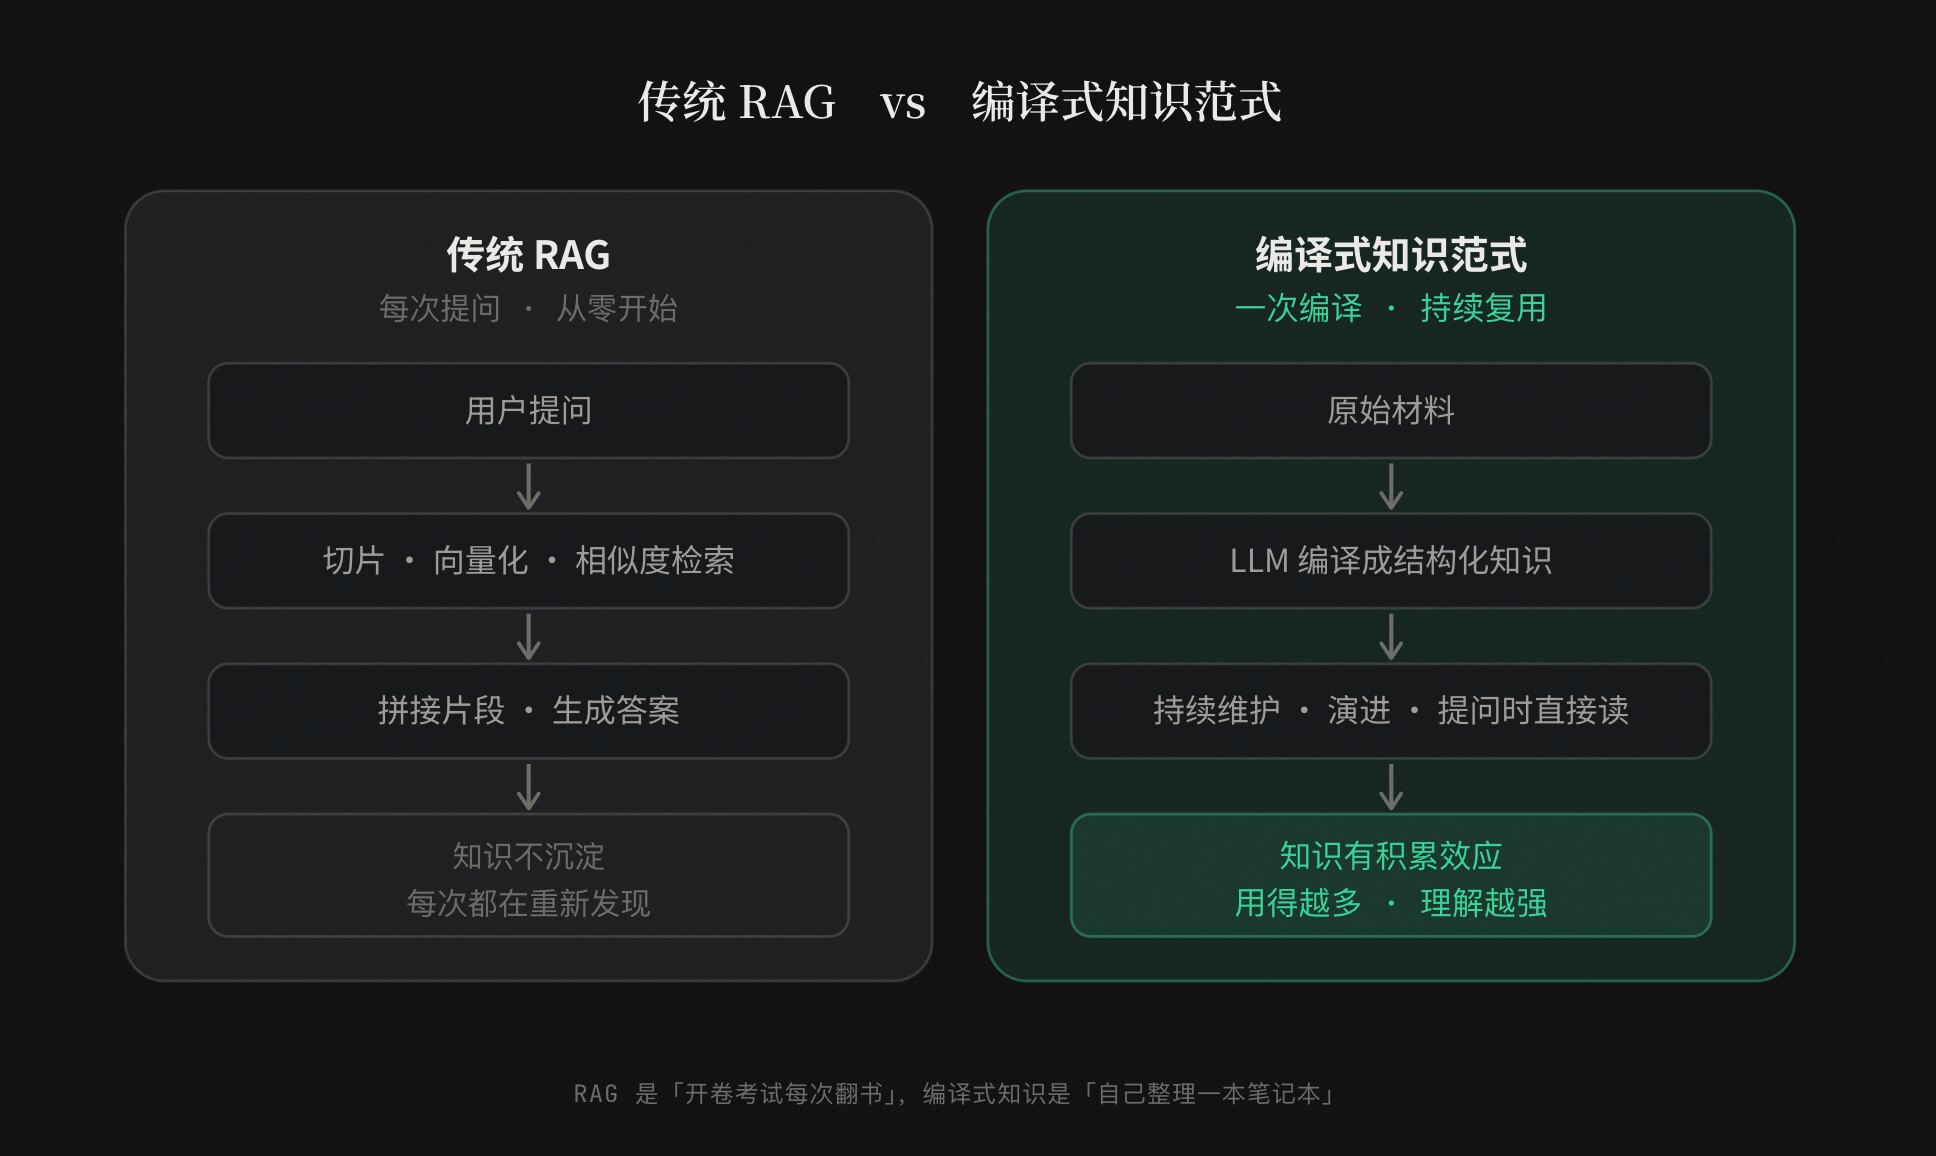
于是有了一个新范式:把知识"编译"一次,然后持续复用和增长。不是每次使用时临时拼凑,而是让知识像代码库一样被沉淀、被迭代。这和传统 RAG 形成了鲜明对比——RAG 每次提问都从零开始,知识不沉淀;编译式知识范式则让知识有了"积累效应",用得越多、越丰富、理解越强。
 LM Wiki 和 GBrain 都是通用知识工具,它们在通用知识领域形成了范式,却没有针对软件工程这个最适合、也最难的场景做到极致。Qoder 知识引擎 2.0 在软件工程的知识领域做到了业界领先。
Qoder 知识引擎 2.0 围绕"编译式知识"这个理念,结合软件工程的真实场景,给出了四个层面的答案:怎么凝练知识、怎么让知识活着、能力栈怎么搭、企业怎么真正用起来。
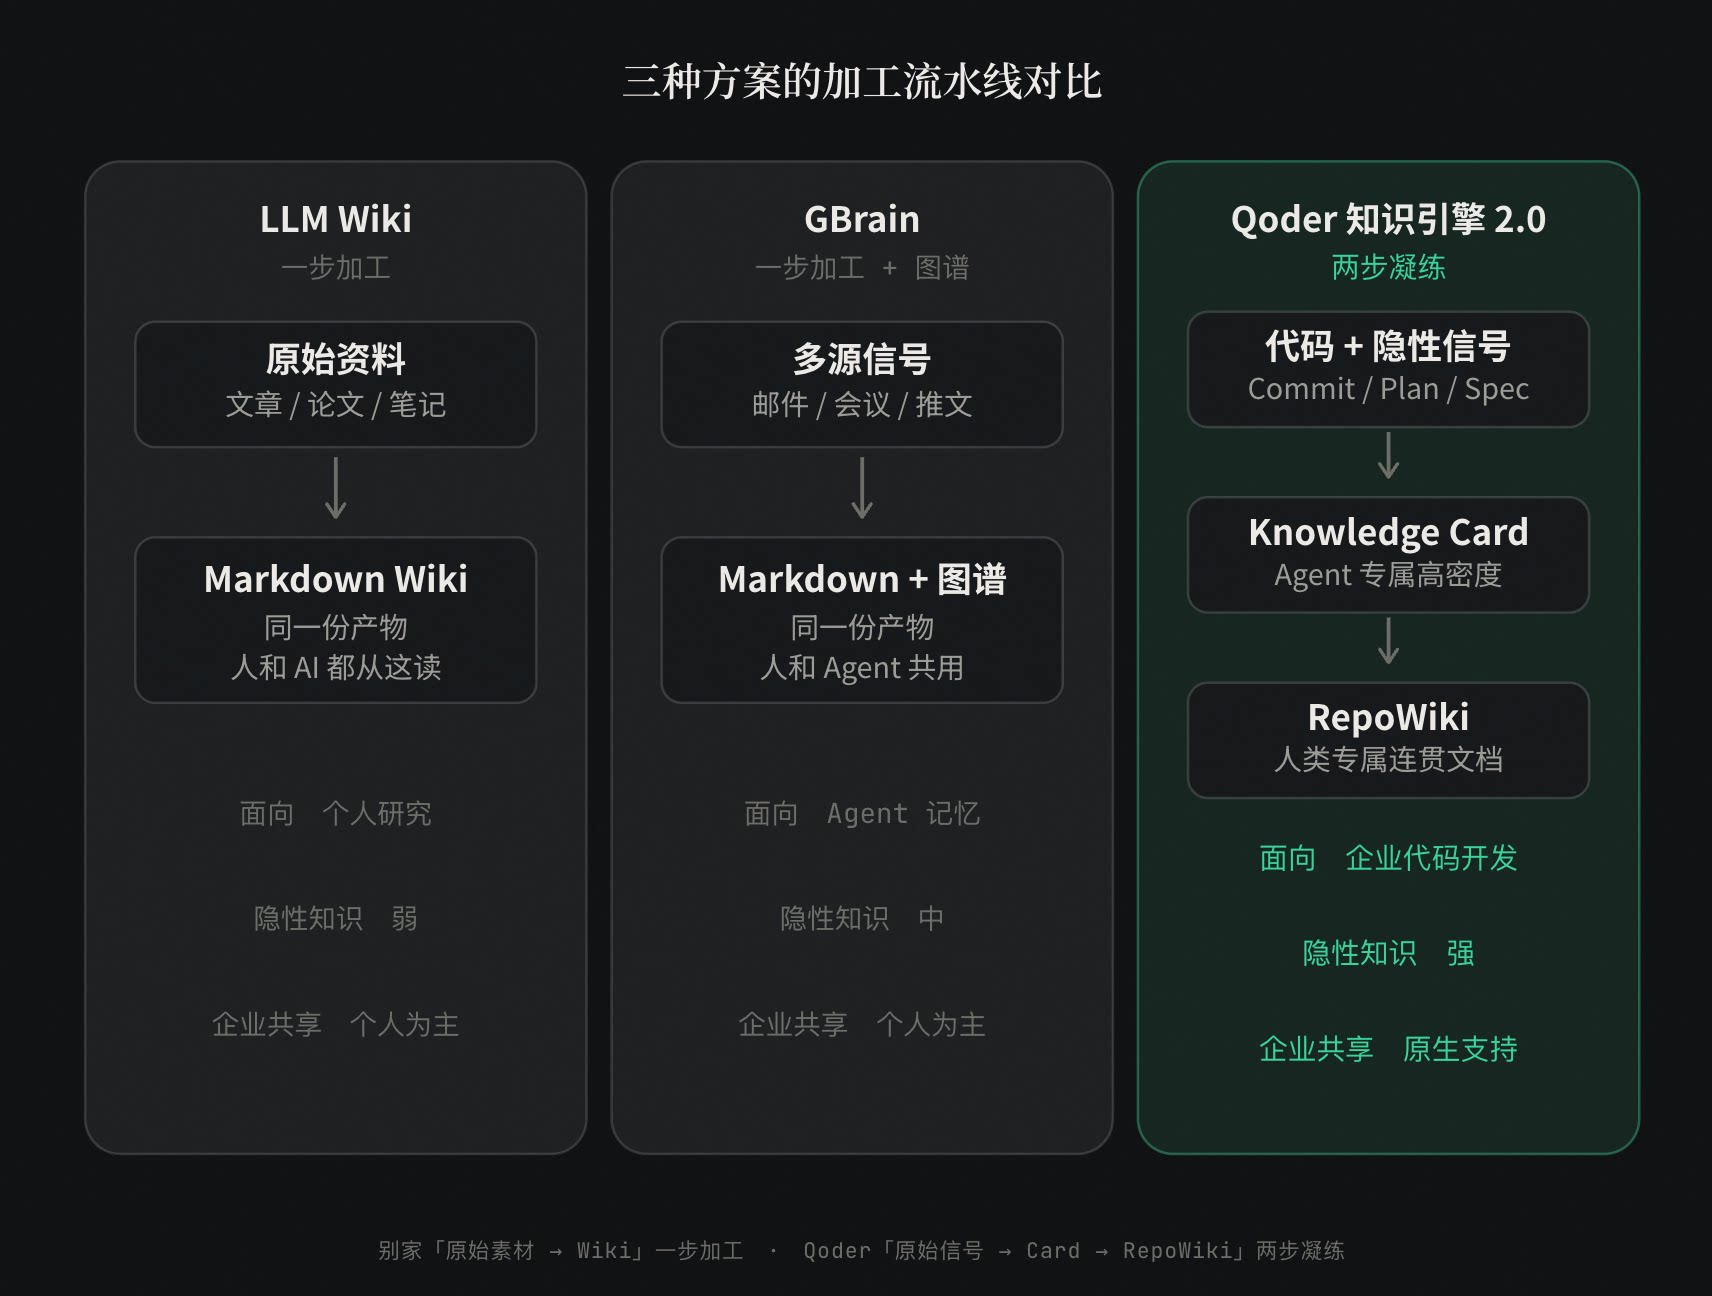
编译式知识有个绕不开的矛盾:把原始材料直接编译成一份 Wiki,人和 AI 读的是同一份产物。但 Agent 想要的是高密度、结构化的信号,人想要的是连贯、易读的文章——一份产物服务两个需求,必然顾此失彼。
Qoder 的答案是两步凝练:原始信号先编译成 Knowledge Card(给 Agent 用),再基于 Knowledge Card 凝练出 RepoWiki(给人看)。这正是禅宗"看山三境"的工程化表达——看山是山、看山不是山、看山还是山。
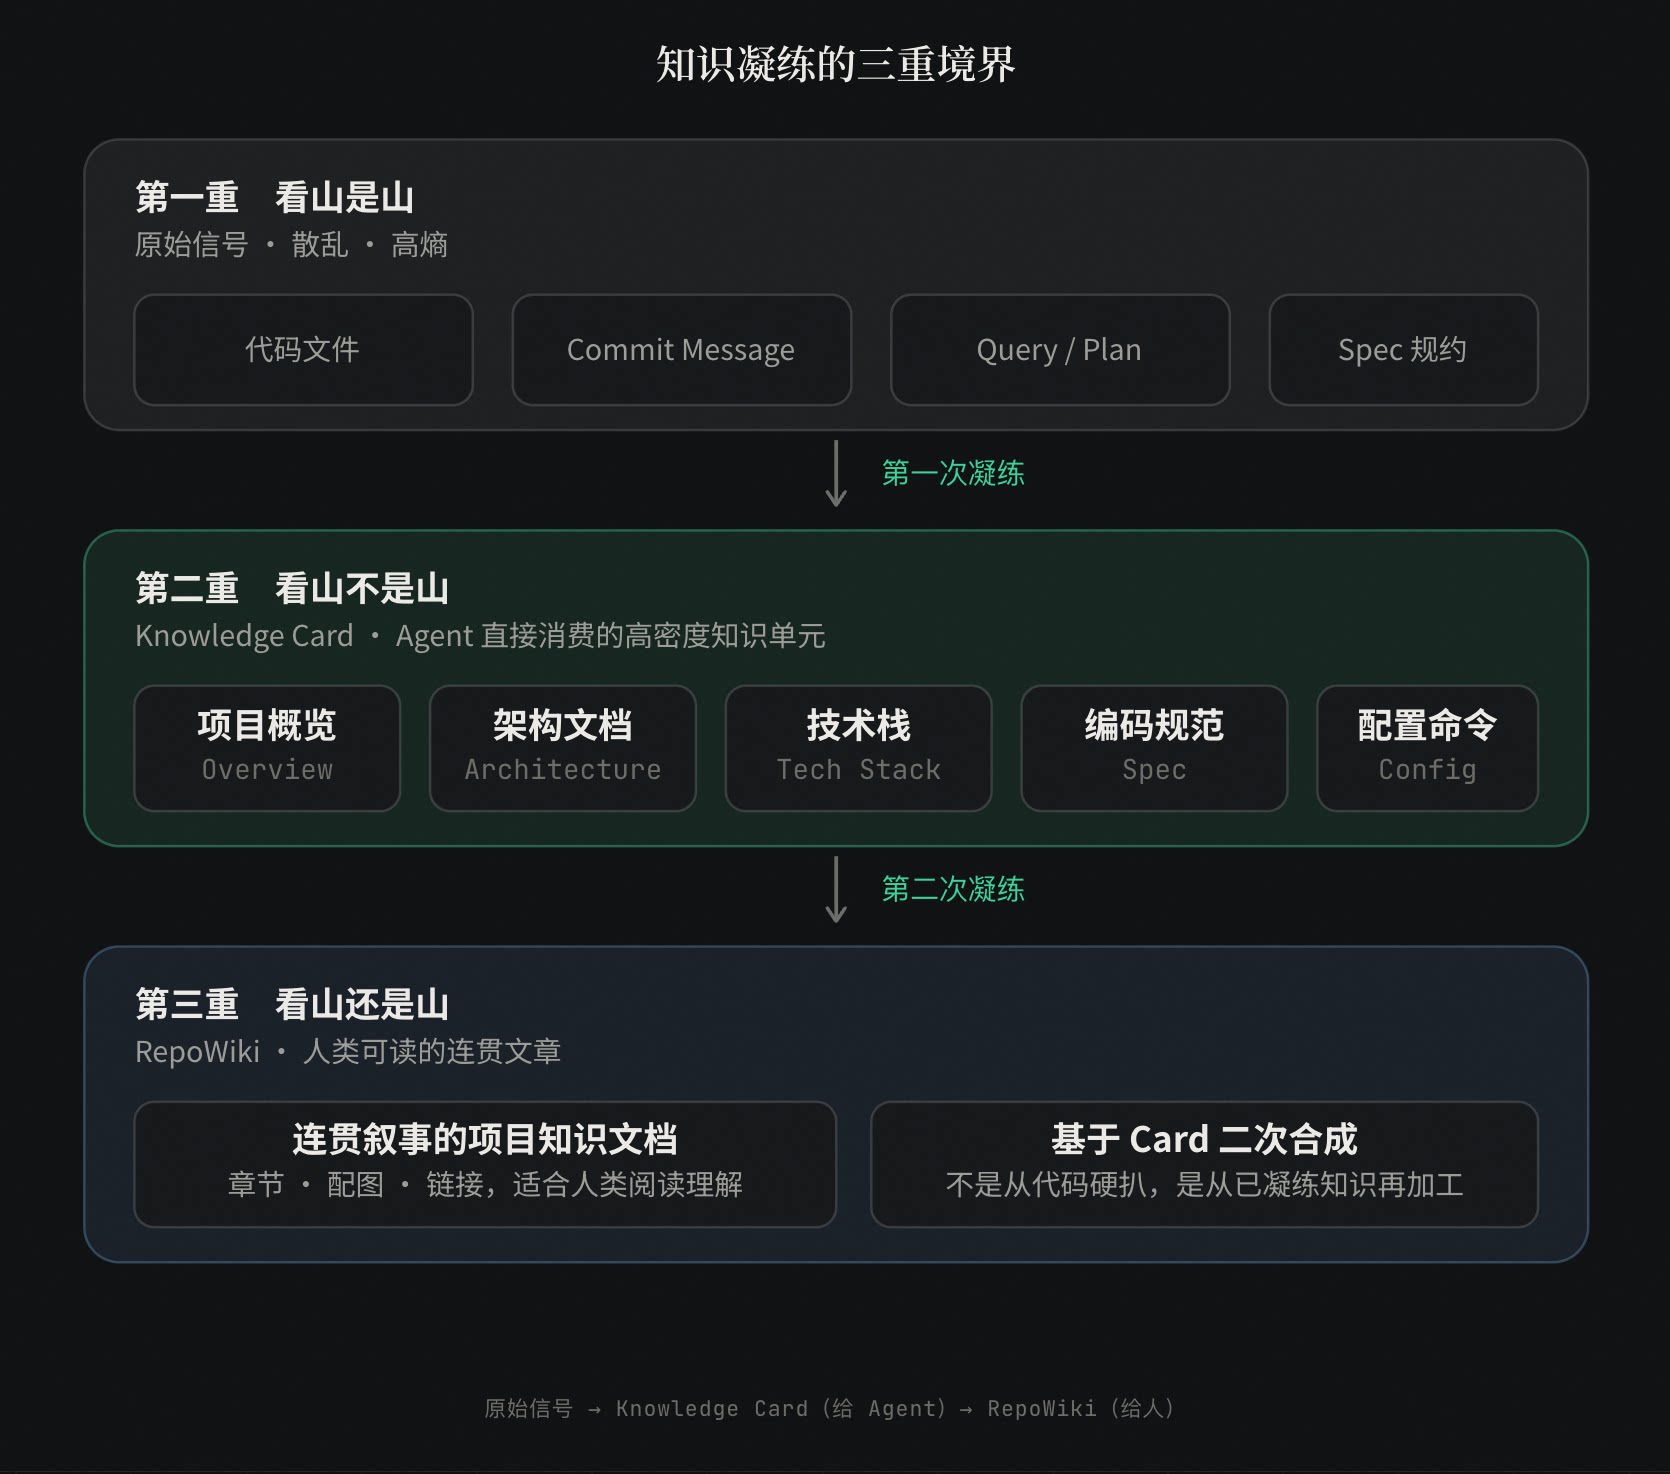 为什么这一步分层很重要?Agent 要的是密度——Knowledge Card 结构化、单一职责、可定位,检索一击即中;人要的是连贯——RepoWiki 叙事性、串起整个系统;而隐性知识只能从人来——设计意图、踩坑历史、规约约束,代码里看不到,只能从 commit message 和对话里的 plan/spec 提取,Knowledge Card 正是它们的最佳载体。
知识库最大的敌人是"过时"。Qoder 用两个相互独立、又相互喂养的飞轮,让知识库随开发活动实时生长——不需要任何人专门去维护。
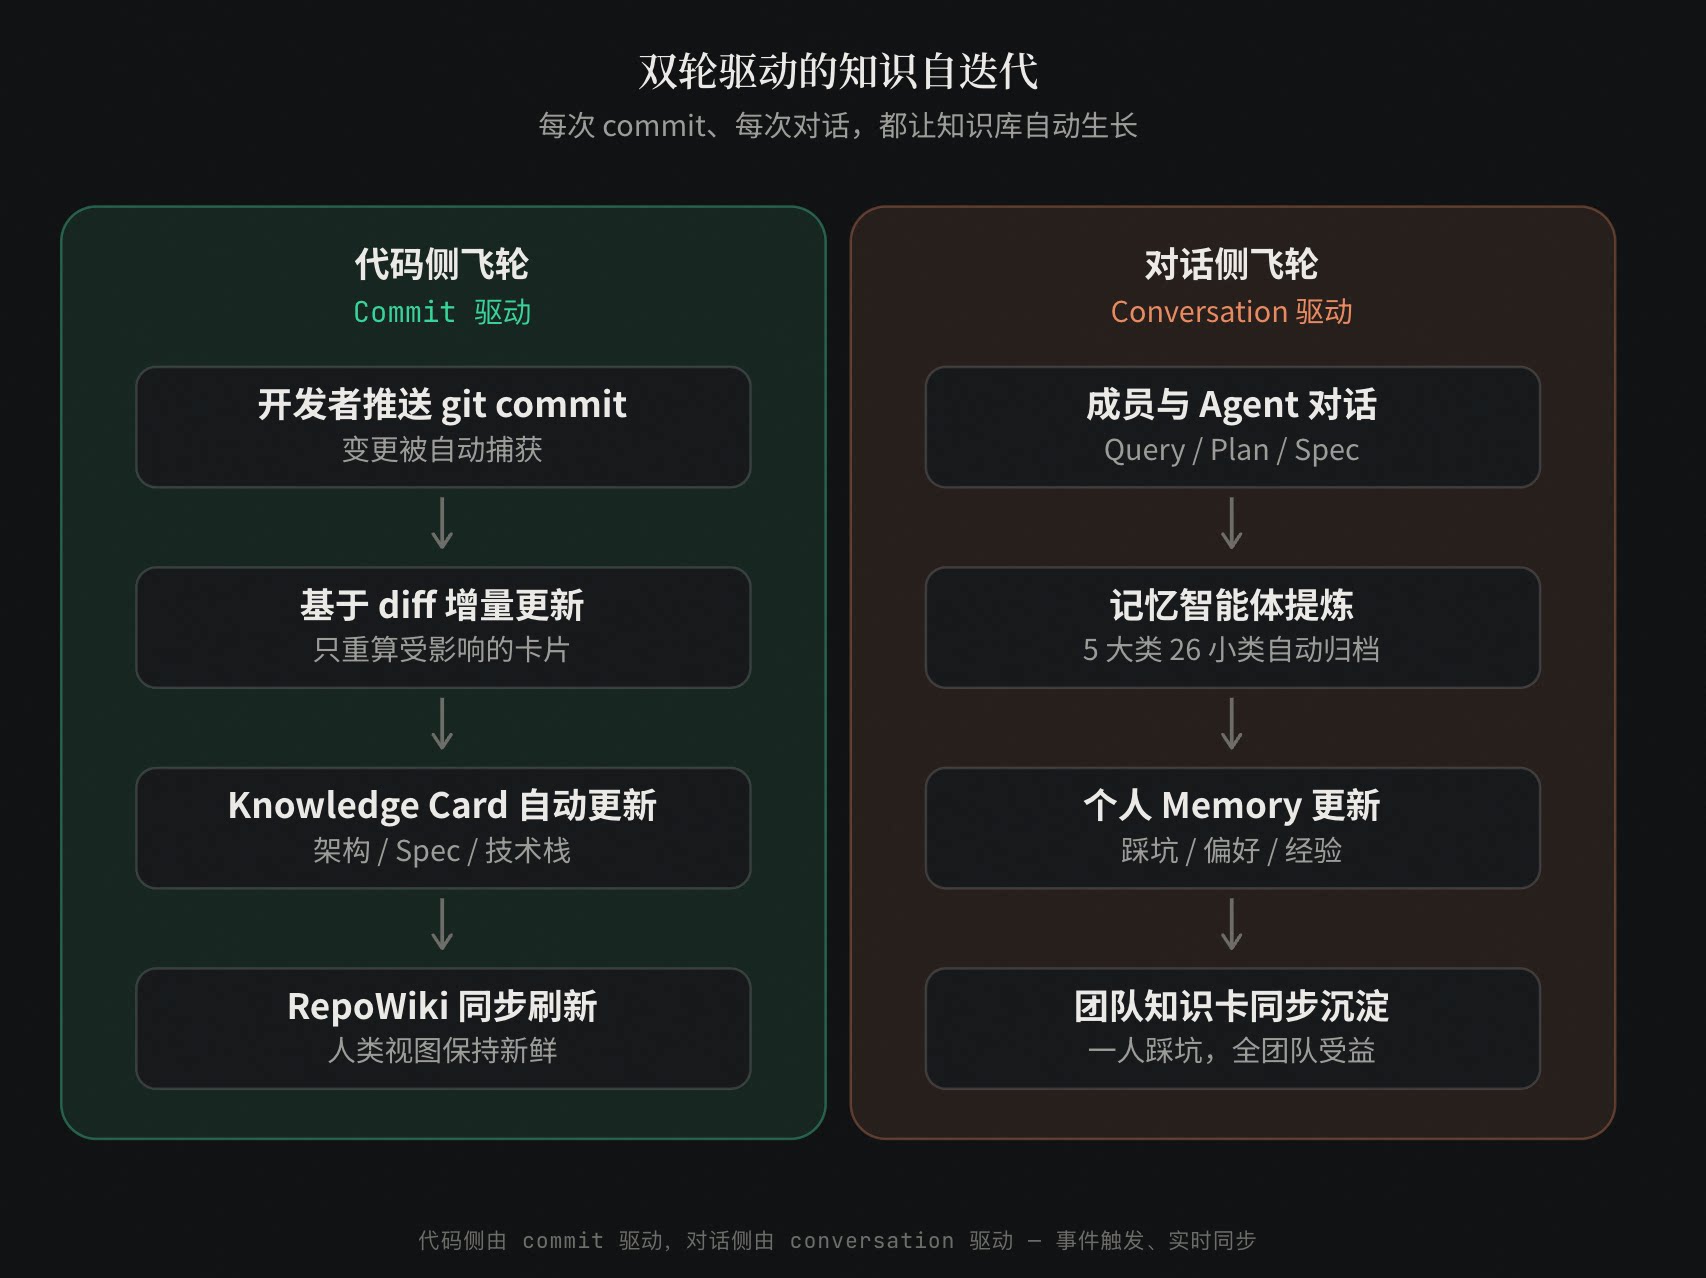 两个飞轮各管一侧:
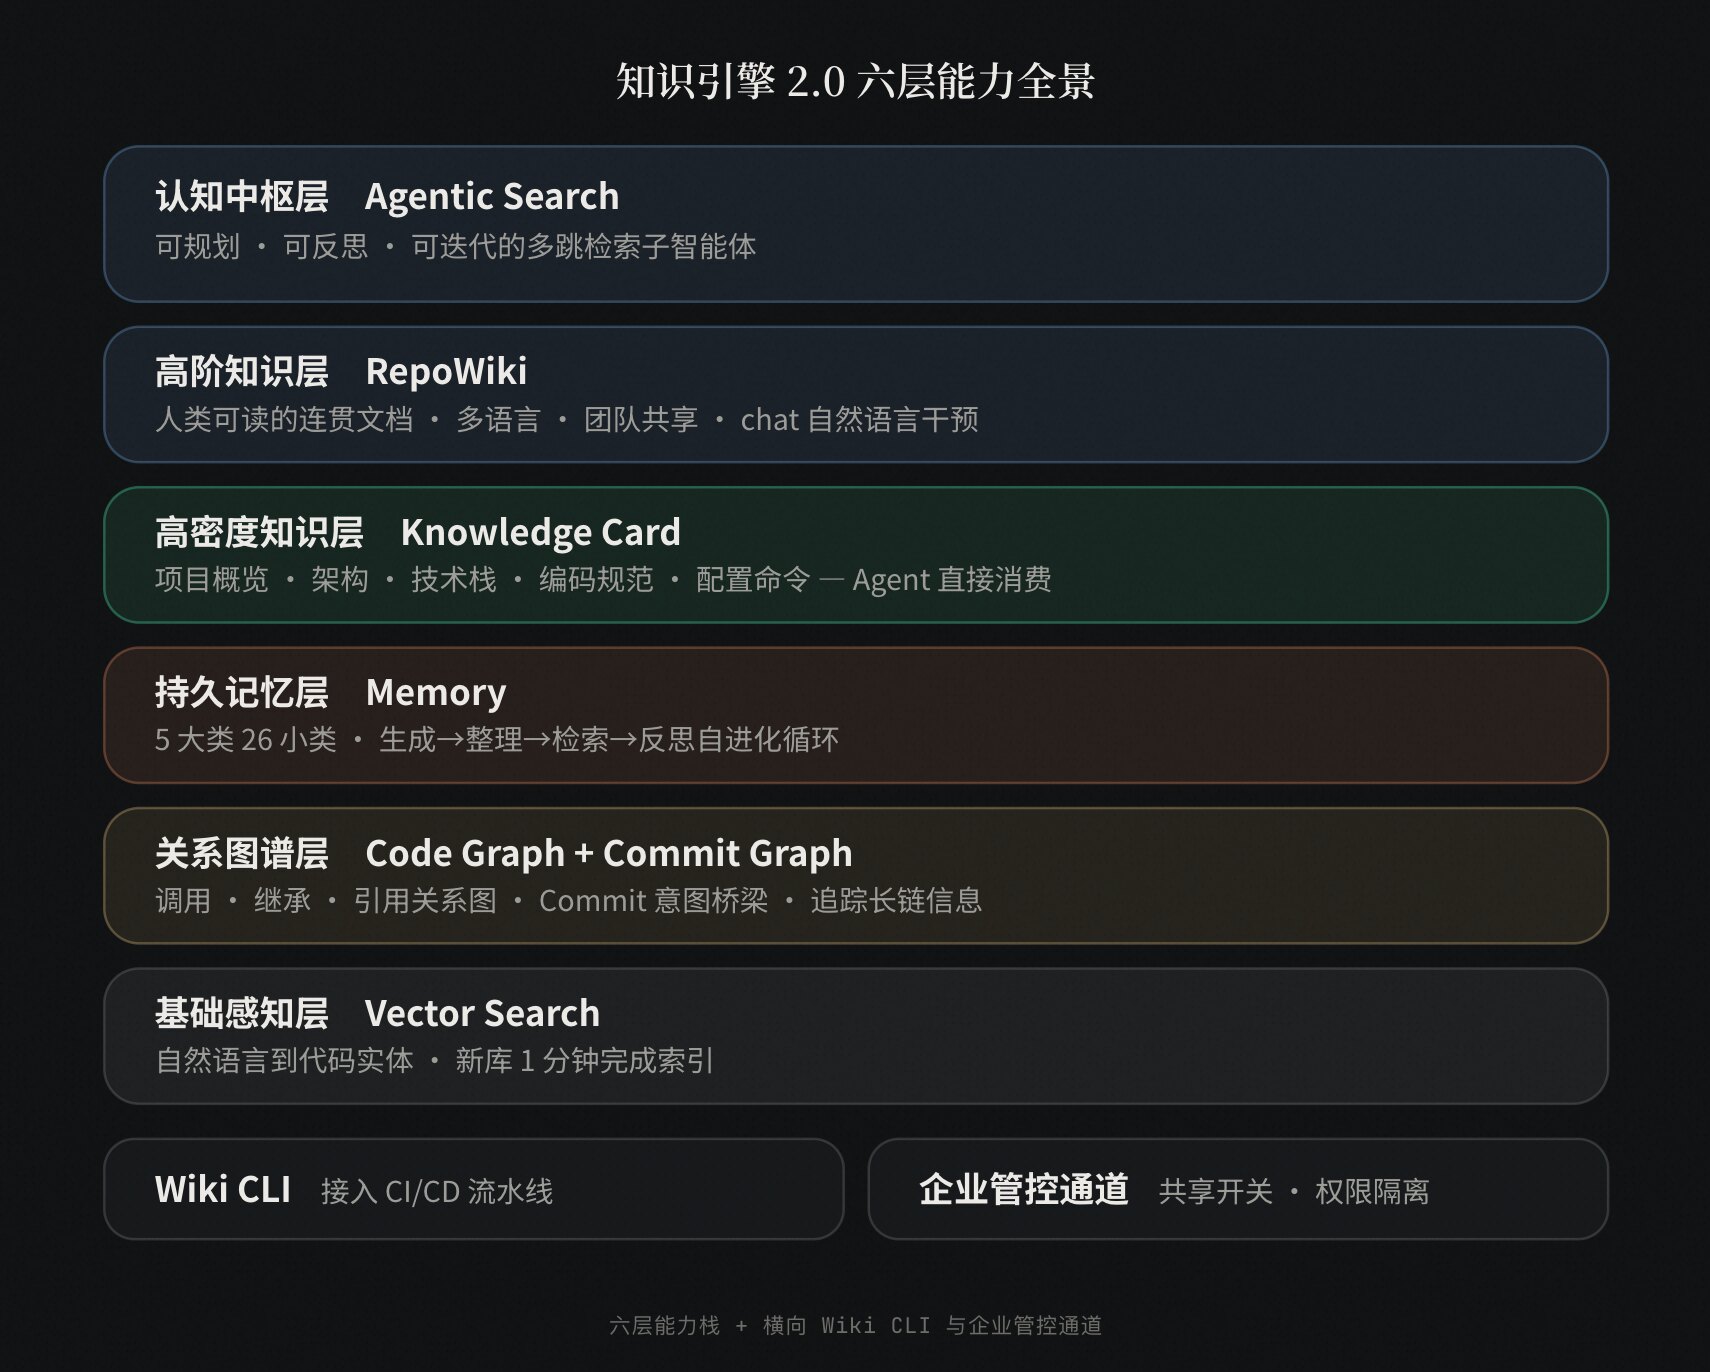
把上面的方法落到系统里,是一套六层能力栈——从底层向量检索,到顶层的 Agentic Search 认知中枢,每一层各司其职。
企业用知识引擎有三道现实门槛:代码安全不能出域、多人协作不能冲突、流程必须能进流水线。Qoder 知识引擎 2.0 对这三道门槛各有答案。
代码不出域——客户端生成
知识在客户端本地生成,服务端永远拿不到源代码,只接收结构化知识卡。企业代码资产零外泄风险。
协作不冲突——版本锁裁决
服务端按 repo + branch 维度加上传锁,再用 commit 版本裁决,旧版本不会覆盖新版本。
流程能集成——Wiki CLI + 共享
Wiki CLI 无需 IDE 批量生成、接入 CI/CD;团队通过 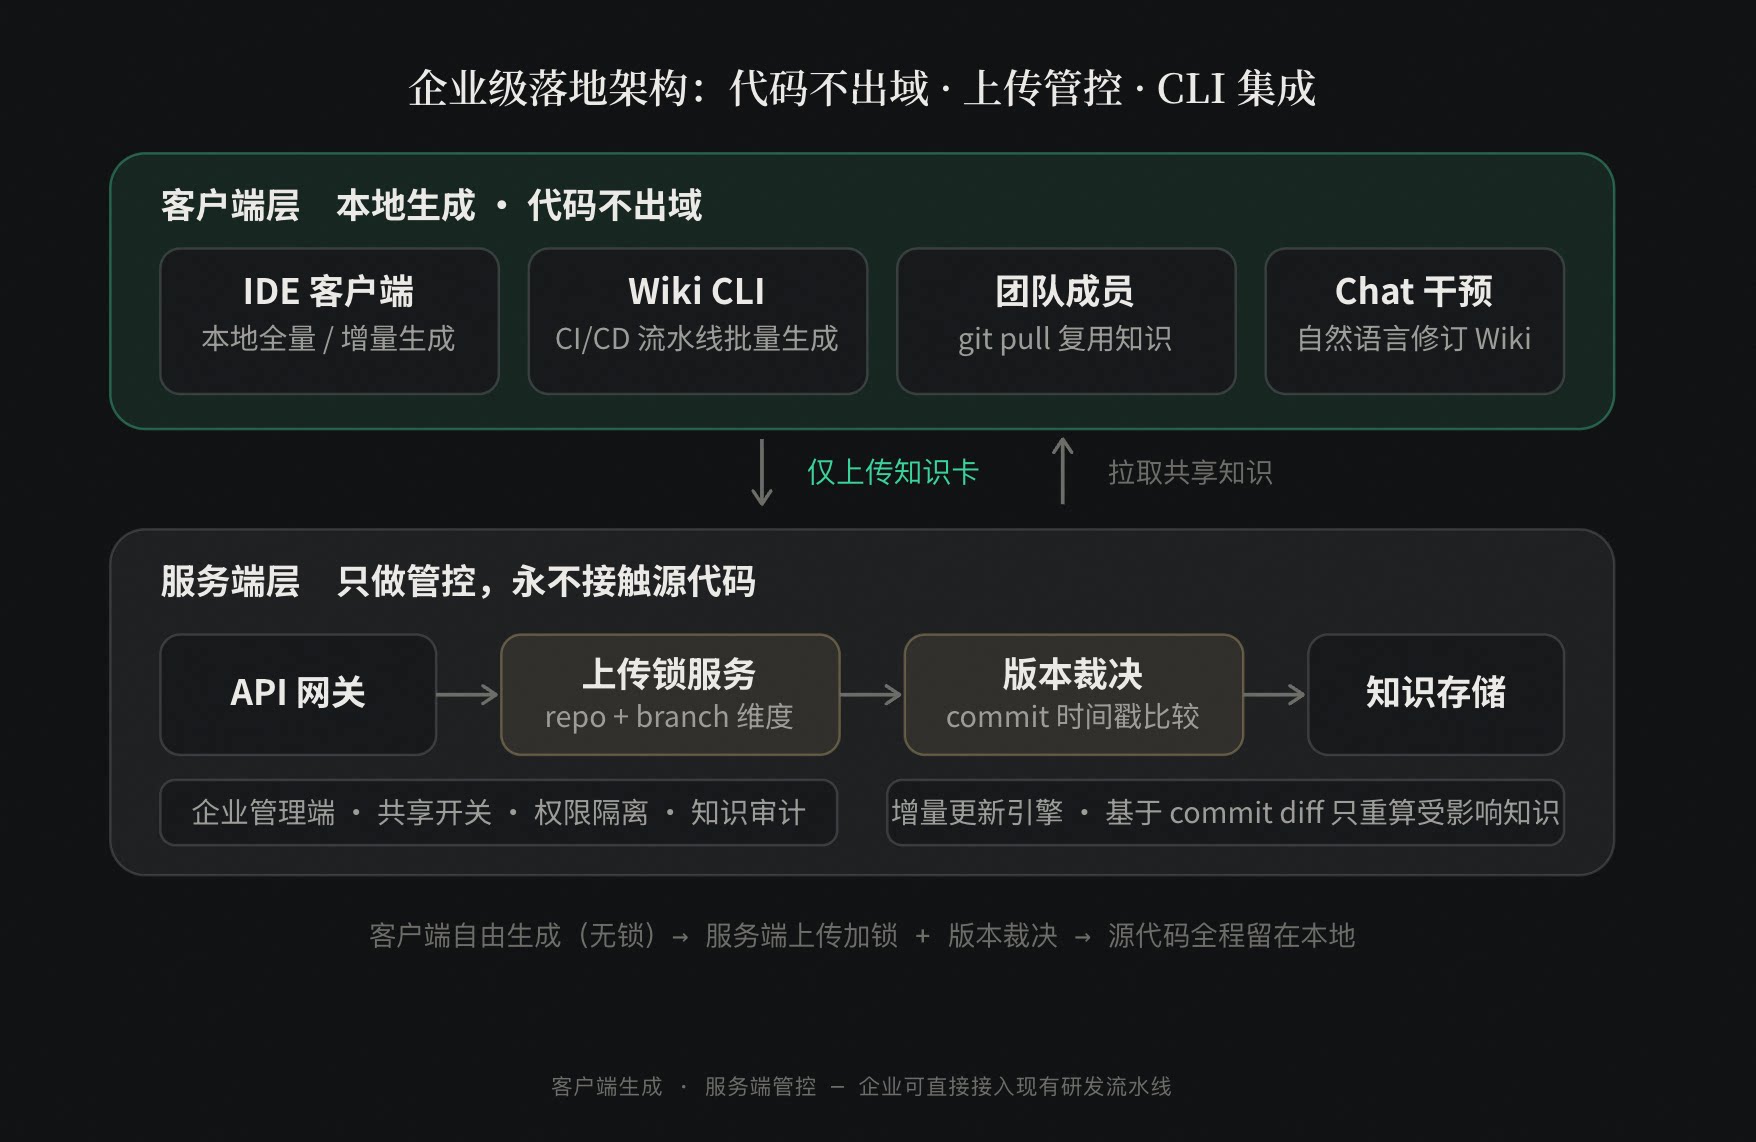
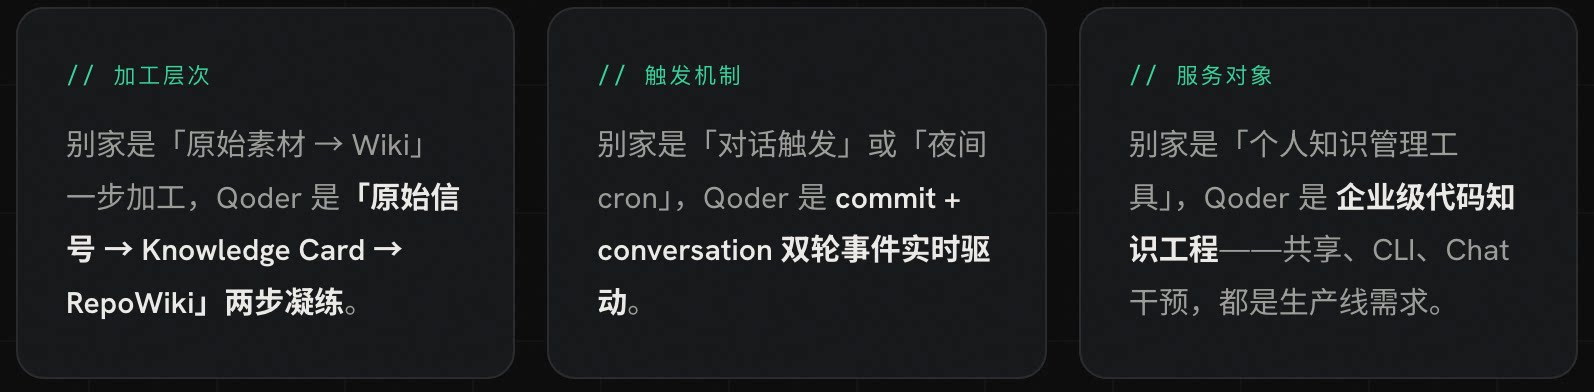
业界主流的 LLM Wiki 与 GBrain 都是优秀的通用知识管理工具。但 Qoder 知识引擎 2.0 在四个维度上做到了软件工程领域的业界领先。
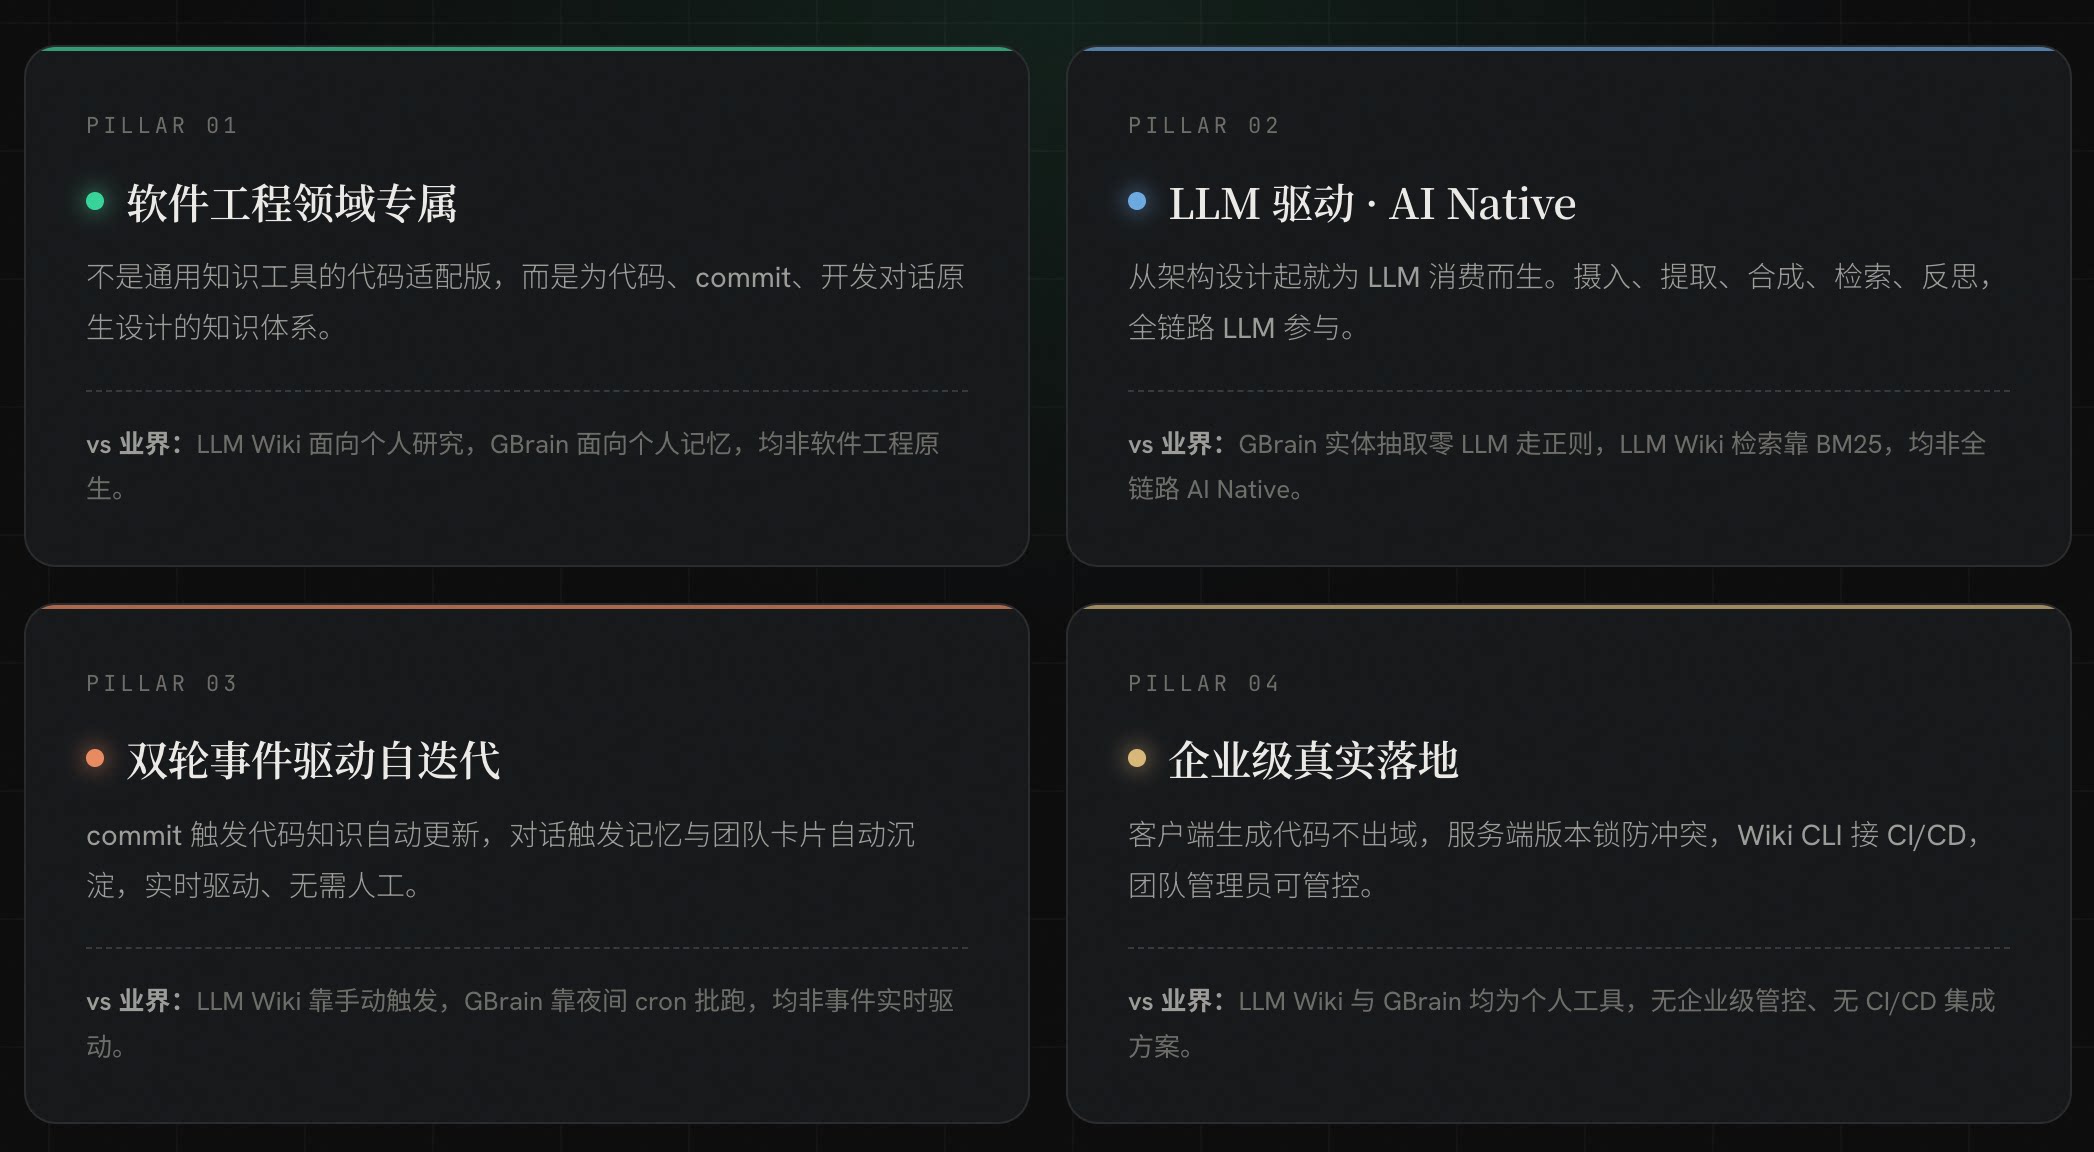 最直观的差异,是知识的加工层次。LLM Wiki 和 GBrain 都是"一步加工"——原始材料直接成 Wiki;Qoder 是"两步凝练"——原始信号先成 Knowledge Card,再成 RepoWiki。
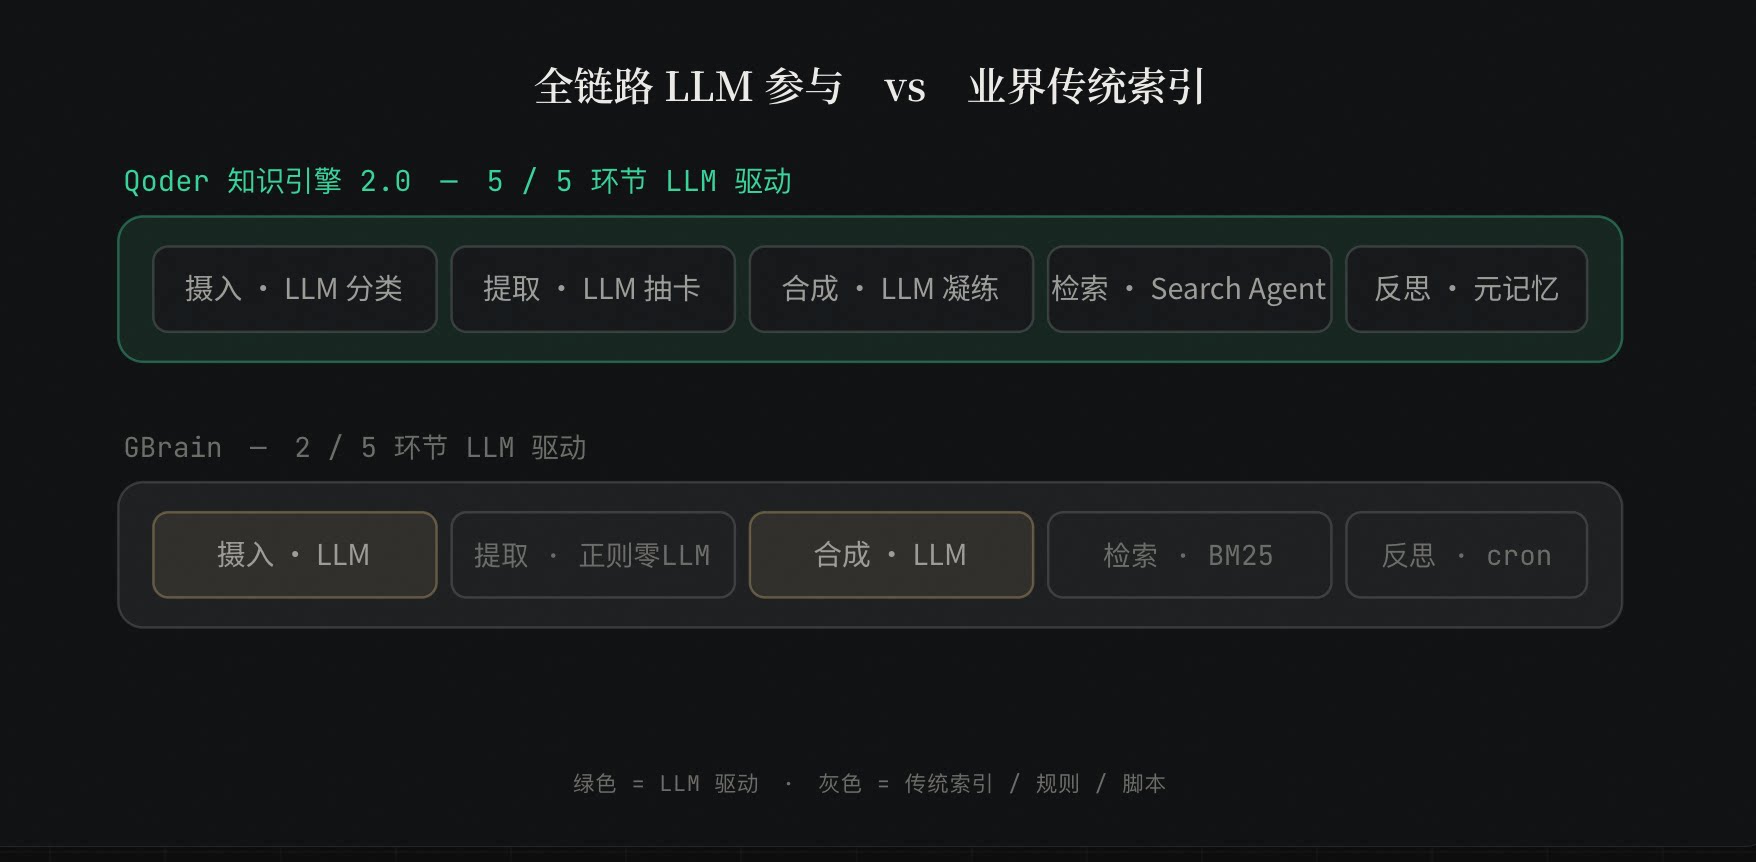
 其中 AI Native 这一条最容易被低估。GBrain 公开宣传的核心卖点之一是"零 LLM 调用的实体提取"——用正则推断关系,便宜快,但有损、且只能识别 5 种预设关系;LLM Wiki 检索层主要靠 BM25 等传统索引。而 Qoder 知识引擎 2.0 是全链路 LLM 参与。
一份自评、一份横评,两组数据共同验证:Qoder 知识引擎不只是"做了一套知识系统",而是真正提升了 Agent 的任务效果与执行效率。
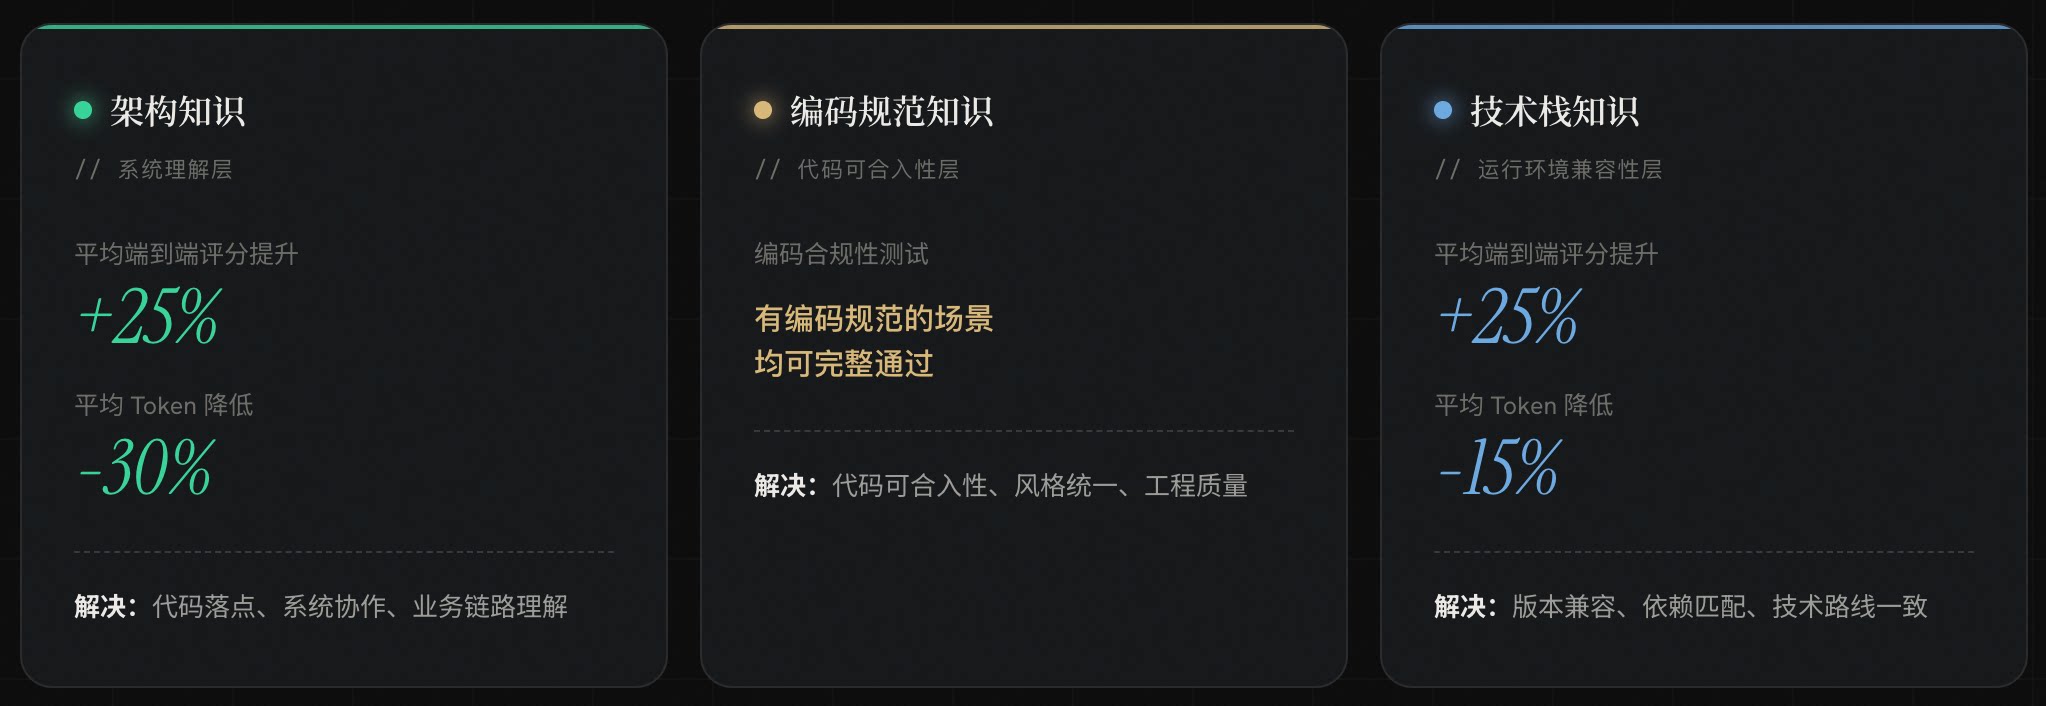
围绕 Coding Agent 落地效果,知识引擎沉淀了架构、编码规范、技术栈三类核心知识,分别从「系统理解」、「代码可合入性」、「运行环境兼容性」三个层面提供支撑。在典型软工场景下的端到端表现如下。
在多个真实代码仓库上,将 Qoder 知识中心与同类知识管理工具 Graphify、GBrain 横向对比。三项核心指标的结果如下。
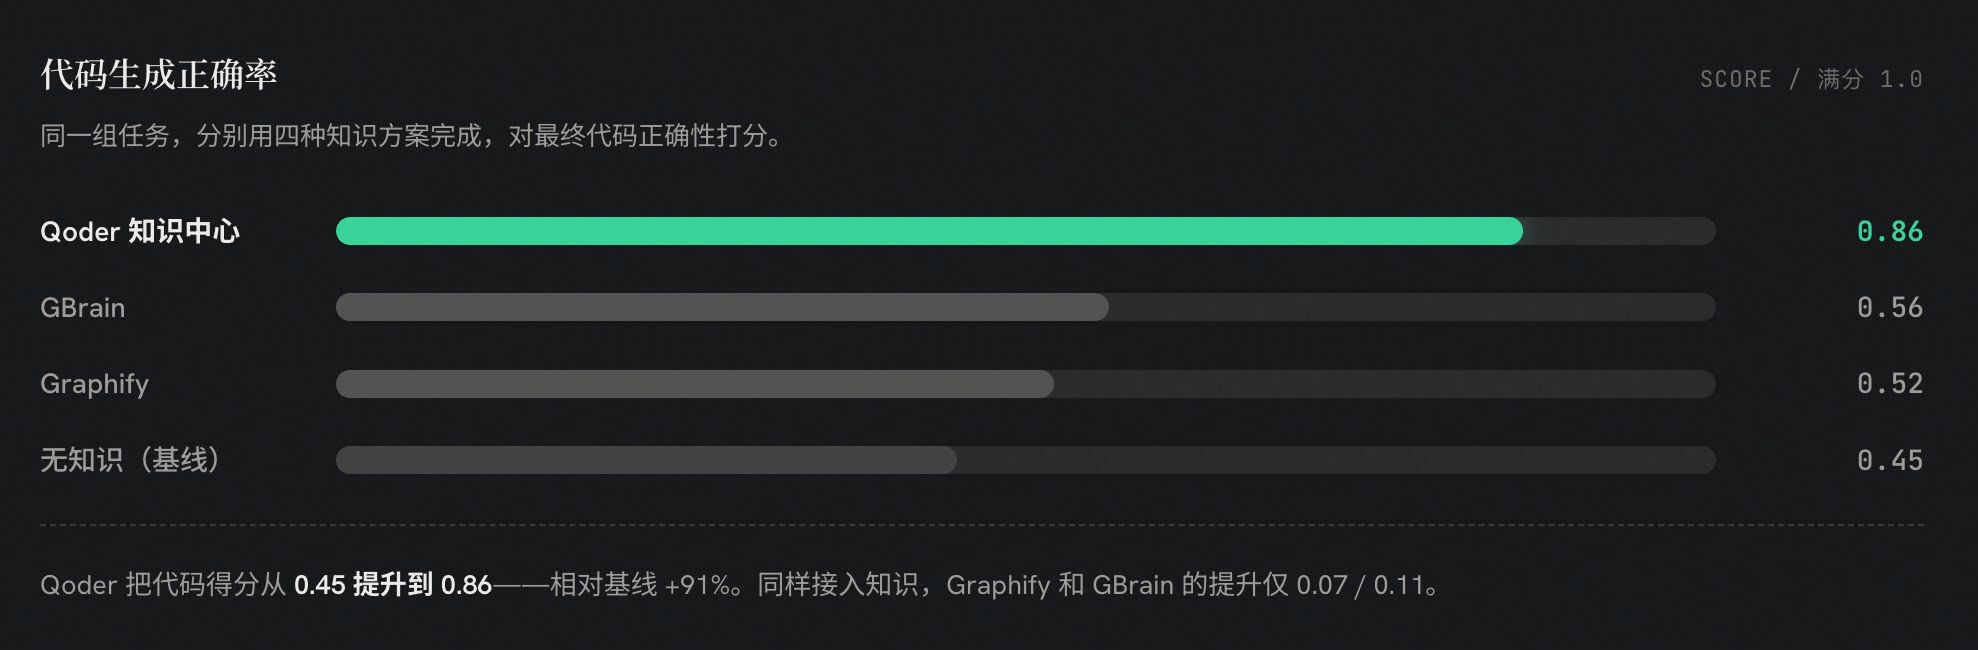
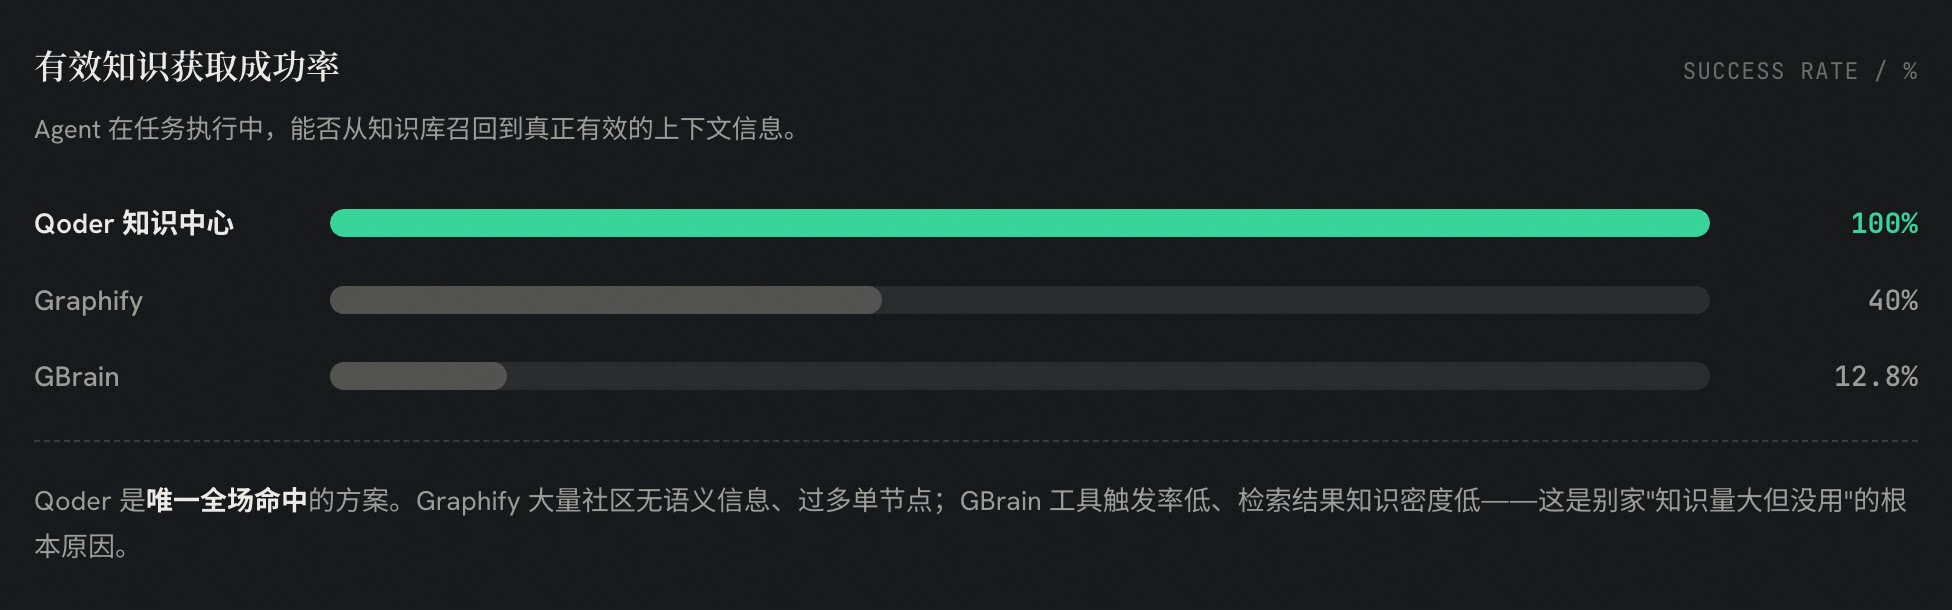
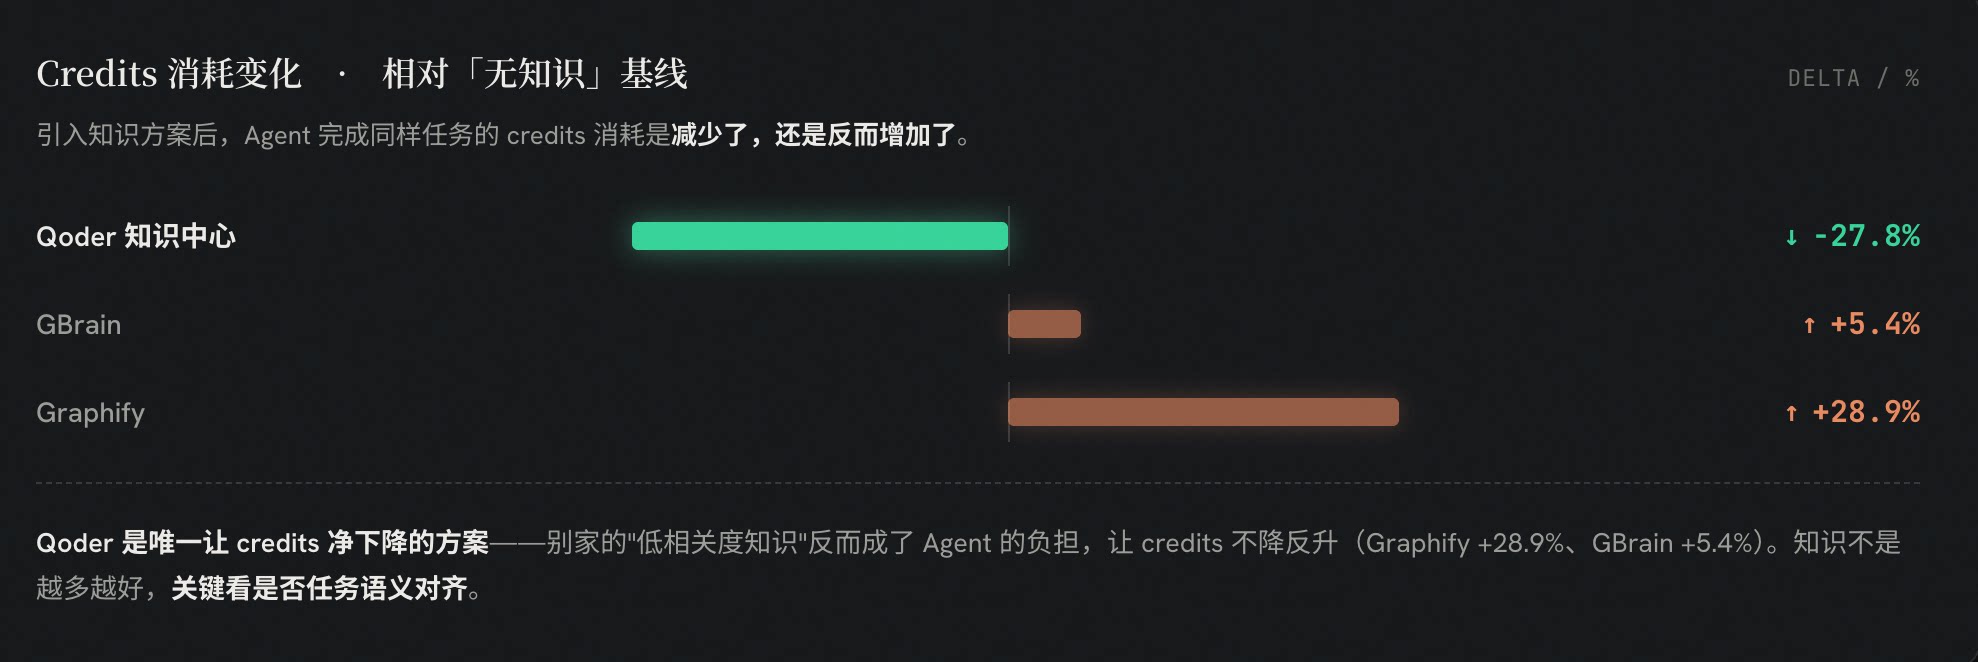 知识中心通过结构化组织与任务语义对齐的软工知识,使 Agent 在检索阶段可获得高相关度、低噪声的上下文信息——这正是 Qoder 知识引擎区别于通用知识管理工具的本质差异。
为软件工程而生的 AI Native 自迭代知识引擎——既给 Agent 喂结构化的知识卡,也给人沉淀连贯的 RepoWiki;每次 commit 自动更新,每次对话自动学习,一人贡献、全团队受益,并且在企业里真实落地、开箱即集成。
知识场景的两难
AI 编码助手已经很强了,它不认识你的代码,也不记得你的项目。再大的通用模型,如果对你的项目一无所知,就永远无法真正为你服务。
个人开发者的困境——每天协作,却每天从零开始
- 每次新对话都"失忆"——上下文随会话消失,架构决策无法留存。
- 反复自我介绍——项目技术栈、代码风格,一遍遍重新描述。
- 同一个坑踩两次——上次解决过的问题,这次又从头来过。
- 服务一天和服务一年没区别——学不会你的偏好,永远是"初次见面"。
- 知识困在个人脑子里——老员工的经验、踩过的坑,散落在聊天记录中无法沉淀。
- 新人上不了手——得不到老员工水平的回答,重复踩前人踩过的坑。
- 规范靠口口相传——Agent 生成的代码能跑,却不符合团队标准,过不了 review。
- 大库里盲目搜索——Agent 在复杂代码库反复检索,token 烧得多还找不准。
一个已经被验证的理念——自迭代的知识沉淀
Andrej Karpathy 提出了 LLM Wiki 的理念,随后 GBrain 把它做成了开源产品。他们指出了一个有参考的方向。
卡帕西的洞察很关键:人类为什么会放弃维护 Wiki?不是不会写,而是维护的"记账成本"——更新交叉引用、保持摘要时效、标注矛盾——增长得比知识本身的价值更快。但 LLM 不会累,它的维护成本趋近于零。
于是有了一个新范式:把知识"编译"一次,然后持续复用和增长。不是每次使用时临时拼凑,而是让知识像代码库一样被沉淀、被迭代。这和传统 RAG 形成了鲜明对比——RAG 每次提问都从零开始,知识不沉淀;编译式知识范式则让知识有了"积累效应",用得越多、越丰富、理解越强。
把知识自迭代,做进软件工程里
Qoder 知识引擎 2.0 围绕"编译式知识"这个理念,结合软件工程的真实场景,给出了四个层面的答案:怎么凝练知识、怎么让知识活着、能力栈怎么搭、企业怎么真正用起来。
核心方法:两步凝练,看山三境
编译式知识有个绕不开的矛盾:把原始材料直接编译成一份 Wiki,人和 AI 读的是同一份产物。但 Agent 想要的是高密度、结构化的信号,人想要的是连贯、易读的文章——一份产物服务两个需求,必然顾此失彼。
Qoder 的答案是两步凝练:原始信号先编译成 Knowledge Card(给 Agent 用),再基于 Knowledge Card 凝练出 RepoWiki(给人看)。这正是禅宗"看山三境"的工程化表达——看山是山、看山不是山、看山还是山。
让知识活着:双轮自迭代
知识库最大的敌人是"过时"。Qoder 用两个相互独立、又相互喂养的飞轮,让知识库随开发活动实时生长——不需要任何人专门去维护。
- 代码侧由 commit 触发,开发者每次提交,系统基于 diff 增量更新受影响的 Knowledge Card,RepoWiki 跟着刷新——写代码就在喂养知识库;
- 对话侧由 conversation 触发,每个问题、每个 plan、每个采纳的 spec 都被记忆智能体提炼,既进个人 Memory,也在 Teams 模式下沉淀进团队知识卡。
完整能力栈:六层架构
把上面的方法落到系统里,是一套六层能力栈——从底层向量检索,到顶层的 Agentic Search 认知中枢,每一层各司其职。
工程化落地:让企业真的能用
企业用知识引擎有三道现实门槛:代码安全不能出域、多人协作不能冲突、流程必须能进流水线。Qoder 知识引擎 2.0 对这三道门槛各有答案。
代码不出域——客户端生成
知识在客户端本地生成,服务端永远拿不到源代码,只接收结构化知识卡。企业代码资产零外泄风险。
协作不冲突——版本锁裁决
服务端按 repo + branch 维度加上传锁,再用 commit 版本裁决,旧版本不会覆盖新版本。
流程能集成——Wiki CLI + 共享
Wiki CLI 无需 IDE 批量生成、接入 CI/CD;团队通过 .qoder/repowiki 目录 git 共享;管理员统一管控。
软件工程领域落地独特性
业界主流的 LLM Wiki 与 GBrain 都是优秀的通用知识管理工具。但 Qoder 知识引擎 2.0 在四个维度上做到了软件工程领域的业界领先。
效果增益,不止于理念
一份自评、一份横评,两组数据共同验证:Qoder 知识引擎不只是"做了一套知识系统",而是真正提升了 Agent 的任务效果与执行效率。
三类知识,端到端增益
围绕 Coding Agent 落地效果,知识引擎沉淀了架构、编码规范、技术栈三类核心知识,分别从「系统理解」、「代码可合入性」、「运行环境兼容性」三个层面提供支撑。在典型软工场景下的端到端表现如下。
补充说明:所有典型软工场景接入知识引擎后,端到端评分都从不同起点提升到接近满分 1.0——其中起点最低的场景从 0.28 直达 1.0,说明了知识的质量。
与同类工具横向对比
在多个真实代码仓库上,将 Qoder 知识中心与同类知识管理工具 Graphify、GBrain 横向对比。三项核心指标的结果如下。
一句话总结
为软件工程而生的 AI Native 自迭代知识引擎——既给 Agent 喂结构化的知识卡,也给人沉淀连贯的 RepoWiki;每次 commit 自动更新,每次对话自动学习,一人贡献、全团队受益,并且在企业里真实落地、开箱即集成。