
技术揭秘:任务拆解、中枢调度与评测数据
返回
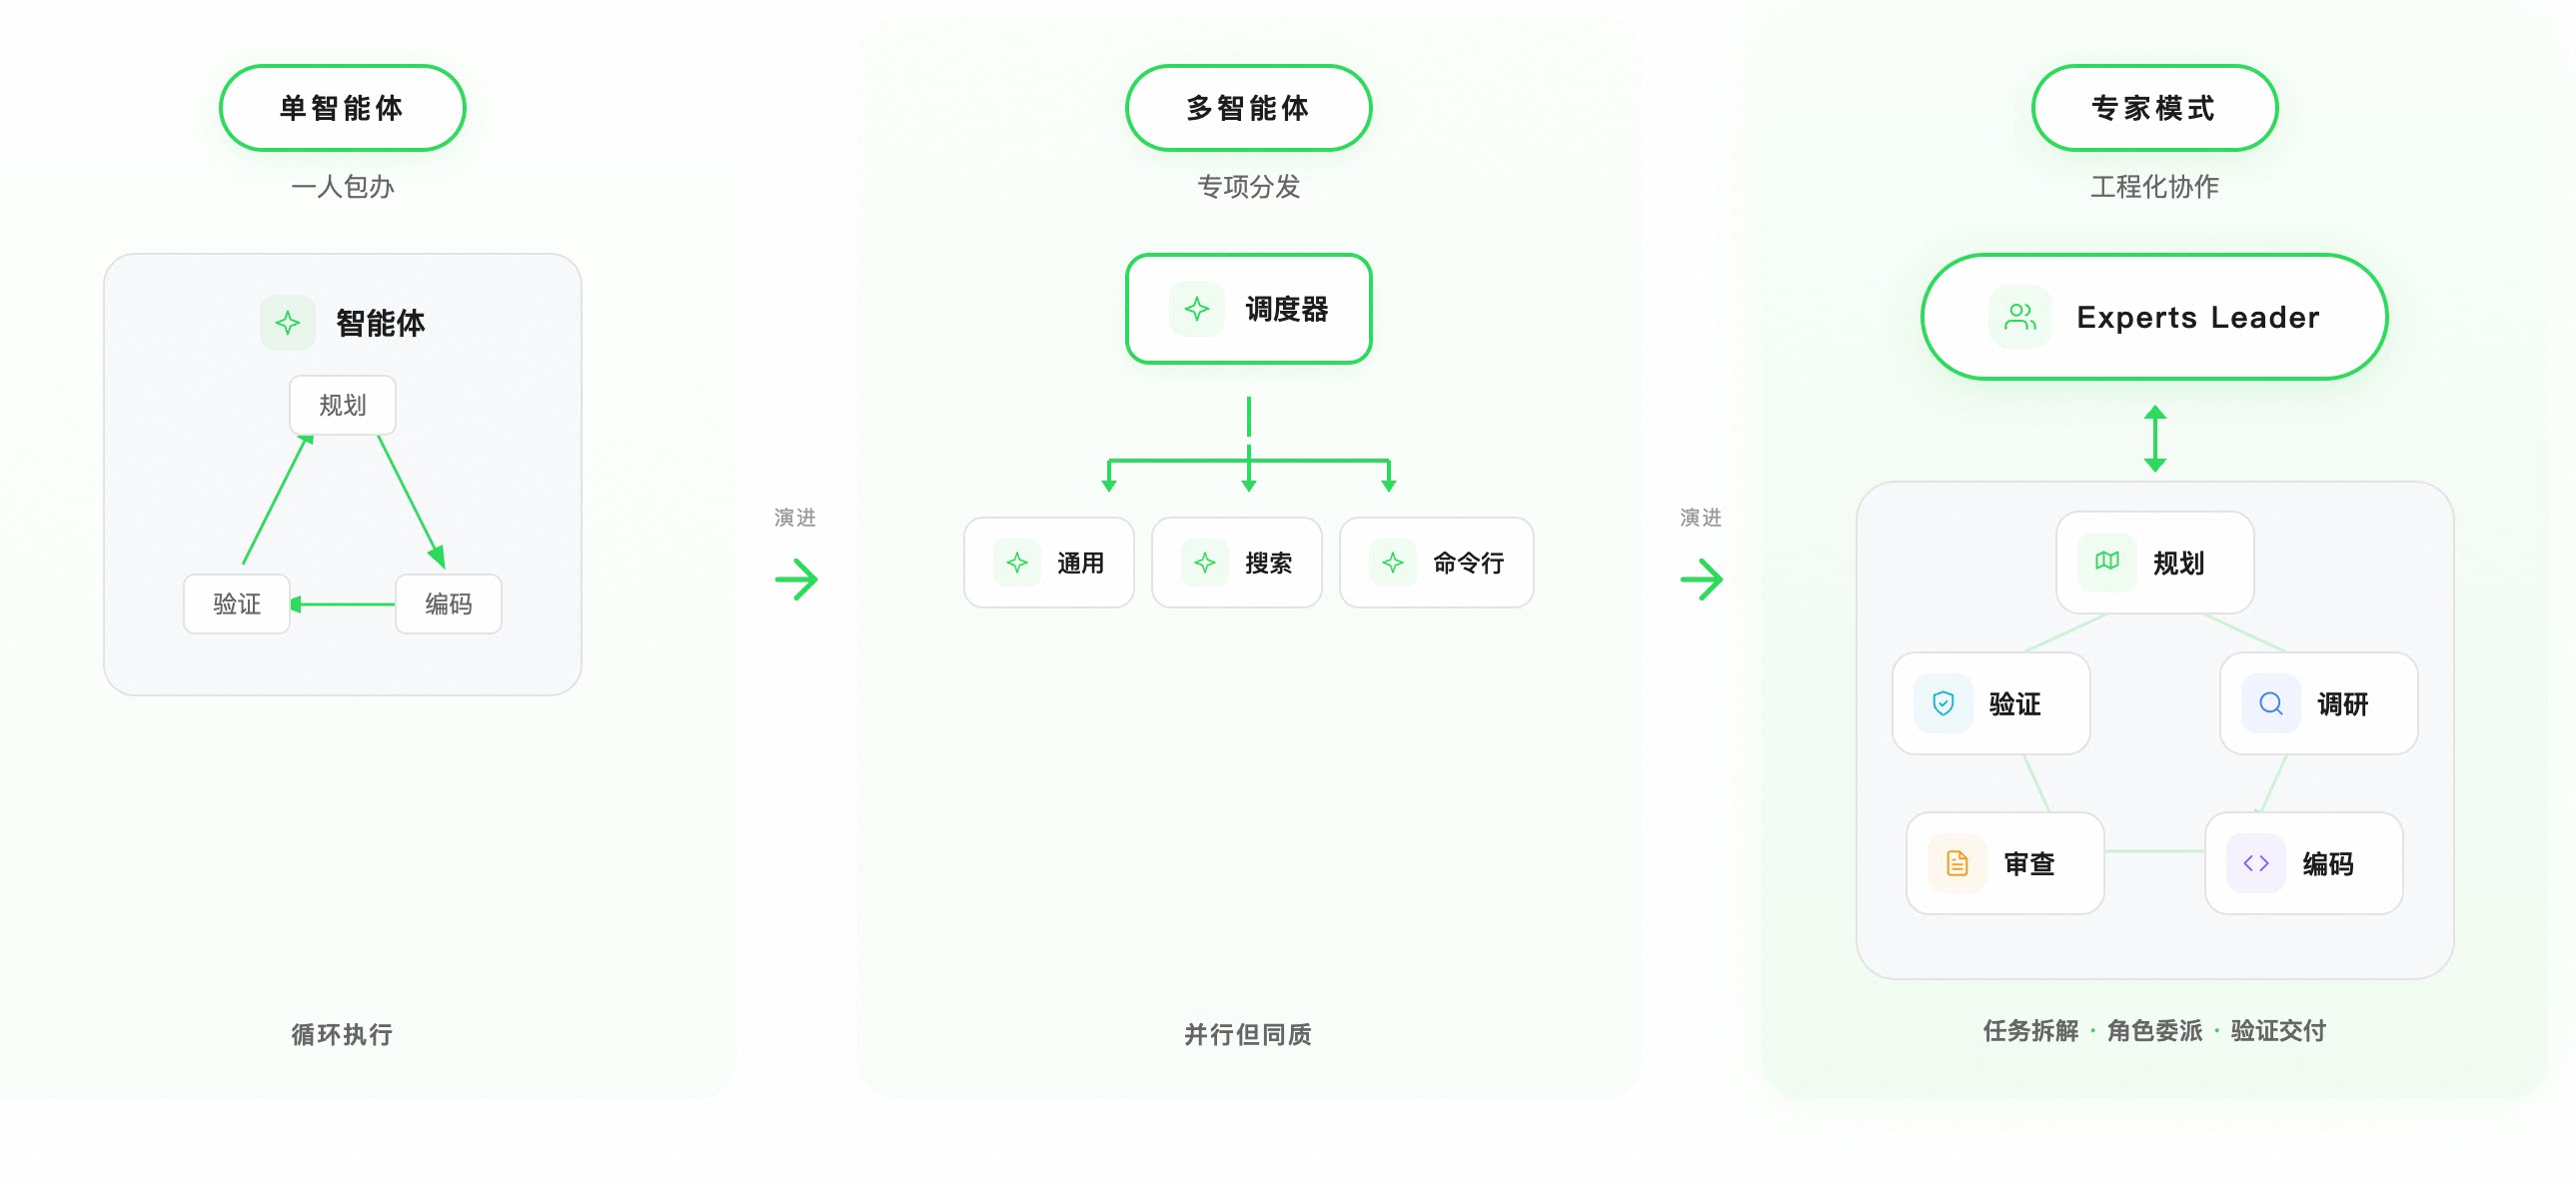
专家团模式是一种以任务拆解、角色分工和协同执行为核心的工程化 AI 工作方式。 它由 Team Lead 负责统一理解目标、规划路径与组织流程,并调度不同领域的 SWE Agents 分别承担方案设计、编码实现、测试验证、问题修复与质量检查等工作,将原本集中在单一执行链路中的任务处理过程,转化为更有组织的协同流程。 它关注的重点,不仅仅是生成代码本身,而是让 AI 能够围绕明确目标持续推进,并输出更完整、更可落地的结果。
从工程实践来看,开发任务通常涉及需求分析、方案设计、实现联动、验证测试和结果确认等多个阶段。 当任务跨越多个模块、环节或专业角色时,单一路径往往难以兼顾效率、质量与一致性。 以下是三类专家团模式的典型使用场景:
专家团模式的价值,不在于简单增加执行者数量,而在于引入了一套更系统的任务组织机制。
通过更细粒度的任务拆解、更合理的角色委派和更清晰的执行边界,系统能够把一个工程目标转化为若干可推进、可协同、可验证的子任务,并在执行过程中持续保持整体方向一致。
从结果上看,这种模式主要带来三方面收益:
专家团模式采用 Experts Leader 与专家团队架构,类似 Tech Lead 与各领域工程师的分工:Leader 统一决策、持有全局视图,专家各司其职专注执行。
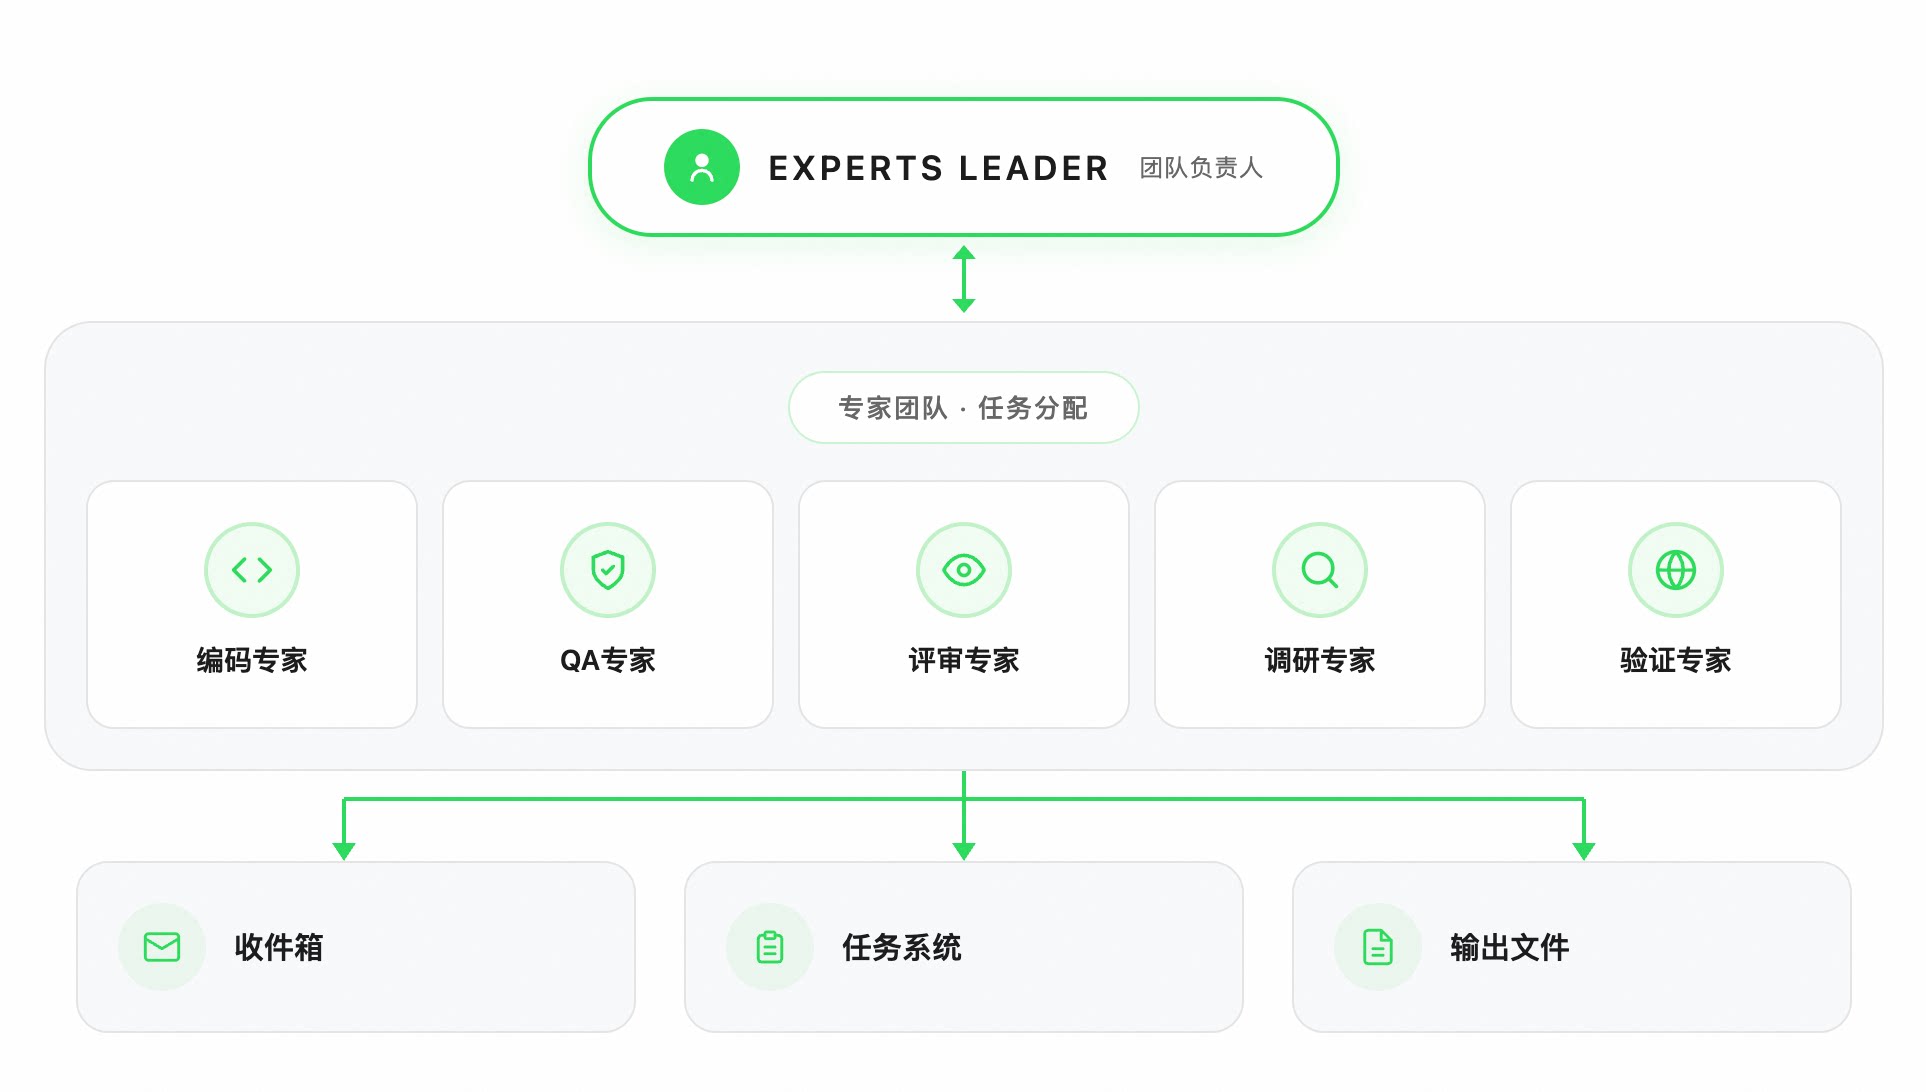
Experts Leader 的核心定位只有一条:只负责协调,不执行具体实现。它的职责是拆解需求、分配任务、掌控进度、汇总结果。
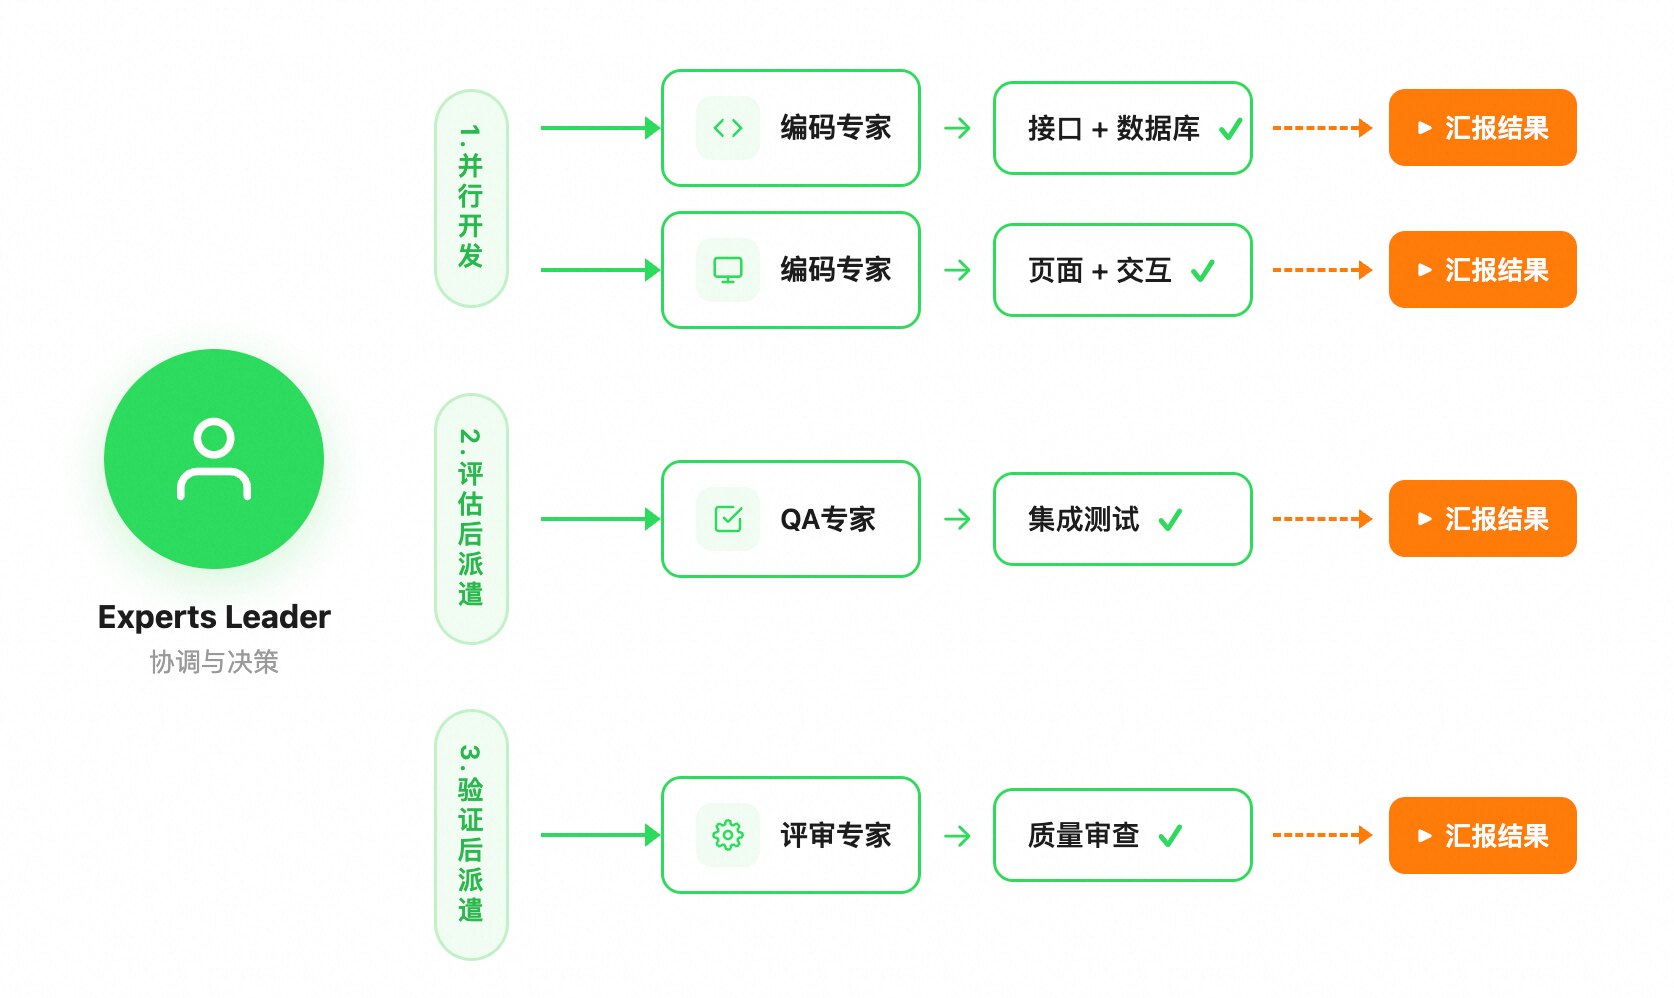
任务之间可以声明依赖关系,形成轻量级有向无环图。"API 实现" 和 "UI 开发" 可以并行派发;"集成测试" 依赖前后端完成,等前置任务就绪后自动解锁。这让 Experts Leader 能表达"先调研,再并行开发,最后测试和审查"的编排逻辑,而不只是平铺派发互不相干的任务。
系统内置五类专家:编码专家负责代码编写与重构,QA专家负责测试与集成验证,评审专家负责质量把关,调研专家负责技术调研,验证专家负责查阅在线文档。每类专家有独立工具集,系统还支持自定义专家类型。
专家团模式的关键设计:所有专家默认异步并行执行。Experts Leader 派出专家后立即返回,可以马上创建下一个专家,让多人同时开工。
Experts Leader 是所有信息流转的唯一中枢,统一决策、持有全局视图。专家之间不直接通信,所有协调都经由 Experts Leader 完成。
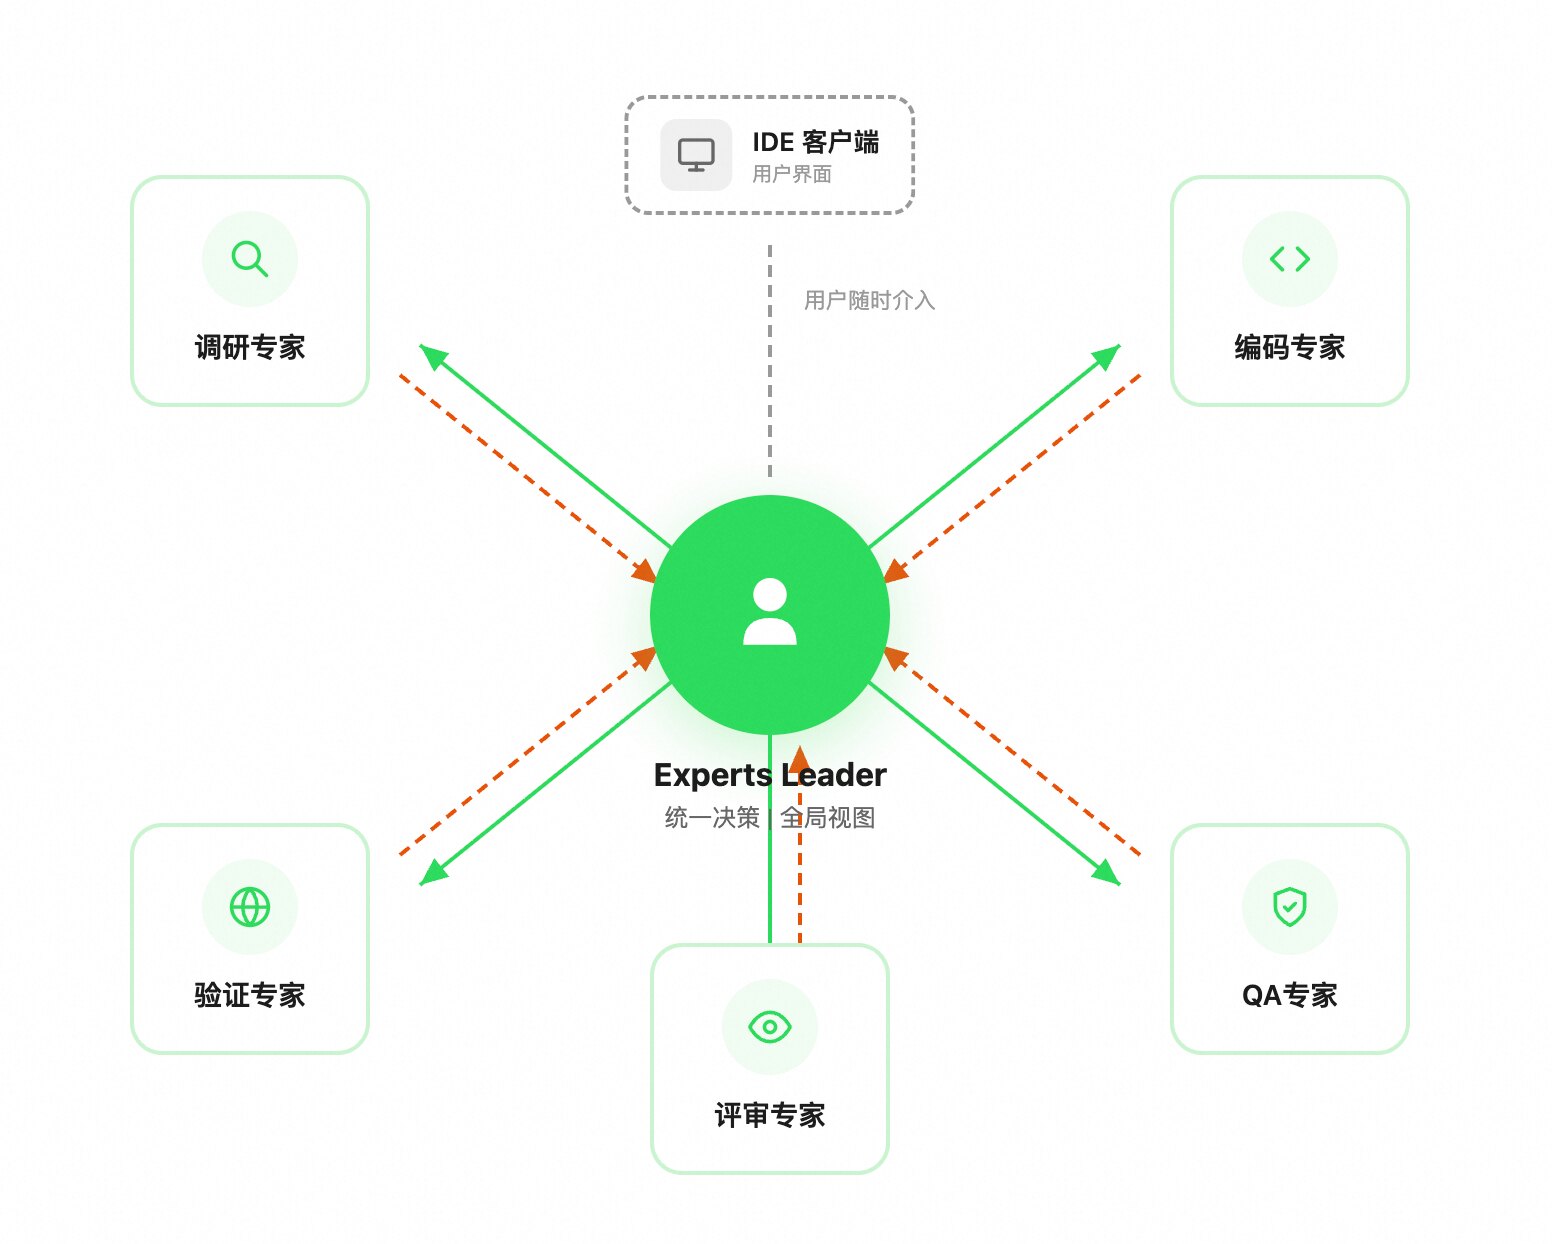 无约束的点对点通信会带来:信息碎片化(无人持有完整视图)、冲突协调困难(各自决策无人仲裁)、状态空间随参与者指数膨胀。让 Leader 作为中枢,这些问题自然消解。这就像真实工程团队,技术方案和任务进度必须在 Tech Lead 那里对齐。
 用户也是协调链路的一部分。你可以在专家团运行时随时介入,Experts Leader 在下一轮循环中处理,调整任务方向或取消不再需要的任务。你的角色变了:和 Experts Leader 澄清意图、对齐方向、审核计划、验收结果,更像带一个有经验的研发小组。
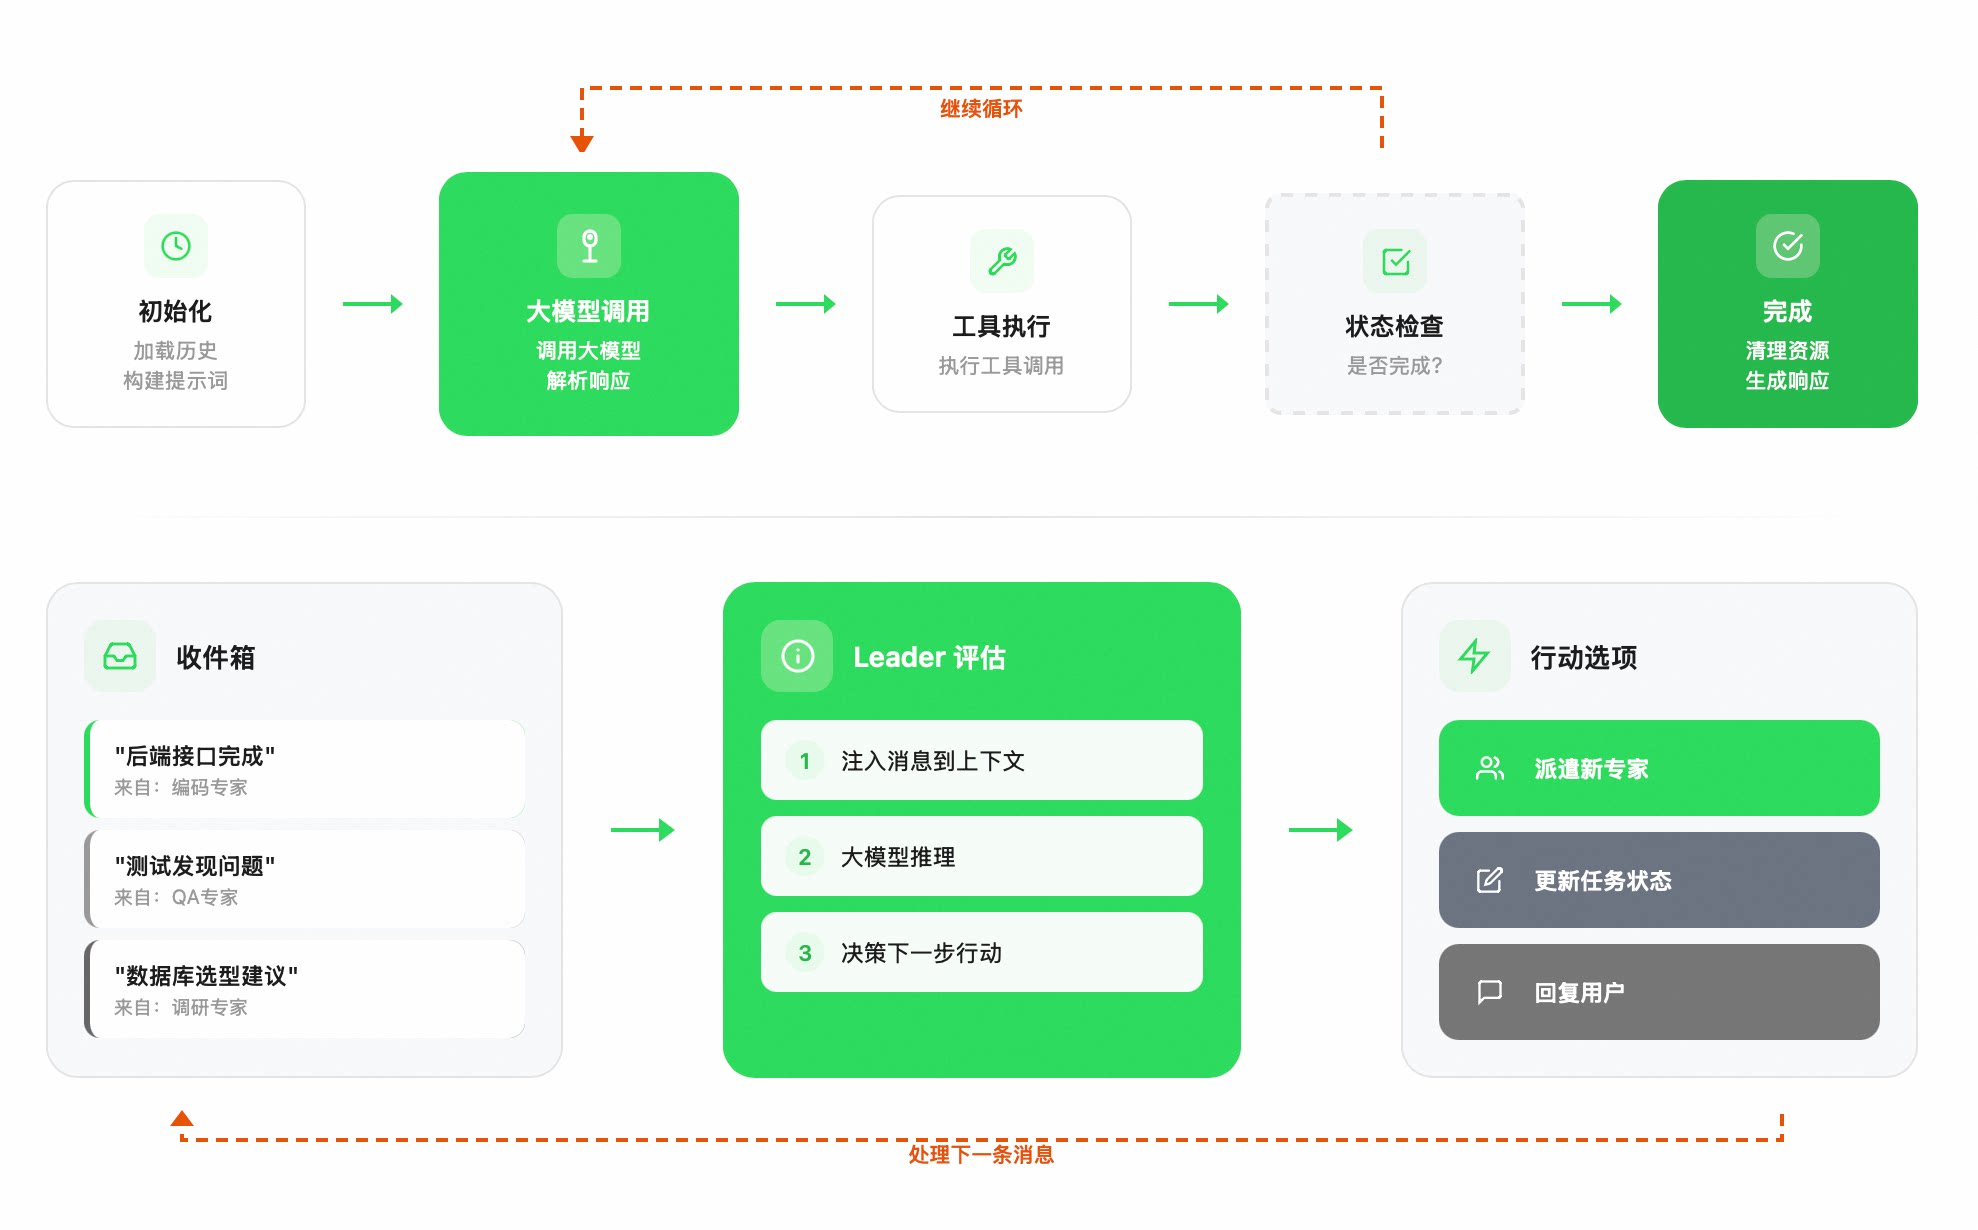
系统为 Expert Leader 维护一个收件箱。专家完成后通过回调主动汇报,消息进入收件箱。Experts Leader 空闲时消费未读消息:注入上下文 → 大模型推理 → 决策下一步行动,包括 派遣新专家、更新任务状态或回复用户。每条消息都可能触发新的派遣,"汇报、评估、行动"的循环不断运转,直到所有任务完成。
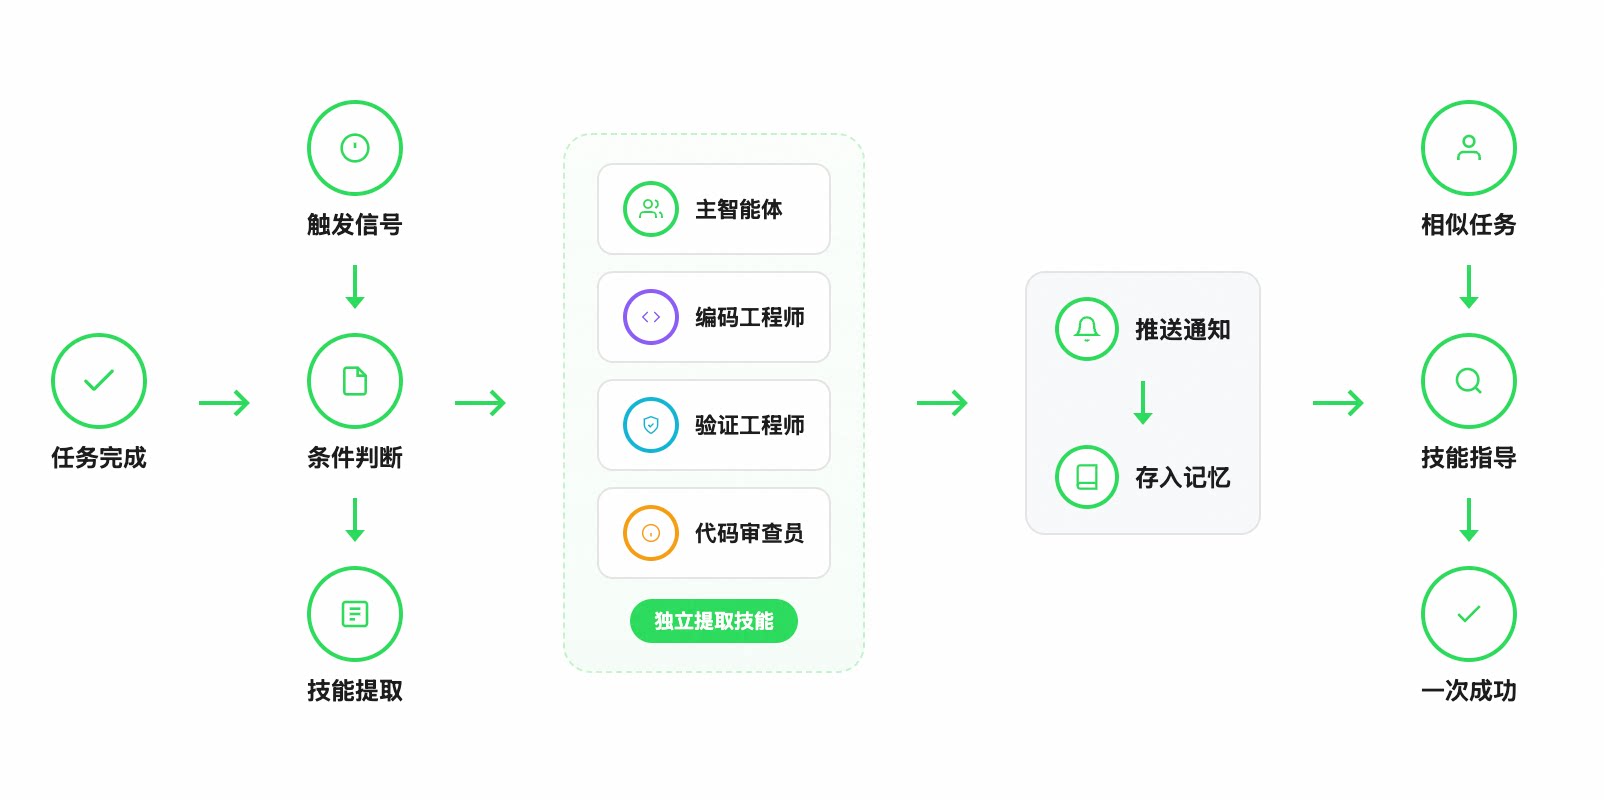
当任务完成后,系统识别触发信号(如方法纠正、失败学习、用户教学),经过条件判断后进行技能提取,由主智能体和各子智能体(编码工程师、验证工程师、代码审查员)分别独立提取各自领域的技能,随后推送卡片通知用户、将技能存入记忆系统形成持久化的技能记忆;当用户下次发起相似任务时,系统自动通过记忆系统回忆沉淀的技能,注入上下文指导任务执行,实现一次成功无需再次纠正,整个过程形成“任务完成→ 提取技能→ 沉淀记忆 →召回技能 →直接成功”的持续进化循环。
我们在内部复杂任务基准测试中,对 Qoder Experts Mode 进行了系统评估。测试覆盖前后端全栈开发、跨语言重构、存量工程需求实现等典型场景,重点考察多 Agent 架构在真实工程任务中的交付能力。
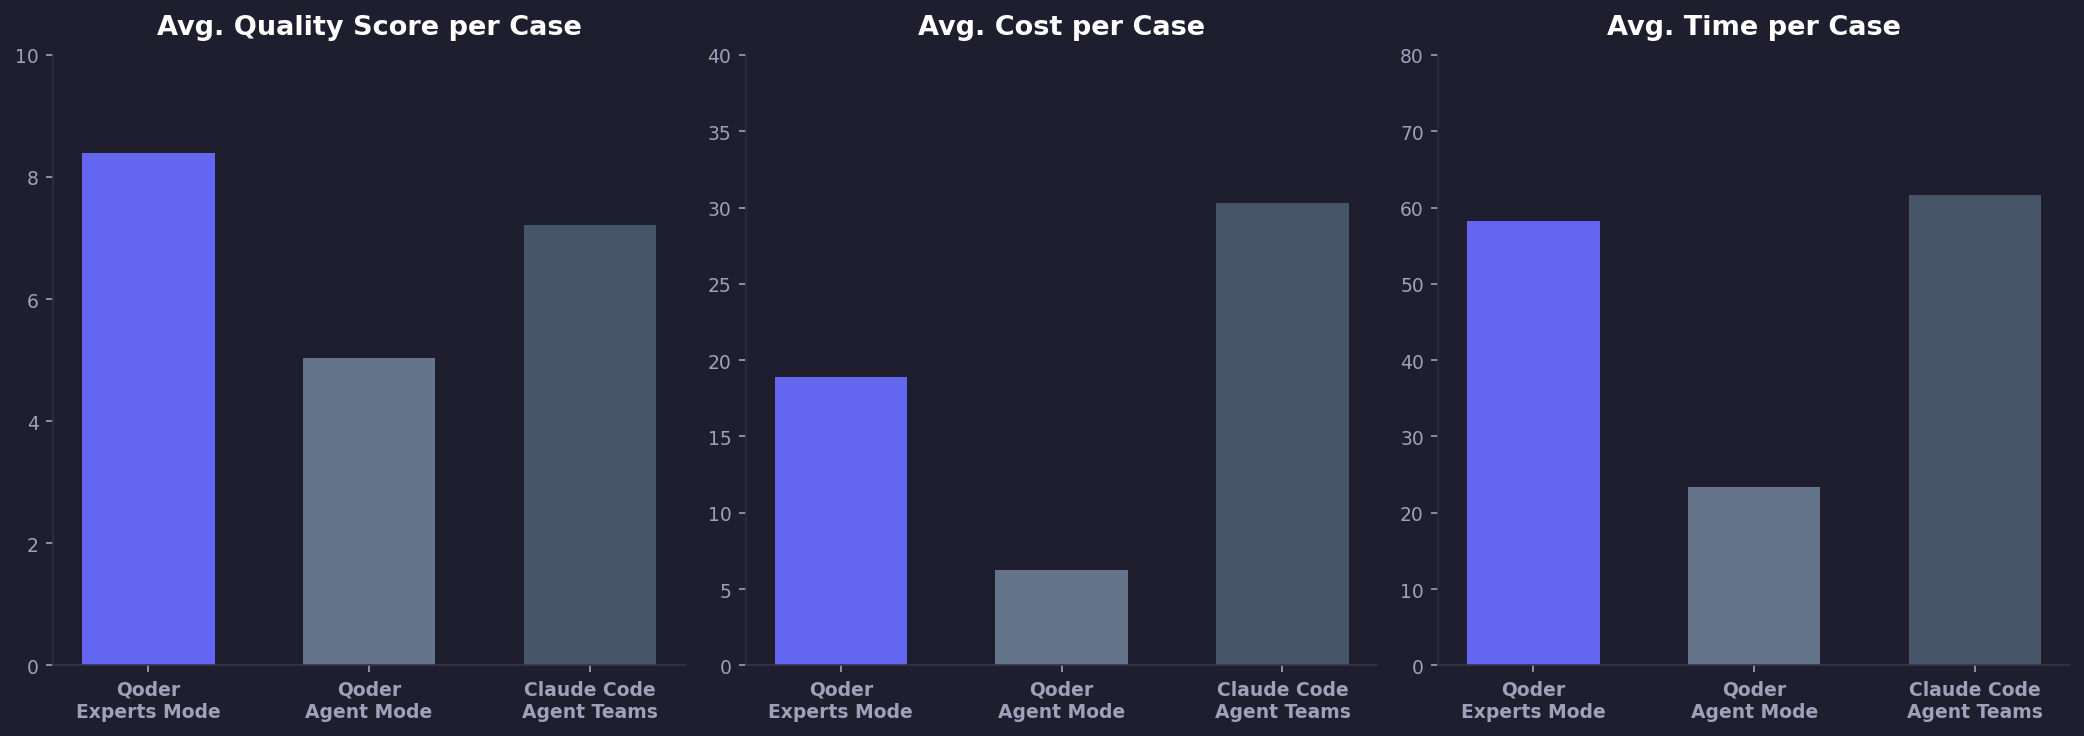 核心结论:
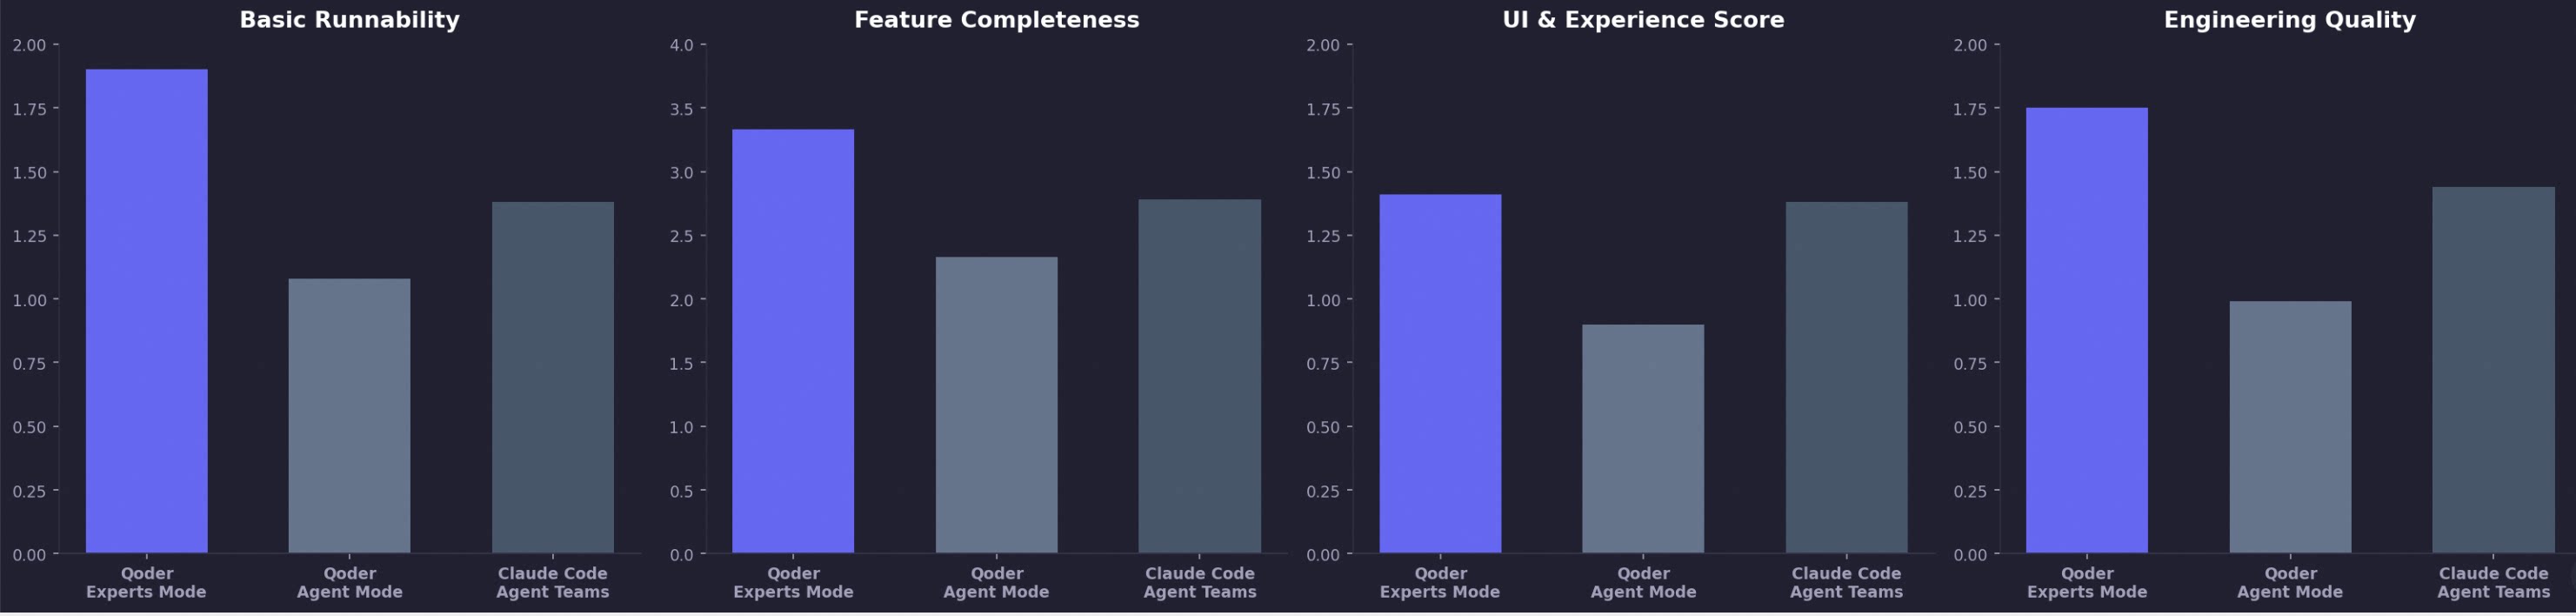 从评测结果看,Qoder Experts Mode 在这四项指标上均取得了更好的表现:
专家团(Experts Mode)是什么
专家团模式是一种以任务拆解、角色分工和协同执行为核心的工程化 AI 工作方式。 它由 Team Lead 负责统一理解目标、规划路径与组织流程,并调度不同领域的 SWE Agents 分别承担方案设计、编码实现、测试验证、问题修复与质量检查等工作,将原本集中在单一执行链路中的任务处理过程,转化为更有组织的协同流程。 它关注的重点,不仅仅是生成代码本身,而是让 AI 能够围绕明确目标持续推进,并输出更完整、更可落地的结果。
主要的场景模式
从工程实践来看,开发任务通常涉及需求分析、方案设计、实现联动、验证测试和结果确认等多个阶段。 当任务跨越多个模块、环节或专业角色时,单一路径往往难以兼顾效率、质量与一致性。 以下是三类专家团模式的典型使用场景:
- 前后端全栈开发:围绕完整需求进行方案设计、跨模块实现、联调与测试补齐;
- 复杂问题定位与修复:针对跨模块、多服务或多阶段问题进行分析、定位、修复与验证;
- 技术方案调研:从不同角色视角完成可行性分析、影响评估和方案输出。
专家团模式优势
专家团模式的价值,不在于简单增加执行者数量,而在于引入了一套更系统的任务组织机制。
通过更细粒度的任务拆解、更合理的角色委派和更清晰的执行边界,系统能够把一个工程目标转化为若干可推进、可协同、可验证的子任务,并在执行过程中持续保持整体方向一致。
从结果上看,这种模式主要带来三方面收益:
- 更合理的任务组织方式:通过拆解与分工降低长链路执行中的负担与偏移;
- 更高的整体推进效率:通过协同与并行缩短从需求到结果的完整路径;
- 更完整的结果闭环:将实现、测试、修复与检查纳入统一流程,使输出更接近可直接使用和持续推进的工程结果。
专家团模式的架构设计
专家团模式采用 Experts Leader 与专家团队架构,类似 Tech Lead 与各领域工程师的分工:Leader 统一决策、持有全局视图,专家各司其职专注执行。
一、Leader:只做决策,不写代码
Experts Leader 的核心定位只有一条:只负责协调,不执行具体实现。它的职责是拆解需求、分配任务、掌控进度、汇总结果。
任务之间可以声明依赖关系,形成轻量级有向无环图。"API 实现" 和 "UI 开发" 可以并行派发;"集成测试" 依赖前后端完成,等前置任务就绪后自动解锁。这让 Experts Leader 能表达"先调研,再并行开发,最后测试和审查"的编排逻辑,而不只是平铺派发互不相干的任务。
系统内置五类专家:编码专家负责代码编写与重构,QA专家负责测试与集成验证,评审专家负责质量把关,调研专家负责技术调研,验证专家负责查阅在线文档。每类专家有独立工具集,系统还支持自定义专家类型。
二、异步并行:不等待,不阻塞
专家团模式的关键设计:所有专家默认异步并行执行。Experts Leader 派出专家后立即返回,可以马上创建下一个专家,让多人同时开工。
三、中枢协调:统一决策,全局视图
Experts Leader 是所有信息流转的唯一中枢,统一决策、持有全局视图。专家之间不直接通信,所有协调都经由 Experts Leader 完成。
四、自进化:经验和知识持续沉淀
当任务完成后,系统识别触发信号(如方法纠正、失败学习、用户教学),经过条件判断后进行技能提取,由主智能体和各子智能体(编码工程师、验证工程师、代码审查员)分别独立提取各自领域的技能,随后推送卡片通知用户、将技能存入记忆系统形成持久化的技能记忆;当用户下次发起相似任务时,系统自动通过记忆系统回忆沉淀的技能,注入上下文指导任务执行,实现一次成功无需再次纠正,整个过程形成“任务完成→ 提取技能→ 沉淀记忆 →召回技能 →直接成功”的持续进化循环。
特调定制专家团介绍
| 专家名称 | 使用场景 | 核心技术与数据 |
|---|---|---|
| 调研专家 (Research) | 新项目技术方案选型;线上问题根因排查;竞品分析与行业调研;代码库影响范围评估;依赖升级风险评估 | 融合语义检索、代码检索、知识图谱、Wiki 语义知识、网络检索等检索能力。相较业界主流方案,代码检索的 F-Score 提升 21%。 |
| 编码专家 (Coding) | 新功能模块开发;线上 Bug 紧急修复;存量代码重构优化;API 接口开发与对接;数据库模型与迁移 | 融合上下文引擎、RepoWiki 等核心能力,编码领域达到顶级的效果。安全方面率先支持全平台沙箱(Mac、Linux、Windows),确保代码和数据安全。 |
| QA 专家 (Verify) | 功能变更后回归验证;提交前质量门禁检查;重构后功能完整性校验;需求验收与功能验证;构建与部署前检查 | 变更感知精准定位;多维度检查(功能实现/规范/类型/测试/编译等);验证证据自动收集。 |
| 评审专家 (CodeReview) | PR/MR 代码审查;核心逻辑变更风险评估;安全漏洞与性能隐患排查;团队编码规范落地检查;架构合理性评审 | 上下文工程驱动;多维度审查(架构/逻辑/安全/性能/并发/错误处理等);高召回低误报。基于开源评测集业界 Top2,优于 Cursor、Codex 等产品。 |
| 浏览器专家 (Browser) | 前端页面交互验收;表单流程端到端测试;页面渲染与视觉回归;用户注册/登录等核心流程;跨浏览器兼容性验证 | 通过工具优化、智能模型路由、子 Agent 调度等技术,相同任务相比 Playwright-MCP 节省 60% 的 Token 成本。 |
评测数据
我们在内部复杂任务基准测试中,对 Qoder Experts Mode 进行了系统评估。测试覆盖前后端全栈开发、跨语言重构、存量工程需求实现等典型场景,重点考察多 Agent 架构在真实工程任务中的交付能力。
- 效果更好:Qoder Experts Mode 的综合质量显著优于 Qoder Agent Mode,并领先 Claude Code Agent Teams。
- 成本更优:在取得更高质量结果的同时,Qoder Experts Mode 的整体成本低于 Claude Code Agent Teams。
- 整体耗时更优:虽然单次任务执行时间高于单 Agent,但由于并行执行、验证前置和返工减少,整体交付周期更有优势。
- 可用性:通过将实现、验证、评审拆分给独立专家,并由 Leader 按依赖关系调度,生成结果的可运行性更稳定。
- 完成度:Leader 能将复杂需求拆解为可并行推进的子任务,减少单 Agent 在长链路任务中的上下文丢失和执行漂移,因此对需求的覆盖更完整。
- UI 体验:Browser 专家可参与页面验证与交互检查,使前端结果不仅“功能存在”,也更接近可直接演示和交付的状态。
- 工程质量:Verify 和 Code Review 专家将测试、静态检查、变更评审前置到执行链路中,降低了逻辑遗漏、结构失衡和跨模块副作用。
数据来源于 Qoder 内部复杂任务基准测试,测试使用相同模型,均使用 API 官方价格进行计算。