
长期记忆助力智能体自我学习进化
返回
 在AI编码助手日益普及的今天,我们经常遇到这样的困扰:每次重新开始对话,AI 智能体都像"失忆"一样,完全不记得之前的交互经历。这不仅导致重复性工作增加,更让AI难以真正理解开发者的编码风格和偏好。如何让AI编码智能体具备"长期记忆",实现持续进化?
传统的AI编码智能体存在以下问题:
我们通过持续分析用户与智能体的对话,提取出有用的个性偏好、经验教训等,存储为类似“笔记”的语义文本。智能体在后续对话中,只需选择性的查看“笔记”,即可快速回忆历史,从而具备较为实时的长期记忆能力。
为了让记忆系统聚焦在编码领域,我们将长期记忆按照类别分为三大类:个人偏好、历史经验、工程知识
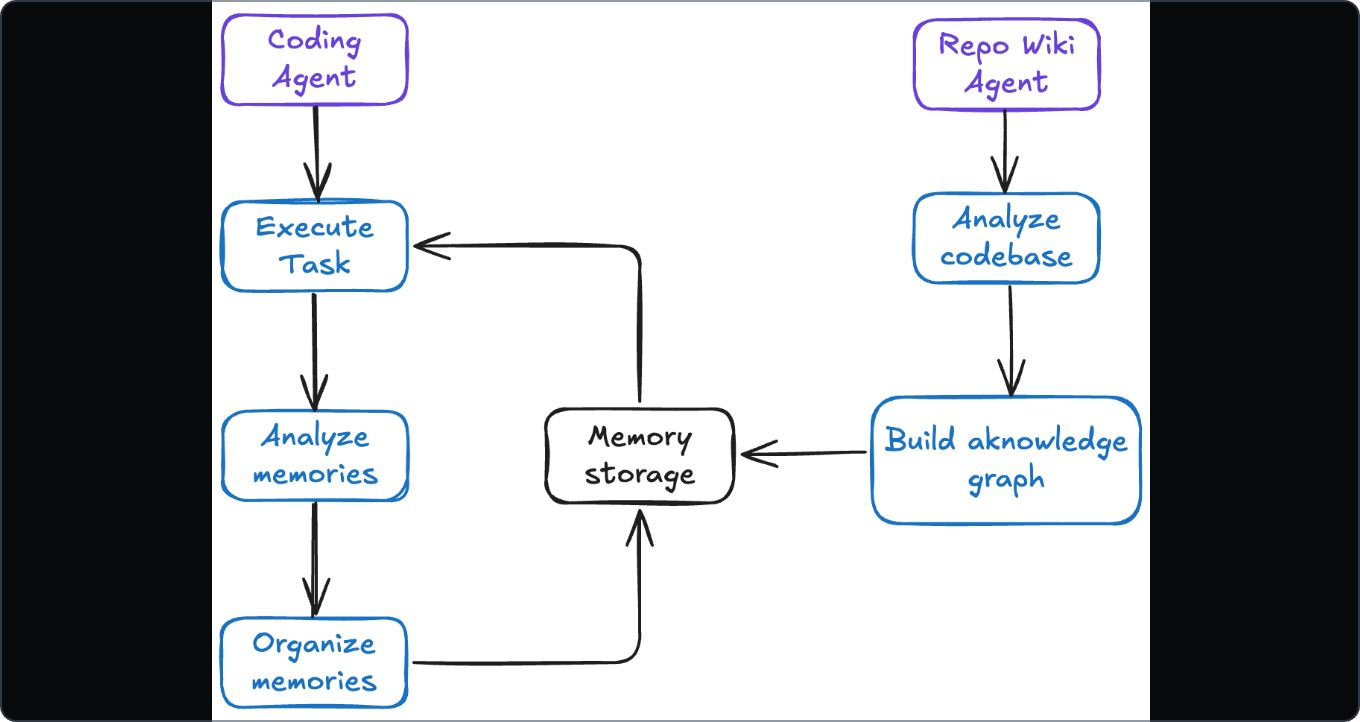
用户的偏好类记忆通常能从用户的提问中分析得到,但是智能体的执行过程中,存在大量值得被记住的有价值信息(如本地环境、运行指令等),此外,为了提升智能体对工程的了解程度,也需要让记忆系统对代码工程有深刻的认知。所以为了得到全面的记忆,需要分析多种来源数据。记忆系统会从用户的提问及智能体的执行过程中提取有效记忆,从而提升智能体的执行效率。在打开工程后,也会对代码工程进行实时建模,分析工程顶层设计知识。
如何评价记忆对整体流程的影响?如何有效的自优化记忆?记忆评估就作为其中尤为重要的一环,类似于强化学习中的价值反馈,记忆的自优化也需要得到有效性、质量的反馈,才能自主优化迭代。记忆系统会对提取的记忆进行质量评估,如果是低质量的记忆,会拒绝保留。智能体每次完成任务,记忆系统会对召回的记忆进行有效性评估。
提取得到的记忆是比较碎片化的,如果不进行整理,就会导致堆积大量重复、冲突和低质量的记忆片段,从而对智能体的执行效率产生负面影响。记忆系统会高效的整理记忆,对记忆进行去重、冲突解决、融合,从而达到记忆进化的作用。结合记忆的质量评估和有效性评估,通过遗忘算法去除无效的记忆,避免带来负面影响。
智能体通过完整的记忆循环实现自我进化:首先基于上下文进行记忆召回,继而智能体执行编码任务,任务完成后立即开展记忆分析与提取,随后对新增记忆进行质量评估,最终完成记忆的系统性整理。这一闭环确保了智能体能够在开发者的持续使用过程中不断积累和优化记忆库,实现"用得越多,越懂你"的良性循环,最终达到智能体的自我完善与持续进化。
经过我们的评估,记忆系统已经可以有效的提升智能体的执行效率,减少重复性的犯错。
长期记忆机制为 AI 编码助手带来革命性突破,使其能够真正理解并适应开发者的个性化需求,并且让智能体更懂代码工程。
未来编码智能体的记忆将如何演进:记忆系统的持续自优化。
随着技术的持续演进,记忆系统能像神经网络模型一样自我训练迭代:
模型输入(对话流) -> 模型输出(记忆提取) -> 梯度下降(记忆评估及整理),随着使用轮次增多,记忆系统将愈发精准。
多维度记忆图谱的构建。人类大脑的记忆来源于多维度多模态的信息,所以编码智能体的记忆也应该从开发者日常行为、所见所想等多种来源获取更丰富的记忆信息。
为什么需要长期记忆?
传统的AI编码智能体存在以下问题:
- 缺乏个性化:无法记住用户的编码规范和偏好
- 重复错误:相同的错误可能反复发生,增加任务完成时间
- 经验无法积累:每次对话都从零开始
- 代码库零认知:每次都需要重新分析代码库,反复获取工程知识
长期记忆的自优化
我们通过持续分析用户与智能体的对话,提取出有用的个性偏好、经验教训等,存储为类似“笔记”的语义文本。智能体在后续对话中,只需选择性的查看“笔记”,即可快速回忆历史,从而具备较为实时的长期记忆能力。
为了让记忆系统聚焦在编码领域,我们将长期记忆按照类别分为三大类:个人偏好、历史经验、工程知识
- 个人偏好:精准捕捉开发者的代码风格和开发习惯。 记录用户的个性化风格、行为偏好、用户指令等。如“完成任务后一定要生成单元测试”、“完成任务后提供详细说明”等。
- 历史经验:系统化沉淀问题解决方案与最佳实践。 记忆完成历史任务时遇到的错误及解决办法,避免后续犯同样的错误。如“实现某功能的主要流程”、“测试框架使用与问题排查经验”、“工程构建运行经验”等。
- 工程知识:构建完整的代码库认知图谱。 对代码工程进行详细的分析,并整理为工程知识库,为智能体提供代码库的顶层设计认知,再配合实时的工程感知,从而能够更高效的完成任务。如“技术栈”、“功能特性架构知识”、“API 文档”等。