
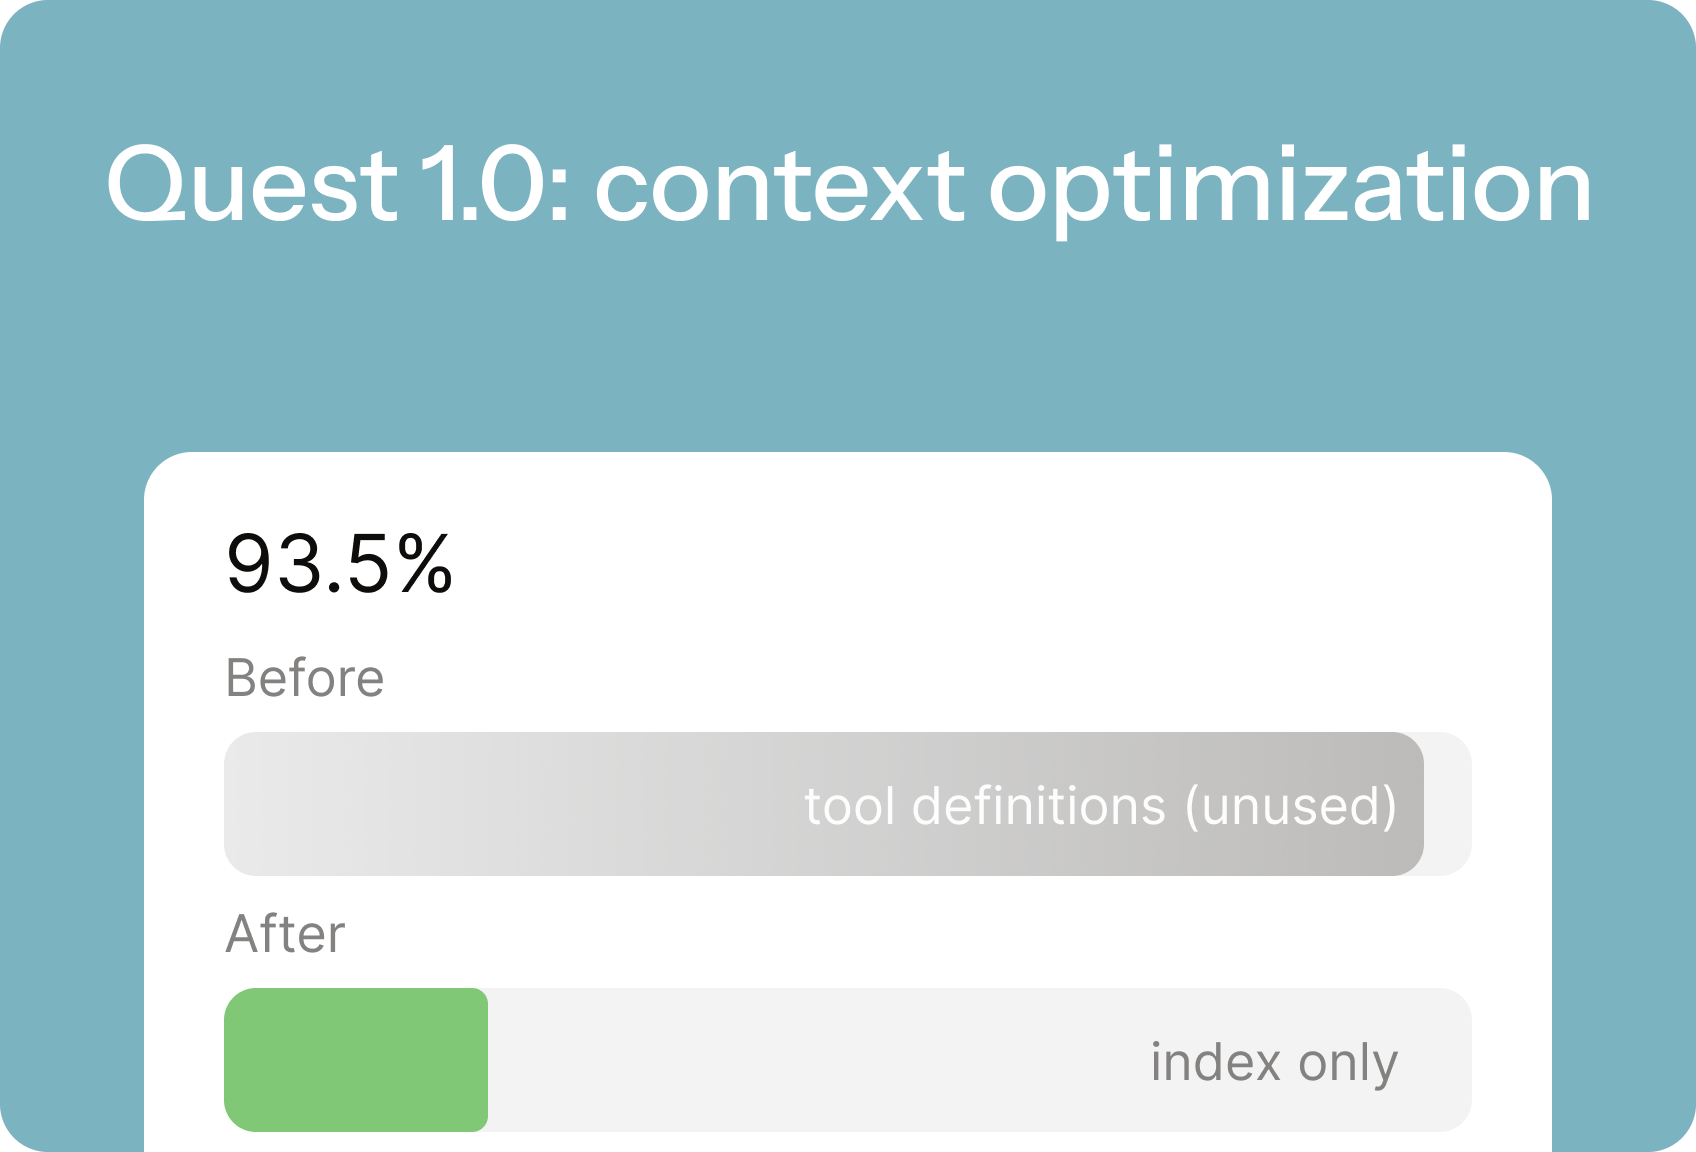
93.5% 的 context 是用不上的工具定义。这是我们的解法。
返回
 Quest 支持通过 Skills 和 MCP Server 扩展能力。上线后不久,我们从一次异常的 token 分布里,发现了一个大多数 AI Agent 都可能存在的问题。
Quest 1.0 上线后没多久,有用户反馈:一次任务把大量积分烧掉了,结果还不满意。
我们把那次对话的 token 分布数据拉出来看。12 万个 input token 里,93.5% 是工具定义。这些工具,在整次任务中一次都没被调用过。
这是个极端案例,那个用户挂载了好几个 MCP Server。但它暴露了一个普遍问题:context 里堆满了"以防万一"的工具定义,大多数时候根本用不着。
我们团队里有人之前配置了 playwright-mcp 做前端自动化测试,测试结束后就再没碰过。它的工具定义还是在每次对话的 context 里出现,没人注意到,一放就是几周。
做了个对照实验:同样的任务,一组挂载两个 MCP Server(全程没用到),一组完全不挂。只是挂在那里,积分消耗就多了 10% 以上。两个 MCP Server 贡献了将近一百条工具定义,消耗接近 2000 个 token。
内部做了个小调查:80% 的同事至少配置了一个 MCP Server,但实际使用频率不足 10%。
问题摆在那里:不想删工具,但不能让它们一直占着 context,怎么办?
解决 MCP 之前,我们在另一个功能上已经碰过类似的墙:Skills。
Quest 的 Skills 功能让用户定义专项知识和工作流,Agent 按需加载。但用户反映 Skills 的自动触发率很低,经常需要手动输入
模型调用 Skills 需要完成三件事:
我们的做法:在 System Reminder 里放一个轻量级的 Skills 索引,而不是完整定义。
索引里只有每个 Skill 的名称和一行描述,几百个 token。模型用这个索引做意图匹配,判断需要某个 Skill 的时候,再通过索引去定位和加载完整内容。
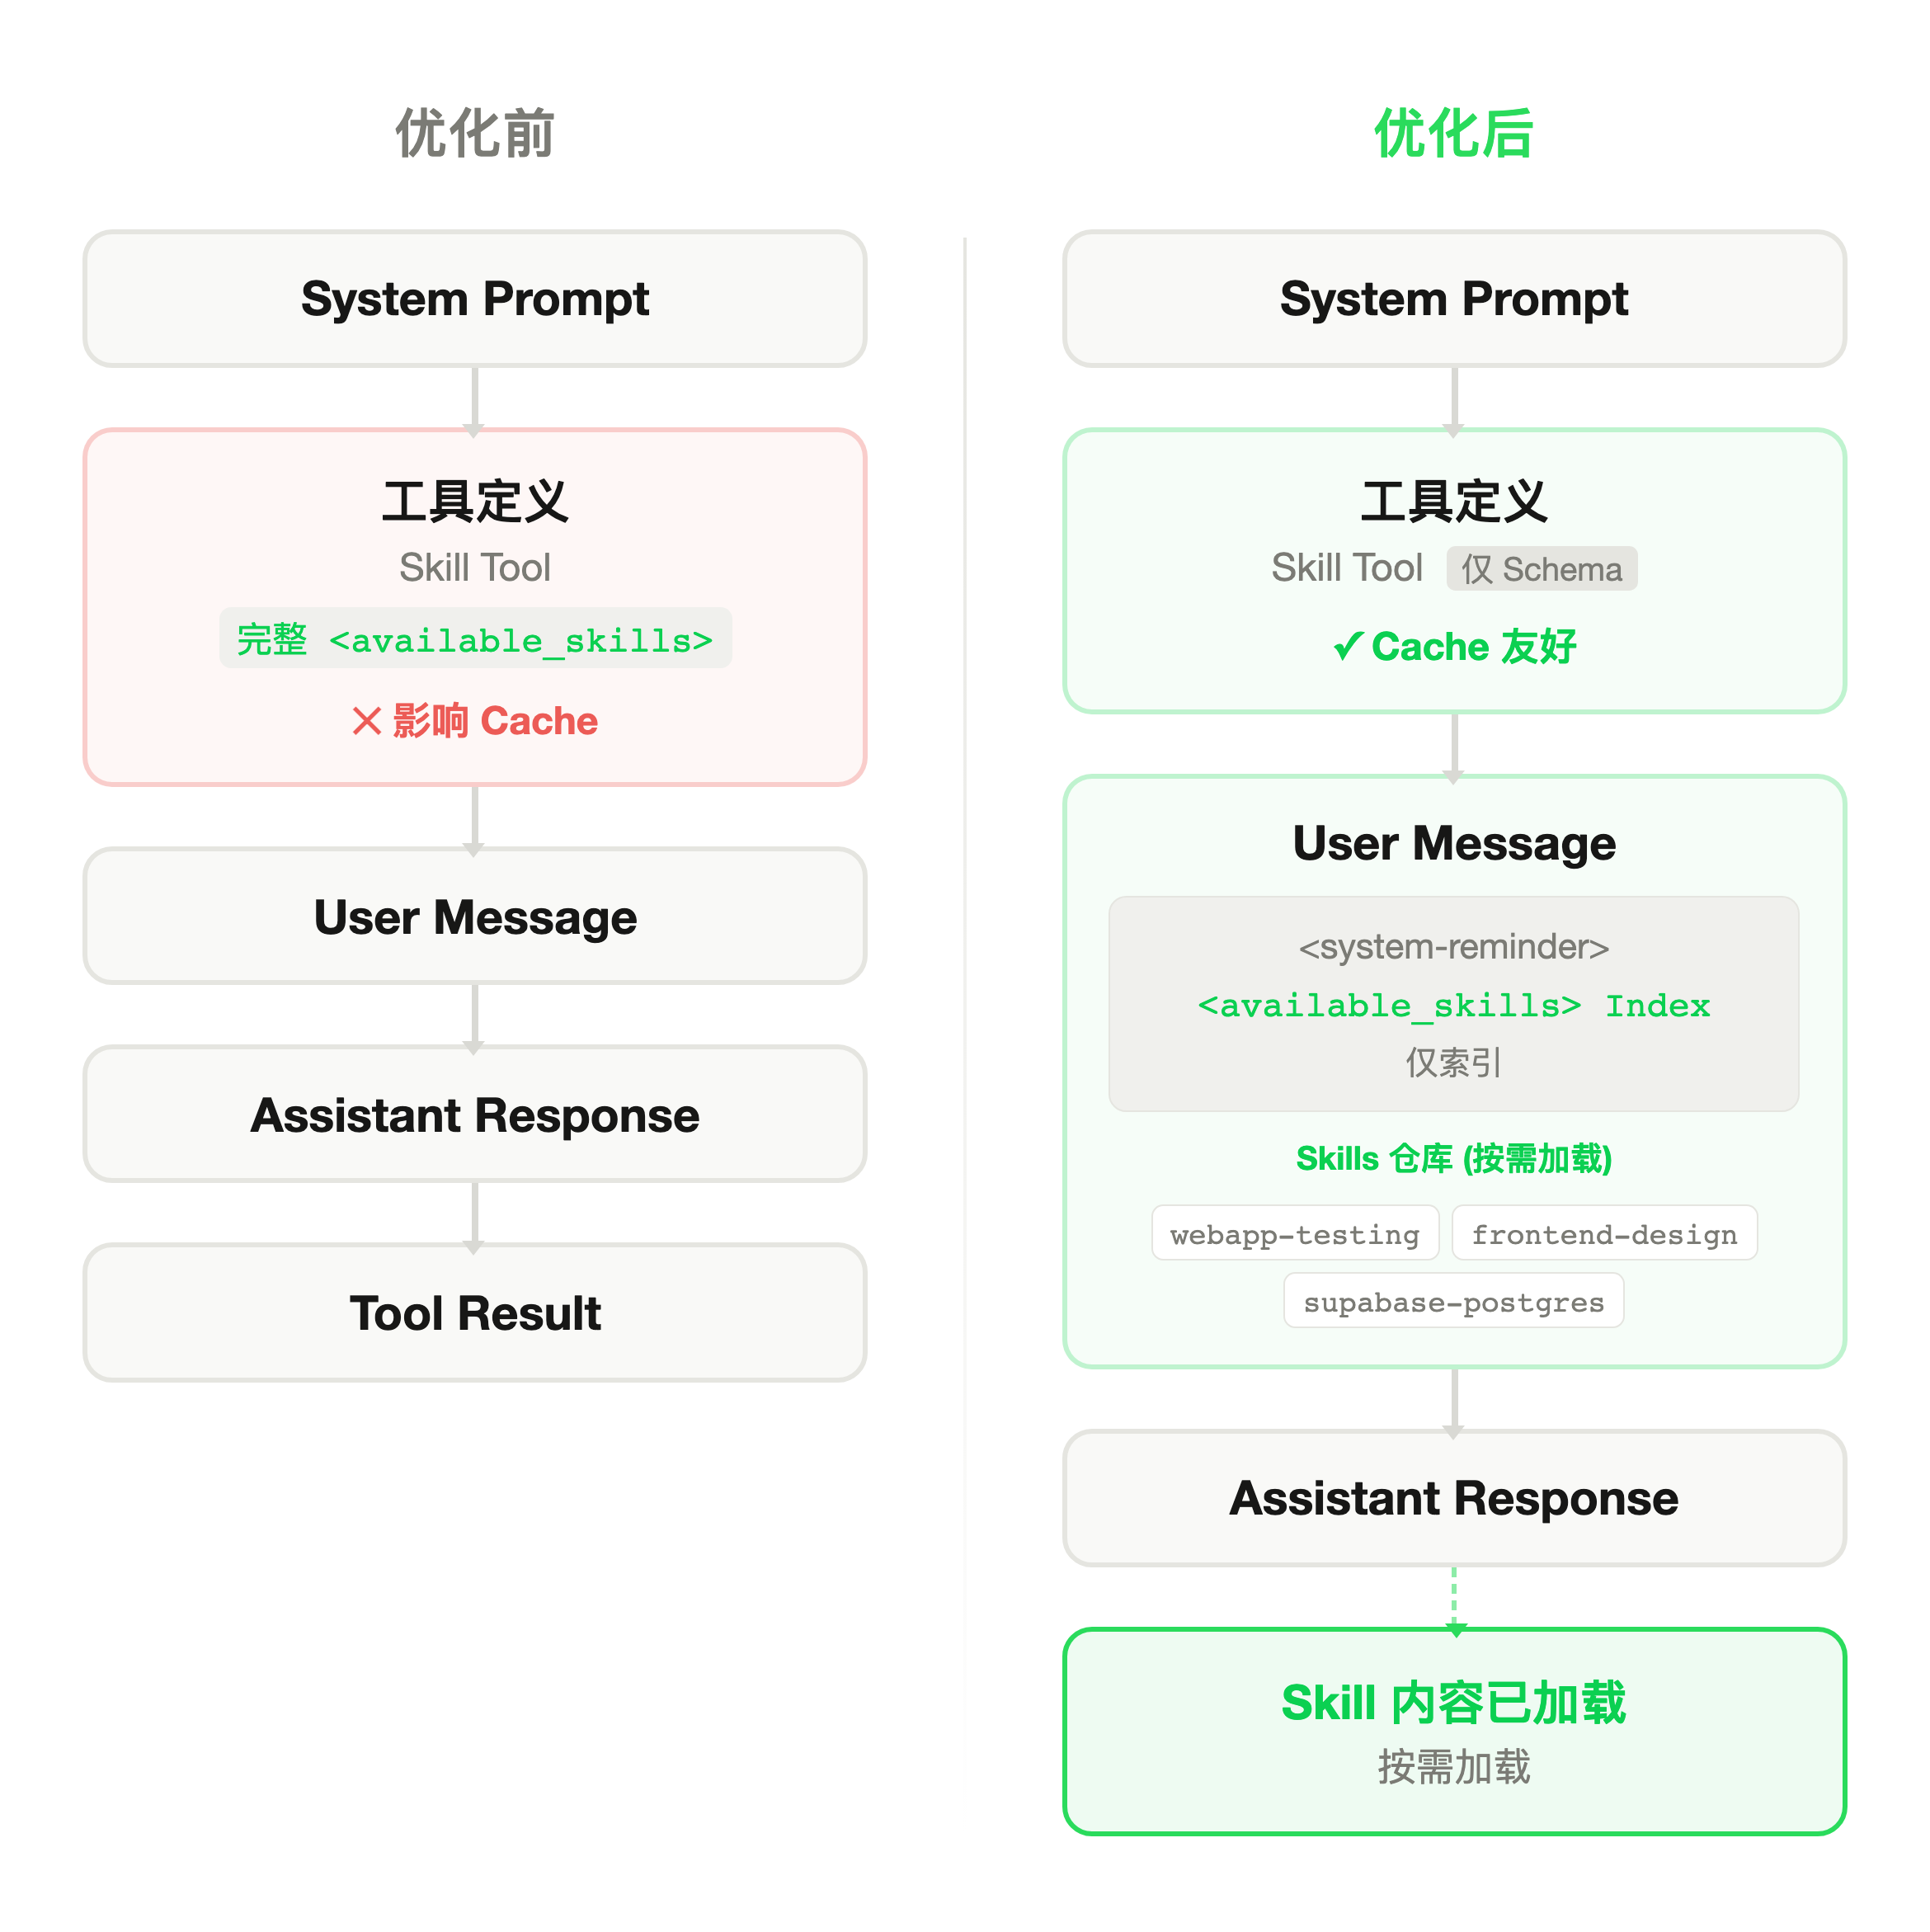 这个方案有几个约束要同时满足。索引本身要够轻,否则只是把负担从工具定义转移到索引上。一行描述要足够准确,让模型能做出正确的意图匹配。另外,注入方式要保住 Prompt Cache 命中率,所以 Tools Definition 的结构不能动,只通过 System Reminder 动态注入。
背后有个假设:模型不需要看完整定义,就能判断自己是否需要某个 Skill。告诉它"有个工具叫 X,能做 Y",它就能在合适的时机决定要不要加载。
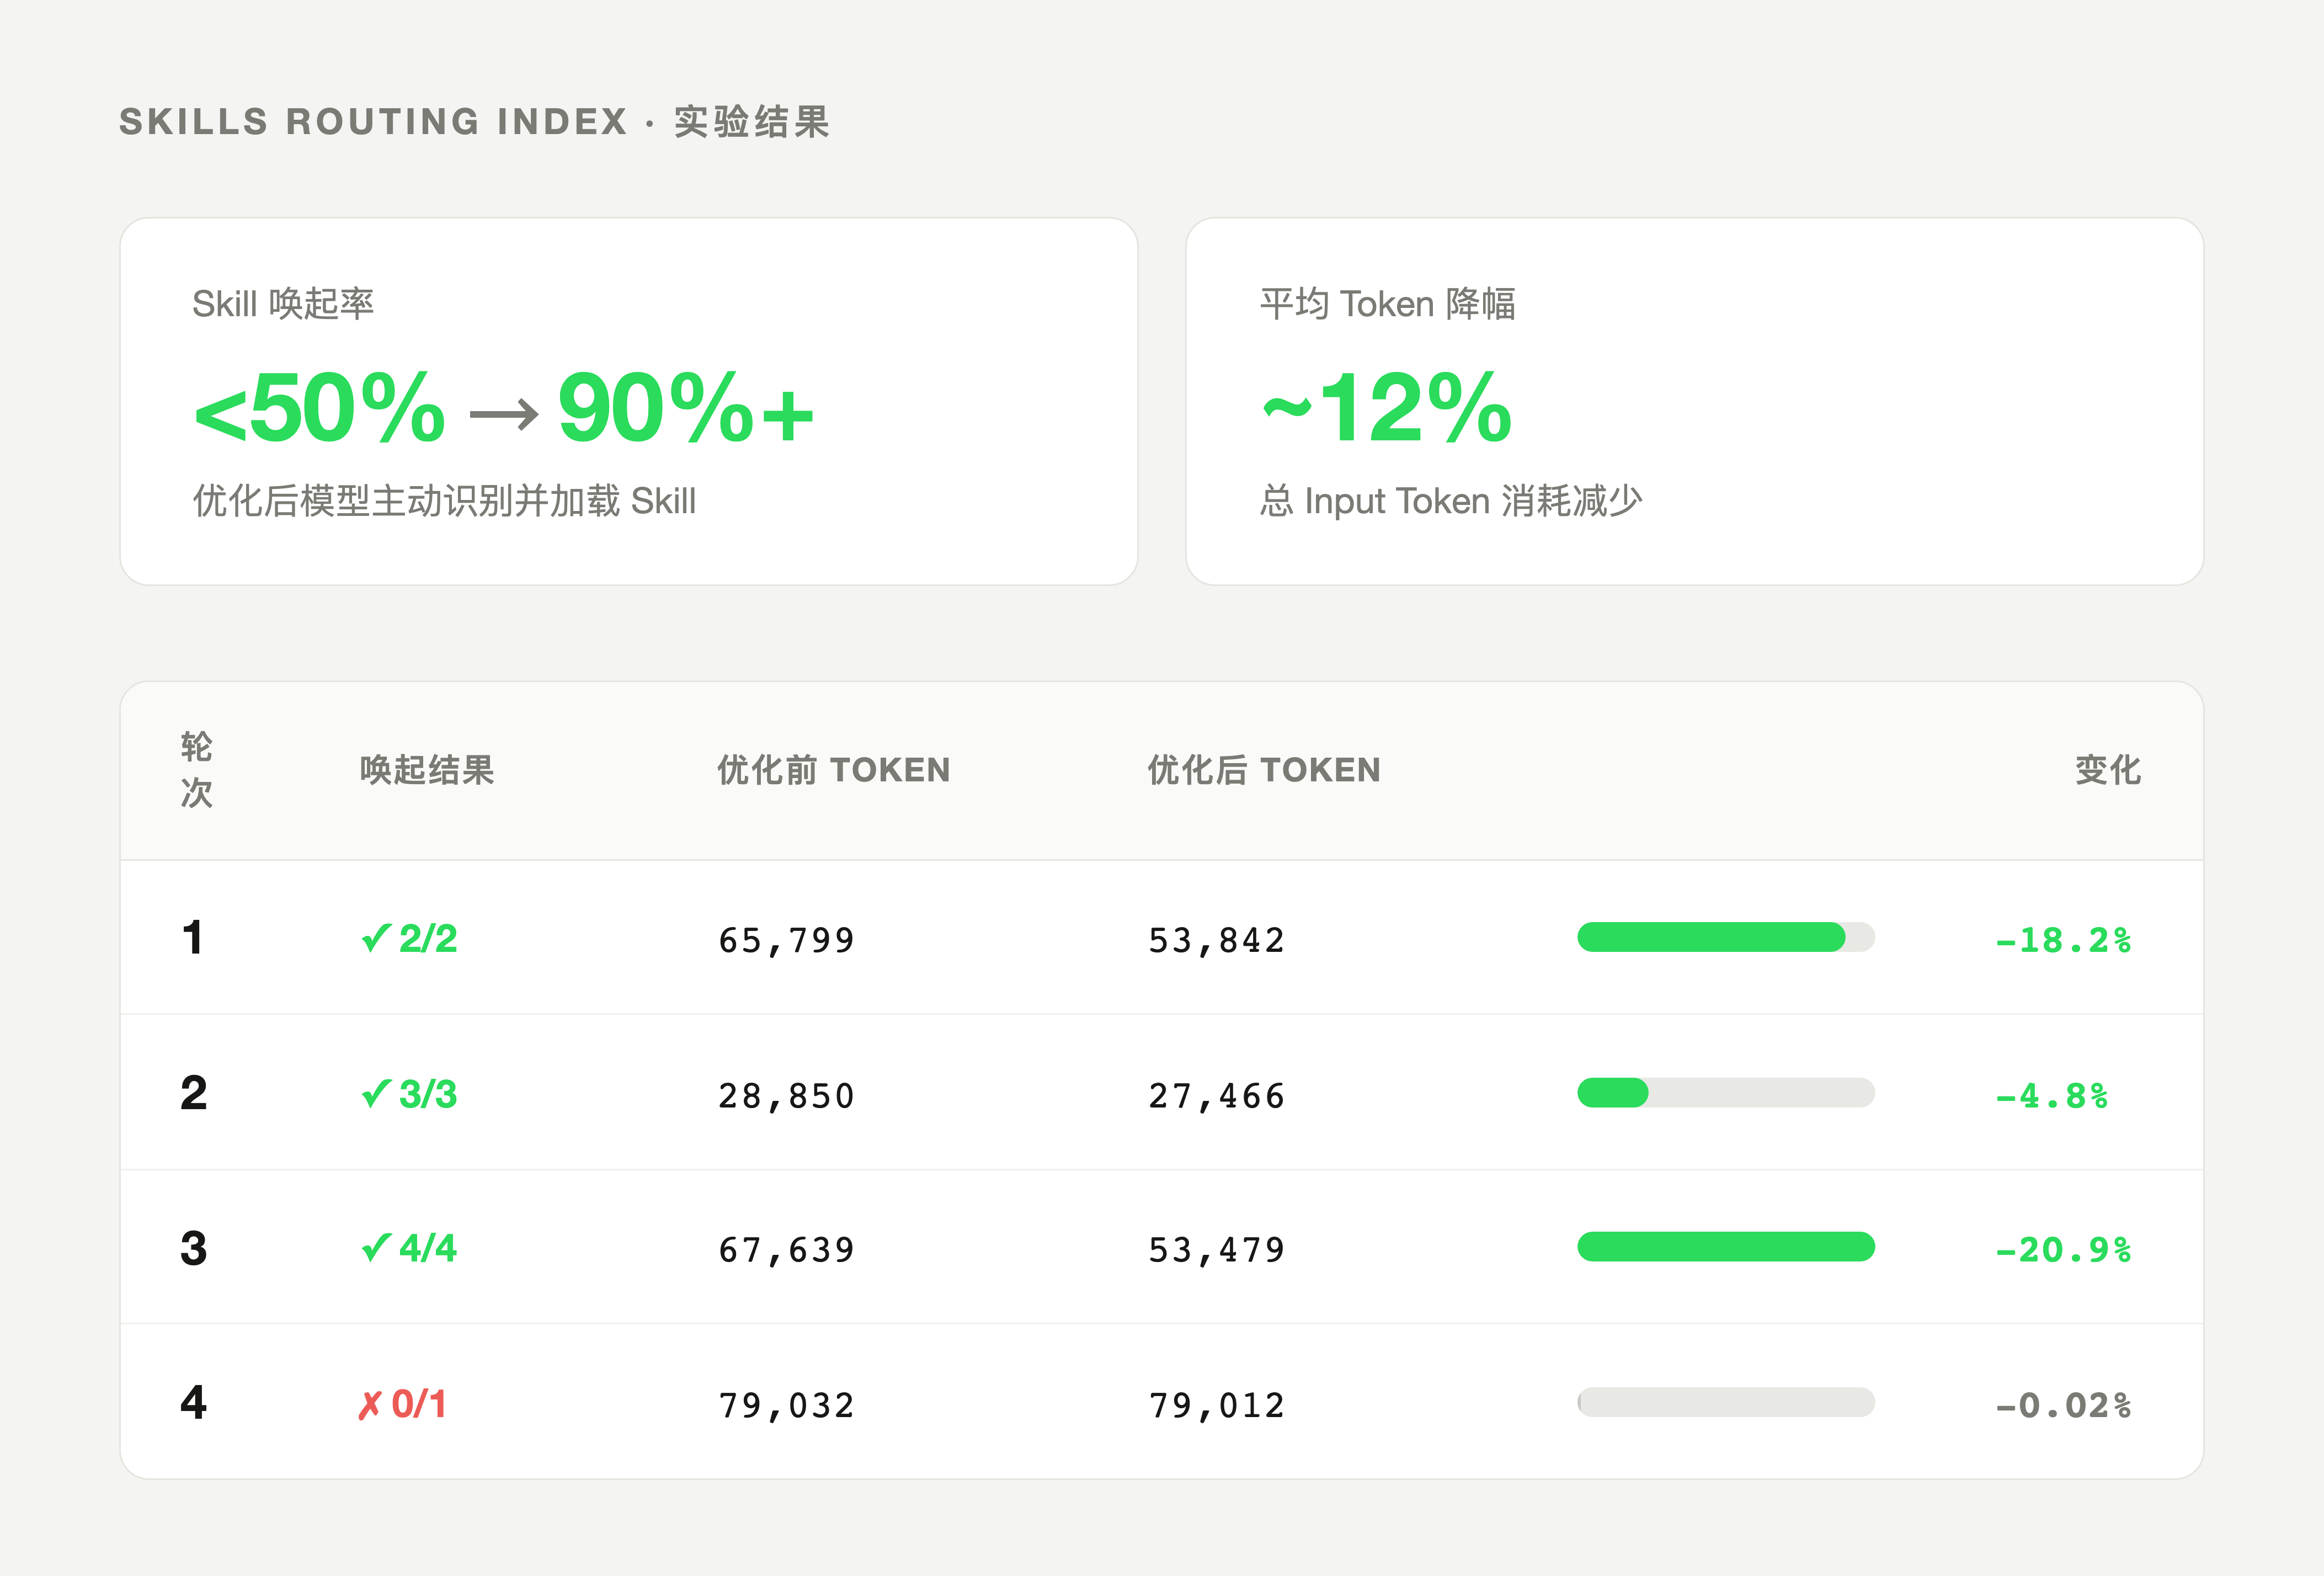
Skills 自主触发率从不到 50% 提升到 90% 以上,总 token 消耗下降了约 12%。
Skills 的经验证明了这个思路可行:轻量索引 + 按需加载,功能不打折,context 能压下来。
MCP 工具面对同样的问题,能用同样的方案吗?
理论上可以,但 MCP 多了一层复杂性。Skills 本质上是文本指令,格式宽松。MCP 工具需要精确的 JSON Schema 才能正确调用:参数名、类型、嵌套结构,缺一个字段或类型不对,调用就会失败。所以 MCP 的动态加载对"注入精度"要求更高。
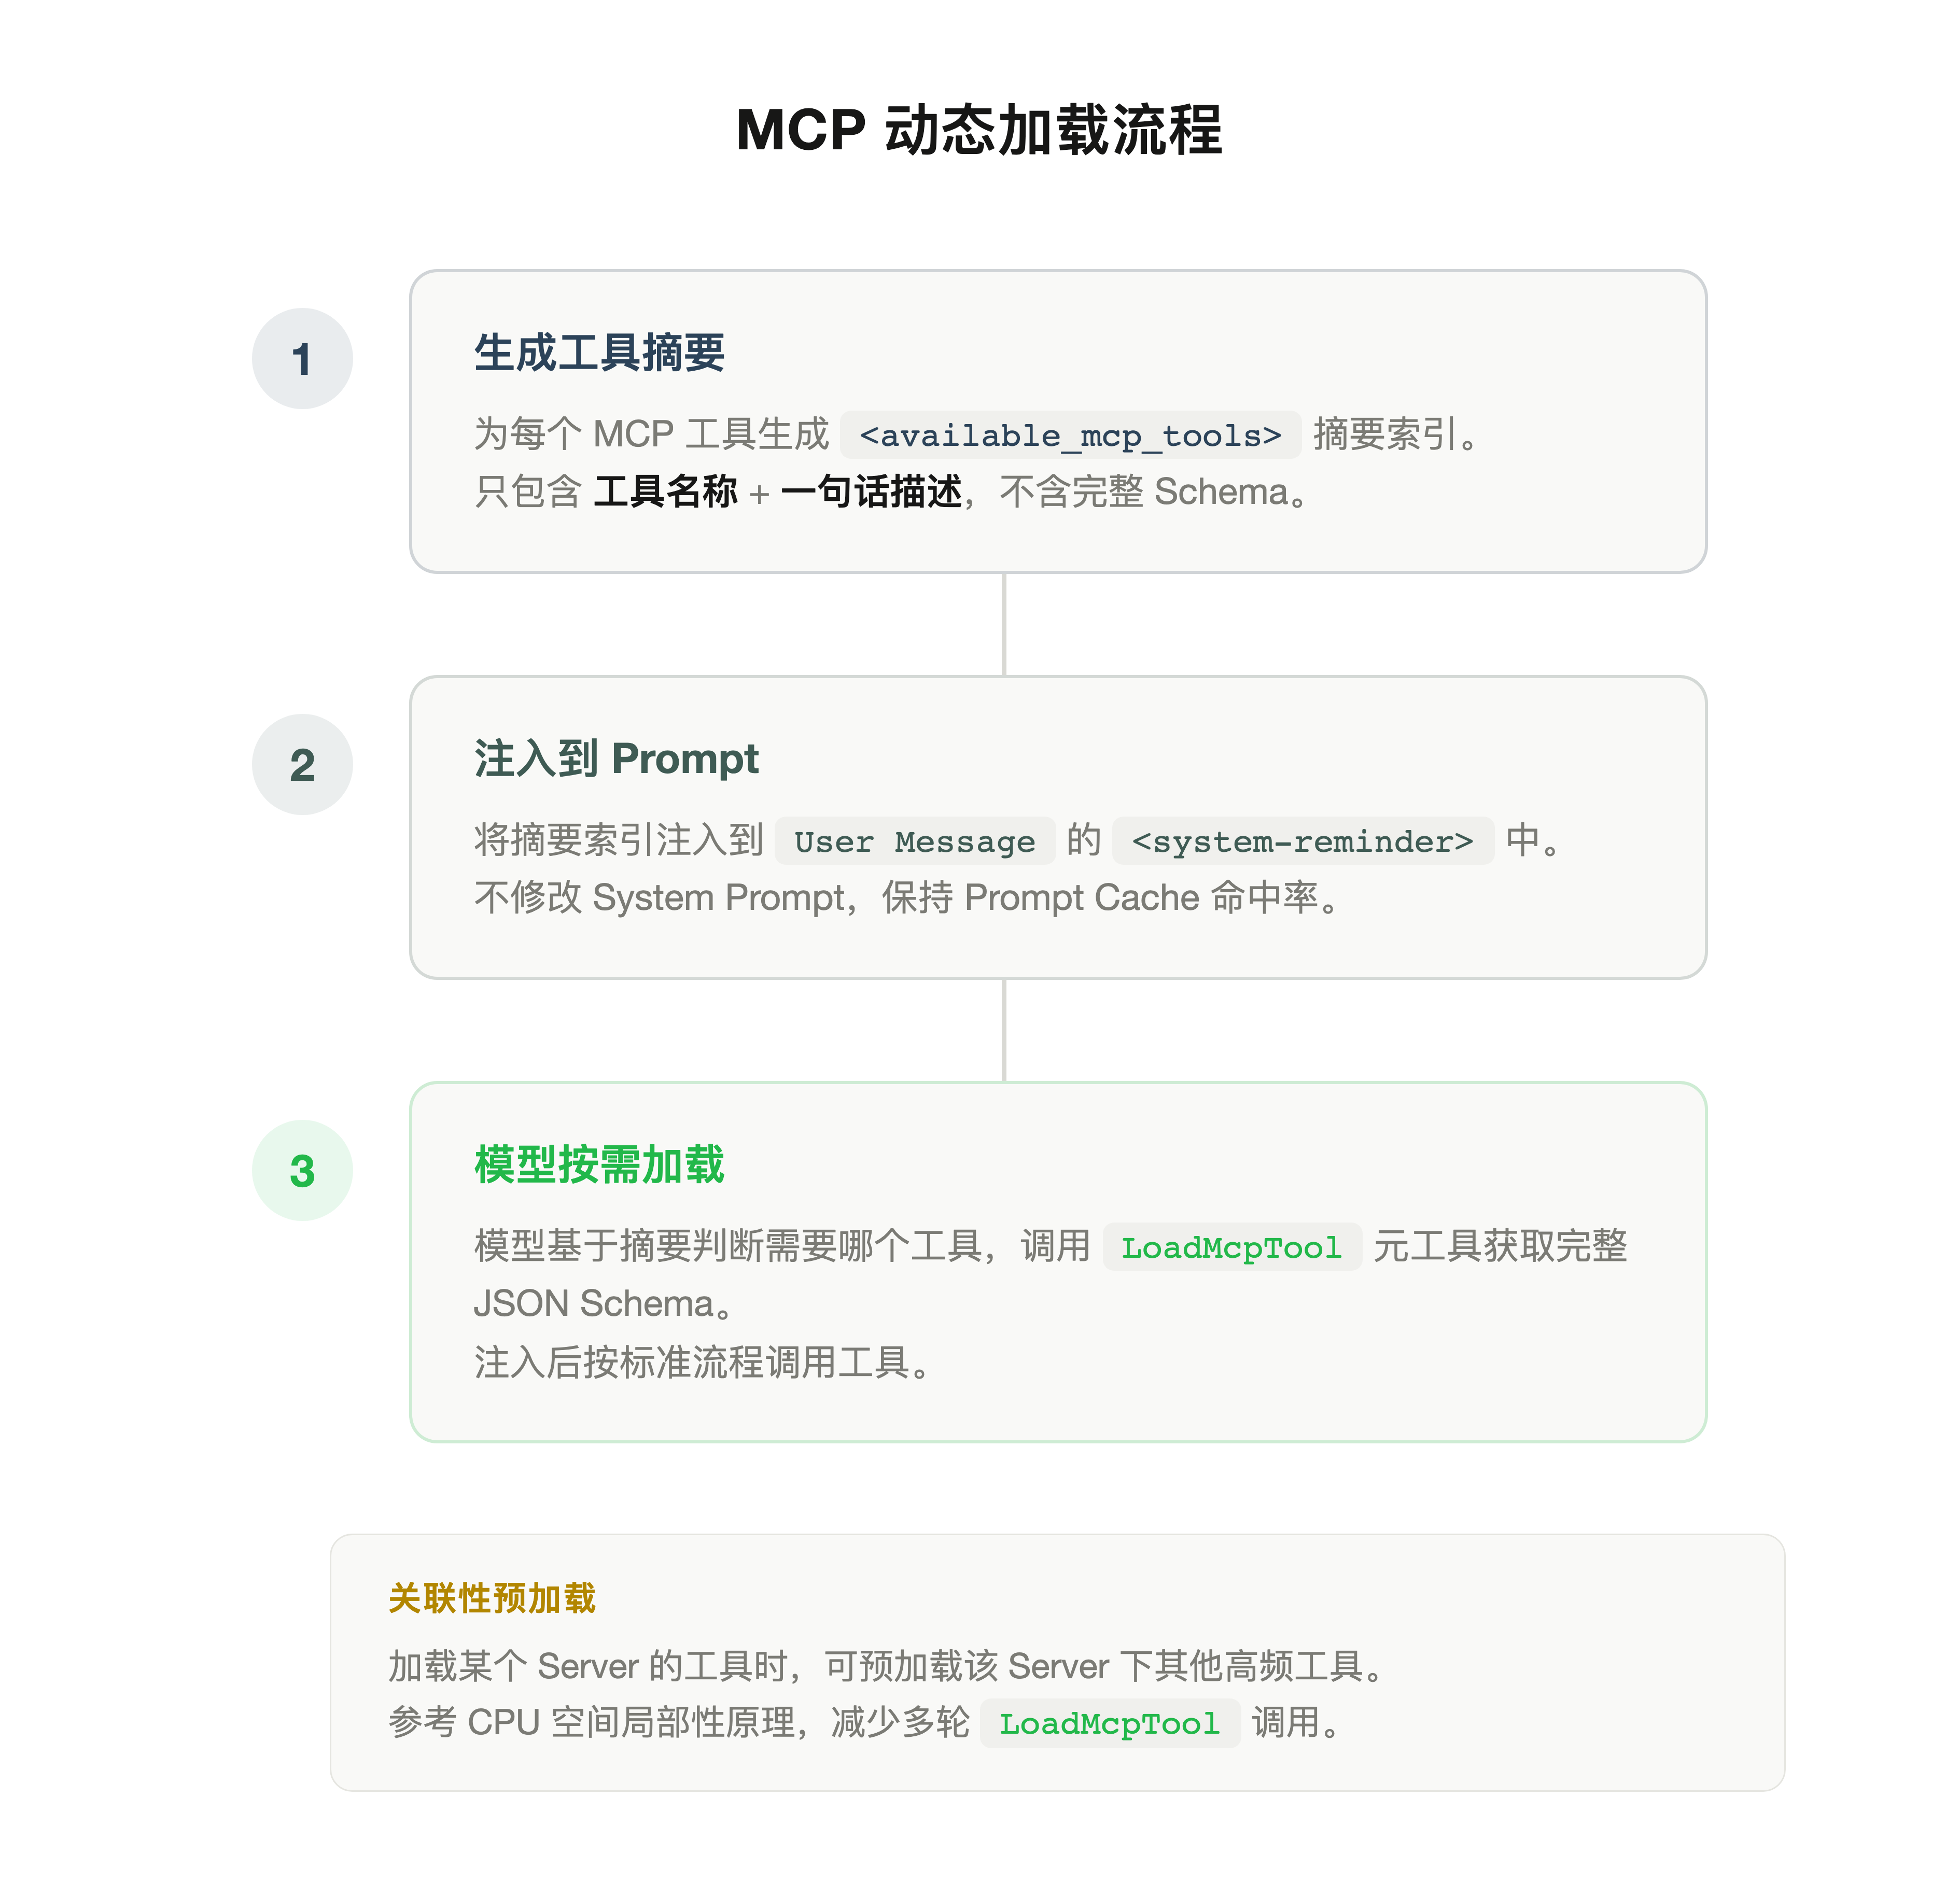 我们的方案分两个阶段。
第一步,发现:System Reminder 只展示 MCP 工具的摘要索引(名称 + 一行描述),不包含完整 Schema,和 Skills 方案一样。
第二步,注入:模型判断需要某个具体工具时,调用一个叫
有个实际问题:MCP Server 通常包含一组相关工具。比如 browser-use Server 里有 click、fill、navigate、screenshot,十几个工具。涉及浏览器操作的任务,模型往往需要其中好几个,逐一通过
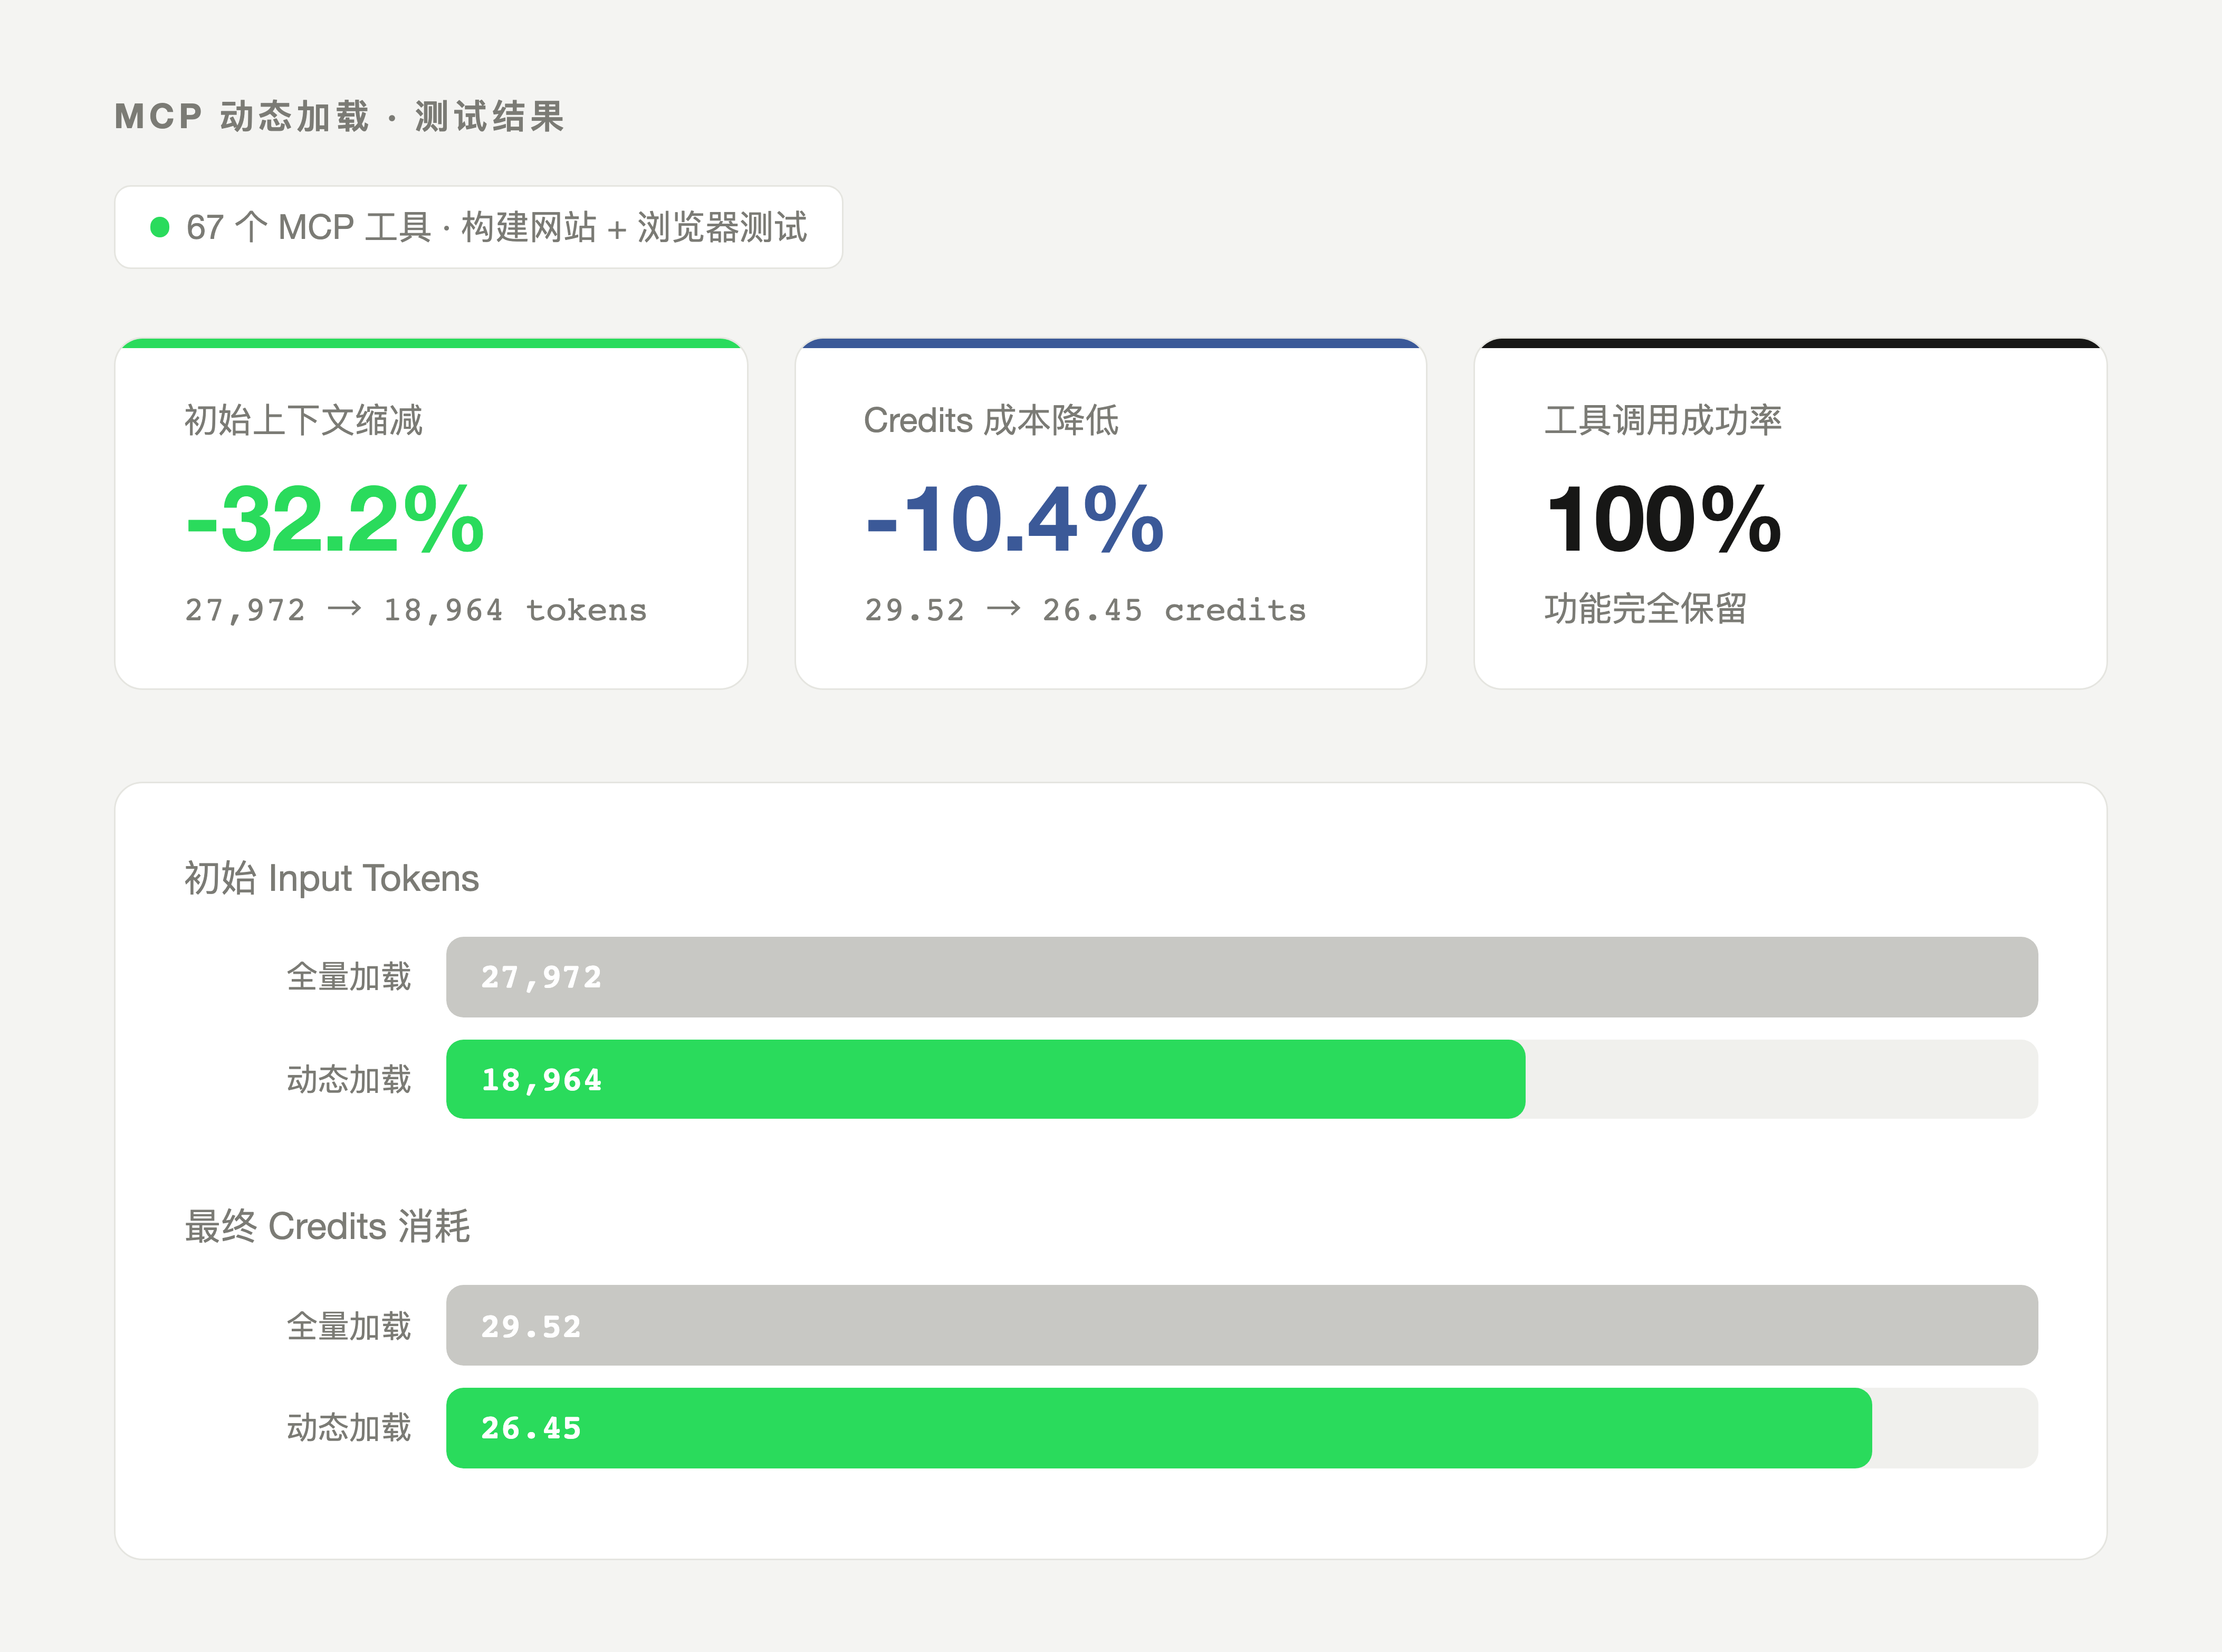
测试环境:67 个 MCP 工具。任务:构建一个网站,并用浏览器工具测试。
初始 context 减少了 32%,整体费用降低了 10.4%,MCP 工具调用成功率维持 100%。
两个优化都做完之后,我们往后退了一步,发现这是同一个解法。
1984 年,IBM 的研究员 John Carroll 提出了 Progressive Disclosure(渐进式披露):不要一次把所有功能都展示给用户。先把常用的露出来,剩下的等用到时再给。Word 的折叠菜单、Notion 的
Quest 1.0 的这两项优化已经上线,不需要改任何设置。如果你在自己搭 AI Agent,下面几点值得参考:
起因
Quest 1.0 上线后没多久,有用户反馈:一次任务把大量积分烧掉了,结果还不满意。
我们把那次对话的 token 分布数据拉出来看。12 万个 input token 里,93.5% 是工具定义。这些工具,在整次任务中一次都没被调用过。
这是个极端案例,那个用户挂载了好几个 MCP Server。但它暴露了一个普遍问题:context 里堆满了"以防万一"的工具定义,大多数时候根本用不着。
我们团队里有人之前配置了 playwright-mcp 做前端自动化测试,测试结束后就再没碰过。它的工具定义还是在每次对话的 context 里出现,没人注意到,一放就是几周。
做了个对照实验:同样的任务,一组挂载两个 MCP Server(全程没用到),一组完全不挂。只是挂在那里,积分消耗就多了 10% 以上。两个 MCP Server 贡献了将近一百条工具定义,消耗接近 2000 个 token。
内部做了个小调查:80% 的同事至少配置了一个 MCP Server,但实际使用频率不足 10%。
问题摆在那里:不想删工具,但不能让它们一直占着 context,怎么办?
从 Skills 优化中找到思路
解决 MCP 之前,我们在另一个功能上已经碰过类似的墙:Skills。
Quest 的 Skills 功能让用户定义专项知识和工作流,Agent 按需加载。但用户反映 Skills 的自动触发率很低,经常需要手动输入 /skills 才能用到。
我们在 28 个 Skills 的环境下测了一下:模型的自主触发率不到 50%。
触发率为什么低?
模型调用 Skills 需要完成三件事:
- 理解当前任务需要什么能力(意图识别)
- 在已知 Skills 列表中找到匹配的那个(能力匹配)
- 判断什么时候加载、怎么用(时机判断)
Skills 路由索引
我们的做法:在 System Reminder 里放一个轻量级的 Skills 索引,而不是完整定义。
索引里只有每个 Skill 的名称和一行描述,几百个 token。模型用这个索引做意图匹配,判断需要某个 Skill 的时候,再通过索引去定位和加载完整内容。
结果
Skills 自主触发率从不到 50% 提升到 90% 以上,总 token 消耗下降了约 12%。
| Round | Invoked / Should Invoke | Pre-optimization Input Tokens | Post-optimization Input Tokens | Reduction |
|---|---|---|---|---|
| 1 | 2/2 | 65,799 | 53,842 | 18.2% |
| 2 | 3/3 | 28,850 | 27,466 | 4.8% |
| 3 | 4/4 | 67,639 | 53,479 | 20.9% |
| 4 | 0/1 | 79,032 | 79,012 | 0.02% |
Round 4 失败值得单独说:那次任务需要的 Skill,和它在索引里的描述相似度太低,模型没有识别出来。索引质量比我们预想的要重要得多。一行描述写偏了,按需加载就永远不会触发。
扩展到 MCP:动态加载
Skills 的经验证明了这个思路可行:轻量索引 + 按需加载,功能不打折,context 能压下来。
MCP 工具面对同样的问题,能用同样的方案吗?
理论上可以,但 MCP 多了一层复杂性。Skills 本质上是文本指令,格式宽松。MCP 工具需要精确的 JSON Schema 才能正确调用:参数名、类型、嵌套结构,缺一个字段或类型不对,调用就会失败。所以 MCP 的动态加载对"注入精度"要求更高。
LoadMcpTool 的元工具,后者把该工具的完整 JSON Schema 动态注入当前 context。注入完成后,模型按正常流程调用工具。
LoadMcpTool 本身是个轻量工具,Schema 始终在 context 里(只占几十个 token)。它是入口:模型用它把其他工具的完整定义"拉"进来。
初始 context 只有摘要索引,需要时注入完整 Schema(不做任何简化),模型调用时看到的始终是完整的定义。
关联预加载
有个实际问题:MCP Server 通常包含一组相关工具。比如 browser-use Server 里有 click、fill、navigate、screenshot,十几个工具。涉及浏览器操作的任务,模型往往需要其中好几个,逐一通过 LoadMcpTool 加载会产生多轮调用开销。
借鉴 CPU 缓存里的空间局部性原理:模型加载某个 Server 里的任意工具时,顺带把同一 Server 里最常用的几个工具也预加载进来。原本需要多次 LoadMcpTool 调用的浏览器任务,现在通常只触发一次。
测试结果
测试环境:67 个 MCP 工具。任务:构建一个网站,并用浏览器工具测试。
初始 context 减少了 32%,整体费用降低了 10.4%,MCP 工具调用成功率维持 100%。
| Metric | Full Loading | Dynamic Loading | Change |
|---|---|---|---|
| Initial Input Tokens | 27,972 | 18,964 | 32.2% |
| Final Credits Consumed | 29.52 | 26.45 | 10.4% |
| MCP Tool Call Success Rate | 100% | 100% | No change |
回头看:这其实是渐进式披露
两个优化都做完之后,我们往后退了一步,发现这是同一个解法。
1984 年,IBM 的研究员 John Carroll 提出了 Progressive Disclosure(渐进式披露):不要一次把所有功能都展示给用户。先把常用的露出来,剩下的等用到时再给。Word 的折叠菜单、Notion 的 / 命令、iOS 的多层设置,都是这个原则在 UI 上的体现。
我们对 context window 做的是同一件事。轻量索引放在前面,让模型知道有什么可用;完整定义只在需要时加载。"用户"是 AI 模型,"界面"是 context,但问题本质一样:功能要全,信息量要小,怎么两头都顾到。
Carroll 在 1984 年用命令菜单解决这个问题,我们在四十年后用 JSON Schema 解决了同一个问题。
给 Agent 开发者的参考
Quest 1.0 的这两项优化已经上线,不需要改任何设置。如果你在自己搭 AI Agent,下面几点值得参考:
- 跑一下 context 的 token 分布分析,你可能会发现大头是从来没被调用过的工具定义。
- 意图匹配不需要完整定义,模型从简短描述就能判断需不需要某个工具。
- 索引质量决定上限。一行描述写得不准,就没有匹配。
- 动态内容放 System Reminder,不要放 System Prompt,这样不会破坏 Prompt Cache 的命中率。
- 动态注入完成后,跑一遍完整的工具调用测试。索引描述写偏了不会有任何报错,只会安静地不触发。