
Qoder Fast 快速档位上线:生成速度提升超150%,Token消耗减少27%
返回
 为什么模型输出更快,任务却不一定更快完成?为什么 Qoder 要做 Fast 档位,而不只是给每个模型加一个快速开关?这篇文章把 Fast 的适用场景、加速机制和初步测试结果,一次讲清楚。
给模型加一个快速开关,解决的是一个明确问题:用户已经选好模型,希望它响应得更快。
但很多用户的起点是“我想快速试一下这个想法”。他们还没有选模型,也不想先研究各个模型的速度变体、思考参数和版本差异。
Fast 想往前多走一步:让用户可以一键选择最适合当前任务的整体体验。
因此, Fast不仅是一个模型选择,而是通过模型组合、Agent优化、网络链路的三层综合优化带来的模式变化。
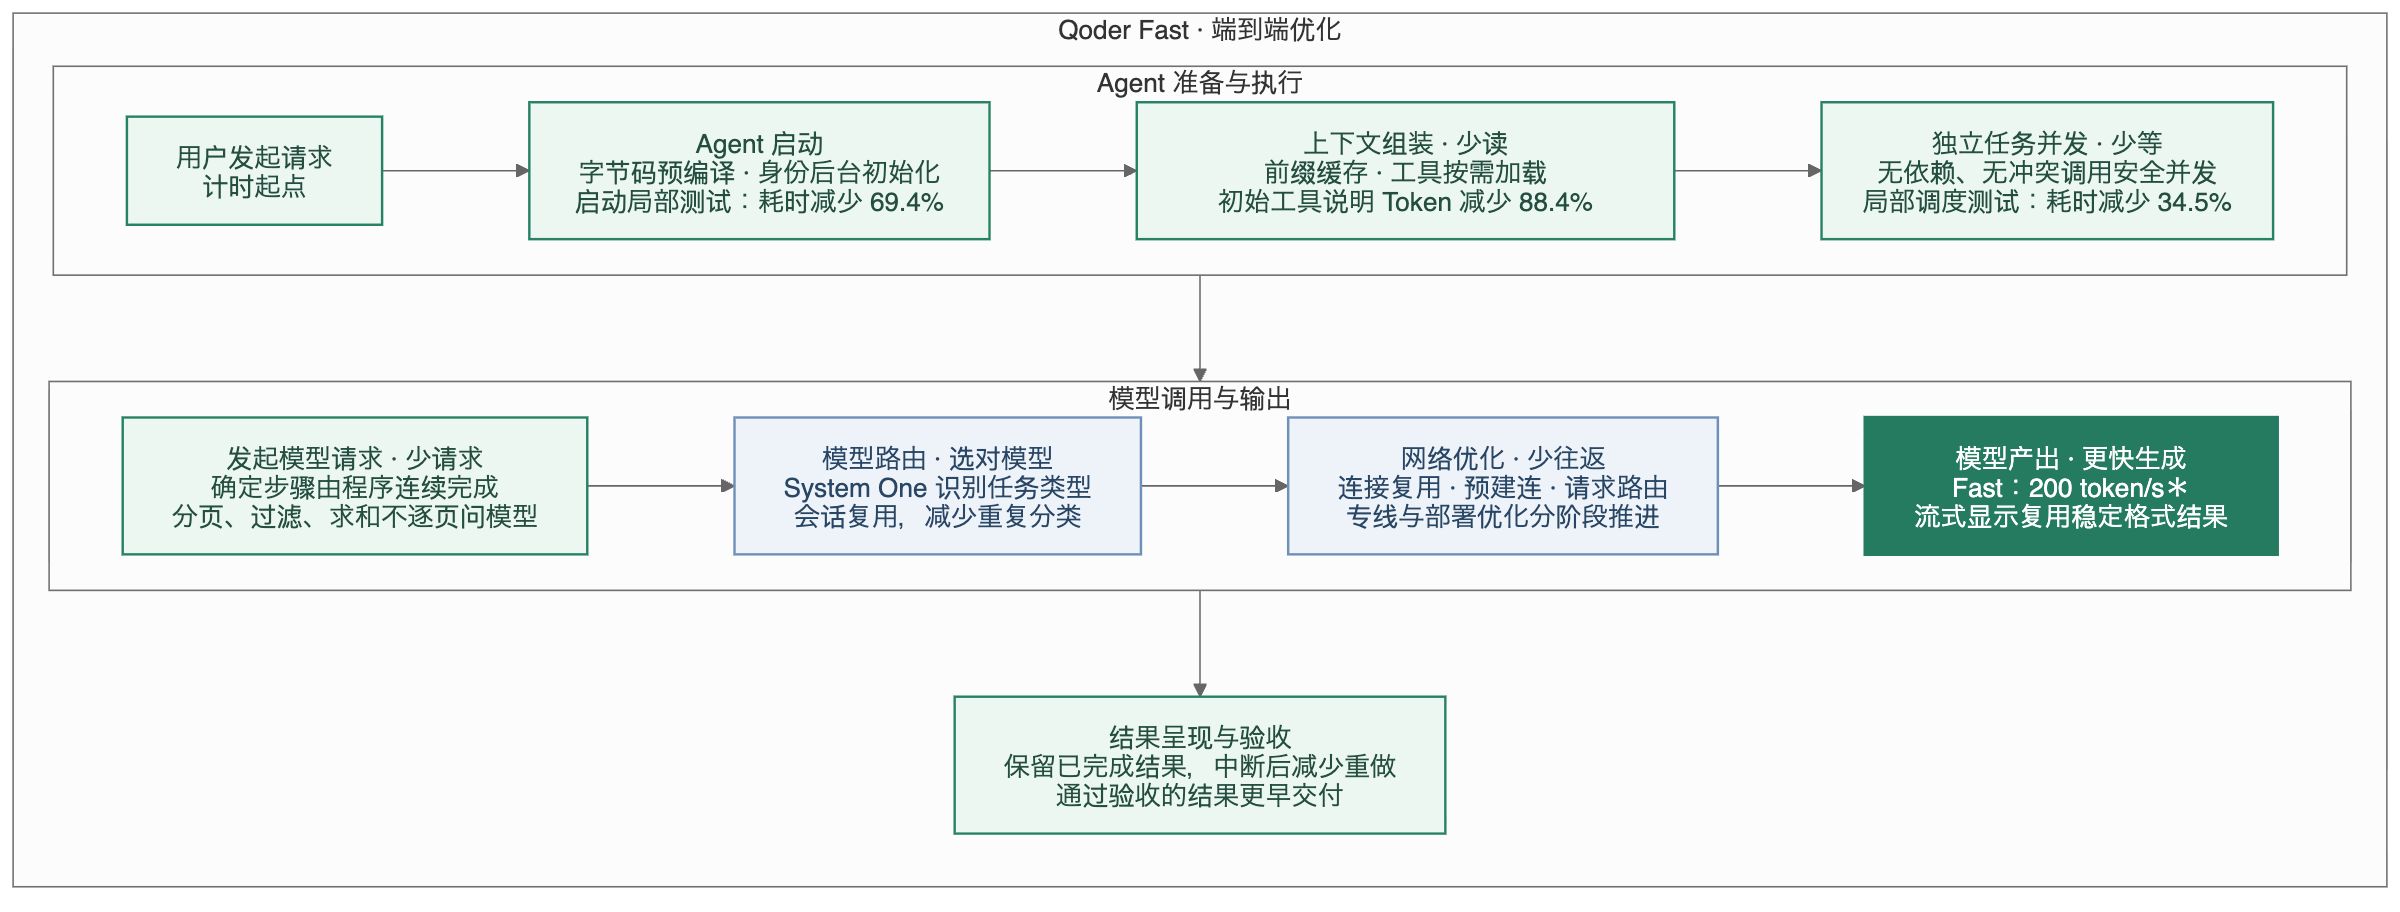
模型输出速度只影响任务的一部分。一次任务的完整链路还要准备上下文、发起多轮请求、调用工具、处理返回结果,并经过网络传输,所以即使是一样的模型,在不同的产品上依然会有不同的耗时表现,全链路来看:
下面用一条简化的 Profile 链路,说明各项优化发生在哪里:
“解释这段函数为什么报错”和“重构这个模块的依赖关系”,都与代码有关,但需要的能力并不相同。前者重在快速理解和清楚解释,后者需要处理跨文件影响,并验证修改结果。
Fast 围绕任务类型引入路由模型对当前任务进行结构化识别,区分代码解释、代码修改、重构、测试或架构设计等类型,再由路由根据任务类型调整候选模型的优先级。在满足能力要求的前提下,选择更适合当前任务的模型。
Harness 是 Qoder 智能体背后的执行引擎,负责组织模型请求、工具调用、上下文管理与多轮执行。模型选定之后,怎么把任务跑完,由这一层组织。
请求从用户端抵达模型,需要经过域名解析、连接建立、安全握手和请求路由等环节。通过对这些链路的逐项优化和调整,我们希望不仅提高 FAST的档位速度,更能减少偶发的长等待,让用户少遇到“同样一个小任务,这次为什么特别慢”的情况,让相似任务的体验更可预期。
工作和生活中的很多任务并不是始终沿着一份确定的计划前进。很多时候,我们是在提问、尝试、观察和修改中,把想法逐渐变成产品,或产出。而很多时候提出一轮修改只花几十秒,等结果却要更久,人就容易切去处理别的事。回来以后,还要重新想起:刚才改了什么、准备检查哪里、下一步要试什么。
因此,Fast 希望缩短这段间隔,让反馈接得住当前的思路。以做一个“今天午饭吃什么”的小工具为例,有三个适合使用 Fast 的阶段。
一开始,你不需要一份完整的产品方案,只需要有人接住想法,帮你继续往下想:“每天午饭不知道吃什么,有没有有趣的做法?”、“不想填很多偏好呢?”、“如果是几位同事一起呢?”
几轮短问短答后,随机转盘、按预算推荐、同事投票三个方向浮现出来。每次回答只需要支持下一步判断。反馈来得及时,就能顺着上一个问题继续追问,保持探索的心流。
有了方向,下一步的目标不是一次做出三个完整产品,而是用足够小、足够明确的原型,帮助验证哪个才是值得继续的方向。亲手转一下转盘、调一下预算、投一票,更容易判断哪个方向值得继续。趁体验还清晰,再补一句“投票版直接显示大家的选择”,就能进入下一轮验证。Fast 的价值,是降低从想法到第一次验证之间的等待与门槛。
完整版本运行起来后,Fast可以是响应你反复打磨的最佳乙方:“发起投票压缩到一屏。”“突出显示票数最高的餐厅。”“按钮改成‘就吃这家’。”你可以对着预览连续修改、连续检查,把注意力留在眼前的细节上。
我们选取了十项适合 Fast 场景的通用任务,在每个测试配置下各运行三次,对比产出质量、耗时和输出速度。
Fast 的产品化还有一个目标:让用户能按任务分配资源,获得更稳定、可控的结果。
输出了多少 Token、每秒生成多少 Token,都不能单独说明任务效率。模型多跑几轮、携带更多无关上下文、反复调用相同工具,都可能增加资源消耗,也拉长等待。
Token Efficiency 关注的是:完成符合要求的任务,需要投入多少资源。对应到 Fast,有三件事:
为什么是 Fast 档位,而不是给每个模型加一个快速开关
给模型加一个快速开关,解决的是一个明确问题:用户已经选好模型,希望它响应得更快。
但很多用户的起点是“我想快速试一下这个想法”。他们还没有选模型,也不想先研究各个模型的速度变体、思考参数和版本差异。
Fast 想往前多走一步:让用户可以一键选择最适合当前任务的整体体验。
因此, Fast不仅是一个模型选择,而是通过模型组合、Agent优化、网络链路的三层综合优化带来的模式变化。
具体做了什么来让Fast变快
模型输出速度只影响任务的一部分。一次任务的完整链路还要准备上下文、发起多轮请求、调用工具、处理返回结果,并经过网络传输,所以即使是一样的模型,在不同的产品上依然会有不同的耗时表现,全链路来看:
| 环节 | 哪些情况会增加等待 |
|---|---|
| 模型选择与请求 | 模型与任务不匹配;已经确定的步骤仍反复请求模型判断 |
| 上下文处理 | 每轮携带过多输入;可复用的内容重复计算 |
| 工具执行 | 独立操作串行等待;失败后反复重试 |
| 网络链路 | 建连、传输和路由增加开销,偶发延迟拉长任务 |
1. 模型层:先理解任务,再选择模型
“解释这段函数为什么报错”和“重构这个模块的依赖关系”,都与代码有关,但需要的能力并不相同。前者重在快速理解和清楚解释,后者需要处理跨文件影响,并验证修改结果。
Fast 围绕任务类型引入路由模型对当前任务进行结构化识别,区分代码解释、代码修改、重构、测试或架构设计等类型,再由路由根据任务类型调整候选模型的优先级。在满足能力要求的前提下,选择更适合当前任务的模型。
2. Agent 层:让执行引擎少做无效工作
Harness 是 Qoder 智能体背后的执行引擎,负责组织模型请求、工具调用、上下文管理与多轮执行。模型选定之后,怎么把任务跑完,由这一层组织。
- 模型请求:确定的步骤,交给程序连续完成,减少冗余步骤
- 上下文组装:复用已有输入,按需加载工具。
- 独立任务并发:让可并行的任务同步推进,减少等待
3. 网络层:缩短往返,也减少波动
请求从用户端抵达模型,需要经过域名解析、连接建立、安全握手和请求路由等环节。通过对这些链路的逐项优化和调整,我们希望不仅提高 FAST的档位速度,更能减少偶发的长等待,让用户少遇到“同样一个小任务,这次为什么特别慢”的情况,让相似任务的体验更可预期。
什么时候适合用 Fast:少一点等待,多一次尝试
工作和生活中的很多任务并不是始终沿着一份确定的计划前进。很多时候,我们是在提问、尝试、观察和修改中,把想法逐渐变成产品,或产出。而很多时候提出一轮修改只花几十秒,等结果却要更久,人就容易切去处理别的事。回来以后,还要重新想起:刚才改了什么、准备检查哪里、下一步要试什么。
因此,Fast 希望缩短这段间隔,让反馈接得住当前的思路。以做一个“今天午饭吃什么”的小工具为例,有三个适合使用 Fast 的阶段。
1.灵感碰撞:快问快答,找到方向
一开始,你不需要一份完整的产品方案,只需要有人接住想法,帮你继续往下想:“每天午饭不知道吃什么,有没有有趣的做法?”、“不想填很多偏好呢?”、“如果是几位同事一起呢?”
几轮短问短答后,随机转盘、按预算推荐、同事投票三个方向浮现出来。每次回答只需要支持下一步判断。反馈来得及时,就能顺着上一个问题继续追问,保持探索的心流。
2.想法试选:不只讨论,每个做一版
有了方向,下一步的目标不是一次做出三个完整产品,而是用足够小、足够明确的原型,帮助验证哪个才是值得继续的方向。亲手转一下转盘、调一下预算、投一票,更容易判断哪个方向值得继续。趁体验还清晰,再补一句“投票版直接显示大家的选择”,就能进入下一轮验证。Fast 的价值,是降低从想法到第一次验证之间的等待与门槛。
3.深入做成,再快速打磨:从能试到好用
完整版本运行起来后,Fast可以是响应你反复打磨的最佳乙方:“发起投票压缩到一屏。”“突出显示票数最高的餐厅。”“按钮改成‘就吃这家’。”你可以对着预览连续修改、连续检查,把注意力留在眼前的细节上。
初步结果:速度收益与完成率
我们选取了十项适合 Fast 场景的通用任务,在每个测试配置下各运行三次,对比产出质量、耗时和输出速度。
- 产出质量:满分5分,Fast档位平均得分4.94,Performance档位平均得分4.93,基本持平
- 耗时对比:Fast 的端到端任务完成时间约为Auto档位的50%,对比友商,约为其它Agent产品Fast 档位耗时的 1/3~1/2。输出速度较原先performance提升了152%,约为友商Agent产品普通模式的3倍。
从模型选择,走向可预期的产品服务
Fast 的产品化还有一个目标:让用户能按任务分配资源,获得更稳定、可控的结果。
输出了多少 Token、每秒生成多少 Token,都不能单独说明任务效率。模型多跑几轮、携带更多无关上下文、反复调用相同工具,都可能增加资源消耗,也拉长等待。
Token Efficiency 关注的是:完成符合要求的任务,需要投入多少资源。对应到 Fast,有三件事:
- 按任务选档位。 快速验证和局部修改交给 Fast,需要深入处理时再投入更强的能力。
- 减少无效消耗。 复用上下文,按需加载工具,让程序连续完成确定的操作,减少重复请求。
- 按完整任务验收。 同时观察质量、完成率、耗时和资源用量,避免局部加速带来更多返工。