
从“代码补全”到“编辑预测”,解读背后Qoder NEXT 模型能力及优势
返回
当你按下键盘等待代码补全时,你能容忍多长时间的延迟?
人机交互研究表明:100ms 是"即时响应"的边界,400ms 是生产力下降的拐点,超过 1 秒则会让用户烦躁。
代码补全场景对延迟更为敏感——高频触发、心流易断、与手动输入竞争。我们据此将体验分为四个等级:
为什么目标是 300ms? 用户打字间隔约 200-400ms,300ms 内返回可确保在下一次击键前展示结果,同时为网络波动预留缓冲。
然而,要在 300ms 内完成上下文收集、模型推理、首包生成、结果排序、UI 渲染,挑战巨大。本文将揭秘 Qoder NEXT 如何通过端到端优化,实现毫秒级代码补全体验。
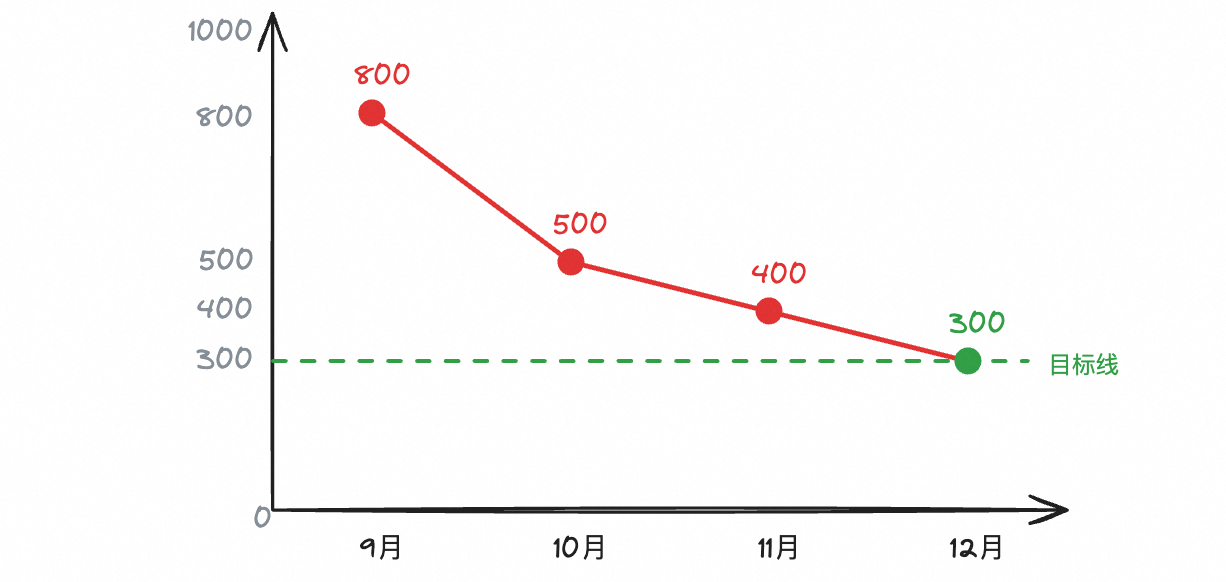
在深入技术细节之前,先展示我们的优化成果:从 800ms 到 300ms,成功突破 300ms 的体验红线。
首Action与首 Token的区别在于:首 Token 是模型生成的第一个 token,而首 Action 是第一个语义完整、可供用户采纳的代码片段。首 Action 可能包含多个 token,但它是用户真正关心的"第一个有意义的结果"。
首 Action 具备的核心特点:
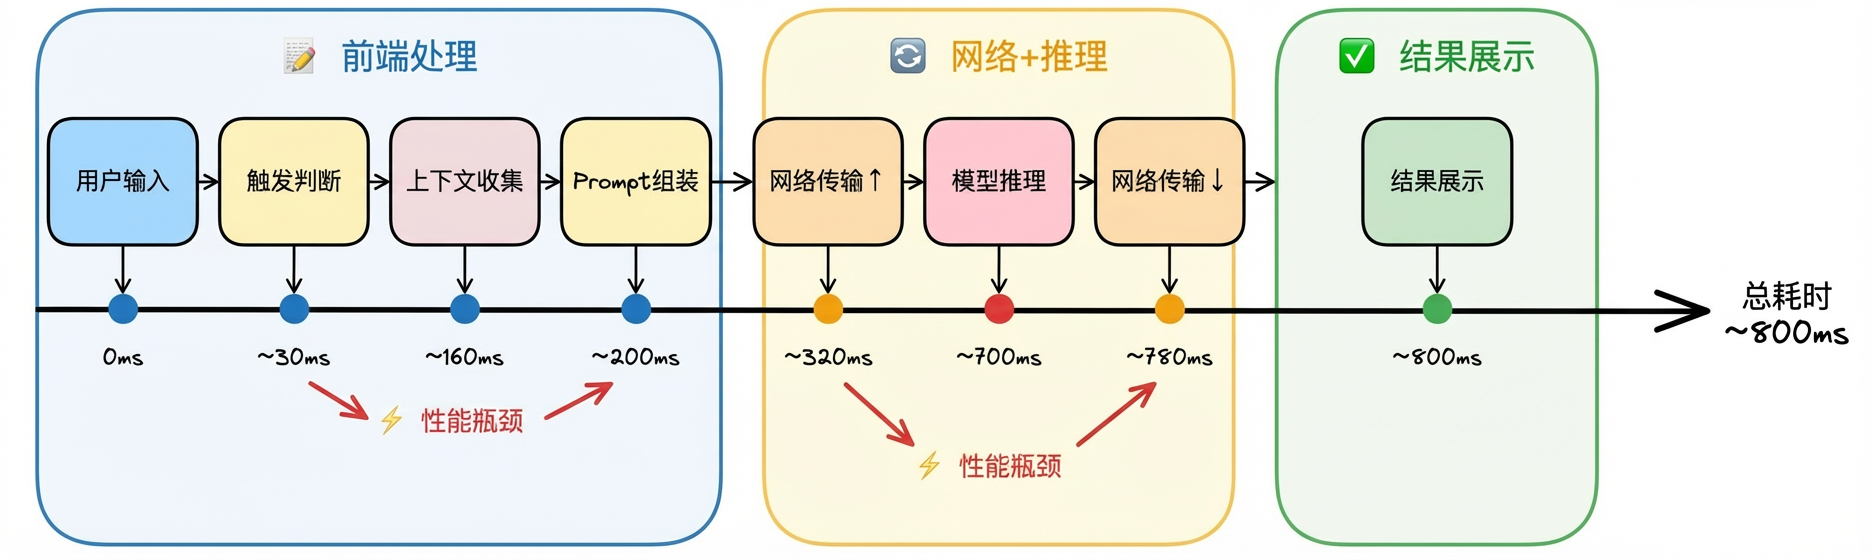
优化前,我们对线上百万次补全请求进行了首 Action 端到端延迟分布分析:
各环节延迟占比分析:
关键发现:模型推理是延迟的主要来源,占据总延迟的 50%。网络传输占 25%,同样不可忽视。这决定了我们的优化策略——以模型推理加速为核心,同时覆盖上下文收集和网络传输环节。
模型推理占据总延迟的 50%,是整个链路中性能优化的关键所在。我们围绕推理的两个核心阶段展开优化:Prefill 阶段(影响首 Token 响应时间 TTFT)和 Decoding 阶段(影响首 Action的生成速度 TPS)。
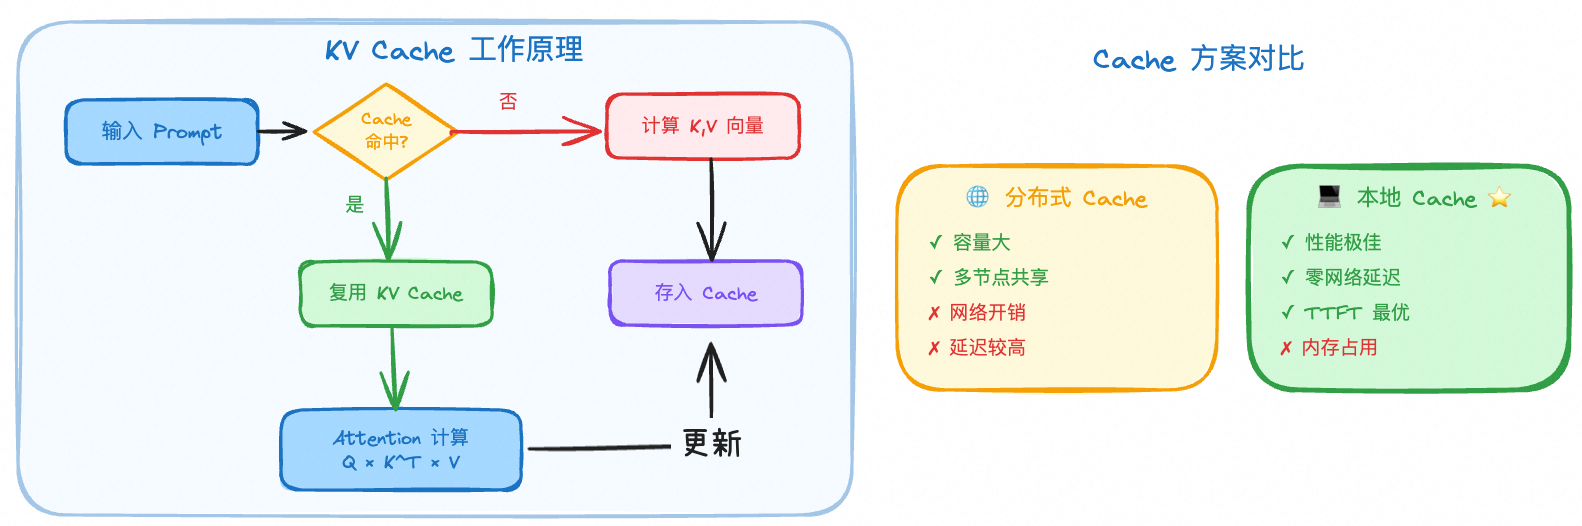
首 Token 响应时间(TTFT)主要受 Prefill 阶段影响。在代码补全场景中,用户输入不断累积、文件上下文频繁变动,导致 Prefill 耗时增加且 KV Cache 命中率下降。我们采取了以下措施:
Prompt 优化:通过精心设计和动态调整 Prompt 结构,显著提升 KV Cache 命中率,命中率提升 10%。这属于"低垂的果实",易于见效。
KV Cache 调度:在分布式 Cache 和本地 Cache 两种主流方案中,我们选择了本地 Cache 方案,以实现对 TTFT 的极致优化。
 部署架构:采用 TP(Tensor Parallel)等并行架构可显著降低 TTFT,但会带来更高的资源成本。我们根据实际业务场景进行了精细化权衡与配置。
Decoding 阶段的优化目标是提升 Token 生成速度(TPS),我们从以下两个维度展开攻坚:
量化与算子融合:在保证精度可控的前提下,采用 FP8 量化技术提升推理性能,并对主流开源算子进行筛选与深度融合优化,在 TPOT(单 Token 生成时间)上实现显著降低。
注意:此类优化的效果高度依赖具体模型、推理引擎及 GPU 型号,Benchmark 结果的可复制性相对较低。
投机解码(Speculative Decoding):采用"小模型快速生成 + 大模型批量验证"的策略,小模型(Draft Model)快速生成候选 Token 序列,再大模型批量验证,确保输出质量不受影响。我们针对 Draft 模型进行了定制化训练,该技术在不牺牲输出质量的前提下,实现了 TPS 指标的显著提升。
通过上述多维度的优化策略,我们在模型推理性能上取得了突破性进展,为用户提供了更快速、更流畅的交互体验。
Qoder NEXT 需要多维度的上下文信息:当前文件的 AST 结构、光标周围的代码片段、项目符号表与依赖关系图,以及语义相关代码的 Embedding 向量。如何快速、准确地收集这些信息,直接影响补全质量和响应速度。
上下文收集看似简单,但在大型项目中,读取和解析文件可能非常耗时。我们设计了多级缓存来解决这个问题:
不同类型的上下文收集耗时差异显著。光标附近的 AST、当前文件符号表等轻量级上下文仅需 5-20ms,可以实时收集;而 LSP 依赖关系、语义相关代码等重量级上下文需要跨文件分析或 Embedding 检索,耗时可达 100-300ms。如果等到触发补全时才开始收集重量级上下文,延迟将不可接受。
我们的核心思想是:边打字边收集,重量级上下文提前预加载,用户停下时上下文已就绪。
模型推理完成后,结果需要经过网络传输到达客户端。网络延迟是端到端体验的重要组成部分,尤其对于全球用户而言。我们从传输路径和传输方式两个维度进行优化。
就近访问:通过全球多地域部署推理服务,用户请求自动路由至最近的服务节点,将网络 RT 从 200ms 降低至 50ms。
全球网络加速:对于跨地域请求,我们接入云厂商的全球加速网络,通过专线传输避免公网拥塞和丢包,进一步降低传输延迟并提升稳定性。
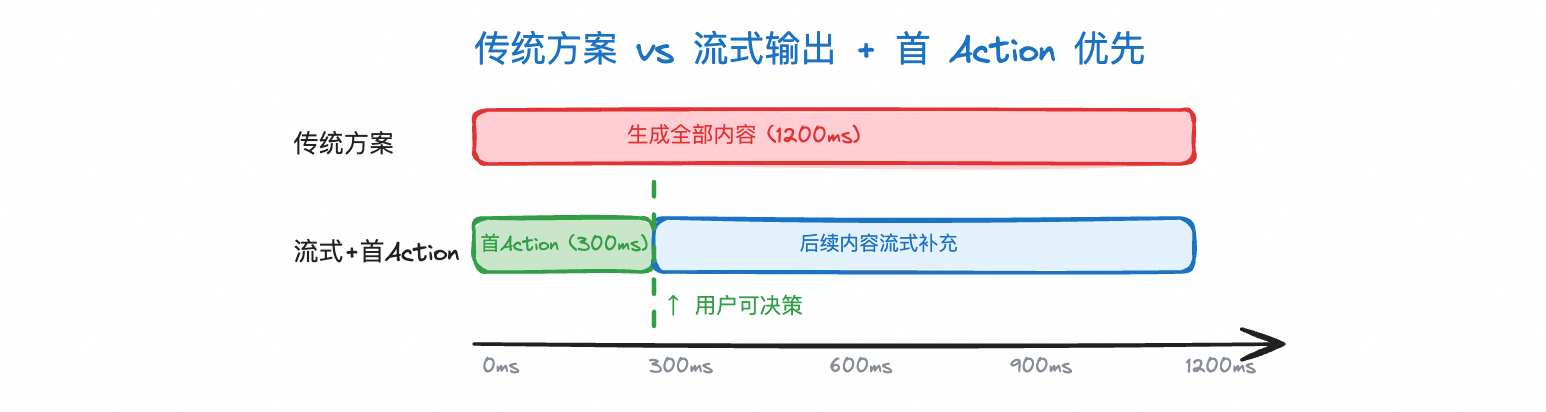
传统 HTTP 请求需等待响应完整生成后一次性返回,而我们基于 HTTP/2 Stream 实现流式输出:模型每生成一个 token 即刻推送至客户端,无需等待全部完成。
结合首 Action 优先策略,用户在首个完整代码片段生成后即可决策,无需等待后续内容:
用户的编辑行为并非总是线性向前。输入回删、撤销重做、光标跳转等场景下,上下文往往与之前高度相似。我们利用这一特点,对补全结果进行短时缓存。
为了平衡命中率和内存占用,我们设计了智能的缓存淘汰策略:
当前优化聚焦于"触发后快速响应",NAP 的目标是更进一步:在用户触发之前,就预测并准备好结果。
通过持续分析用户的编辑轨迹,预测下一步动作和触发时机,提前在后台计算补全结果。当用户真正触发时,直接返回已缓存的结果,将首 Action 延迟从 300ms 进一步降至 < 100ms,实现真正的"零等待"体验。
性能优化没有银弹,Qoder NEXT 的毫秒级响应是模型优化与工程优化协同作用的结果。
我们将P50的延迟从 800ms 优化到 300ms,取得阶段性成果。 代码补全是高频、心流敏感的场景,每一毫秒都关乎体验。我们不仅优化 P50,更关注 P99——确保绝大多数用户都能获得流畅体验。
我们相信,最好的技术应该是隐形的。用户无需知道背后的复杂优化,只需享受 Tab 按下去的顺滑。
Think Ahead, Code Next —— 让等待感消失。
引言:300ms 的体验红线
当你按下键盘等待代码补全时,你能容忍多长时间的延迟?
人机交互研究表明:100ms 是"即时响应"的边界,400ms 是生产力下降的拐点,超过 1 秒则会让用户烦躁。
代码补全场景对延迟更为敏感——高频触发、心流易断、与手动输入竞争。我们据此将体验分为四个等级:
| 体验等级 | 首 Action 延迟 | 用户感受 |
|---|---|---|
| 优(Excellent) | < 300ms | "系统在读心",完全无感知 |
| 良(Good) | 300-500ms | 基本无感,心流不断 |
| 中(Average) | 500-700ms | 出现卡顿,开始影响效率 |
| 差(Poor) | > 700ms | 烦躁,可能放弃使用 |
优化成果总览
在深入技术细节之前,先展示我们的优化成果:从 800ms 到 300ms,成功突破 300ms 的体验红线。
全链路延迟分析
2.1 首 Action 的定义
首Action与首 Token的区别在于:首 Token 是模型生成的第一个 token,而首 Action 是第一个语义完整、可供用户采纳的代码片段。首 Action 可能包含多个 token,但它是用户真正关心的"第一个有意义的结果"。
首 Action 具备的核心特点:
- 完整性:包含足够信息供用户决策(不是半截的 token)
- 独立性:用户可以直接 Tab 接受或继续输入,不依赖后续数据即可使用
const user = 时,首 Action 为 await getUserById(id);——一个完整的、可直接使用的代码行。
2.2 补全请求的完整生命周期
2.3 延迟分布深度分析
优化前,我们对线上百万次补全请求进行了首 Action 端到端延迟分布分析:
| 指标 | P50 | P90 | P99 |
|---|---|---|---|
| 首 Action 延迟 | 800ms | 1000ms | 1300ms+ |
| 阶段 | 平均延迟 | 占比 |
|---|---|---|
| 触发判断 | 30ms | 4% |
| 上下文收集 | 130ms | 16% |
| Prompt 组装 | 40ms | 5% |
| 网络传输 | 200ms | 25% |
| 模型推理 | 400ms | 50% |
模型推理加速:核心战场
模型推理占据总延迟的 50%,是整个链路中性能优化的关键所在。我们围绕推理的两个核心阶段展开优化:Prefill 阶段(影响首 Token 响应时间 TTFT)和 Decoding 阶段(影响首 Action的生成速度 TPS)。
Prefill 优化(加速首Token响应)
首 Token 响应时间(TTFT)主要受 Prefill 阶段影响。在代码补全场景中,用户输入不断累积、文件上下文频繁变动,导致 Prefill 耗时增加且 KV Cache 命中率下降。我们采取了以下措施:
Prompt 优化:通过精心设计和动态调整 Prompt 结构,显著提升 KV Cache 命中率,命中率提升 10%。这属于"低垂的果实",易于见效。
KV Cache 调度:在分布式 Cache 和本地 Cache 两种主流方案中,我们选择了本地 Cache 方案,以实现对 TTFT 的极致优化。
Decoding 优化(提升生成速度)
Decoding 阶段的优化目标是提升 Token 生成速度(TPS),我们从以下两个维度展开攻坚:
量化与算子融合:在保证精度可控的前提下,采用 FP8 量化技术提升推理性能,并对主流开源算子进行筛选与深度融合优化,在 TPOT(单 Token 生成时间)上实现显著降低。
注意:此类优化的效果高度依赖具体模型、推理引擎及 GPU 型号,Benchmark 结果的可复制性相对较低。
投机解码(Speculative Decoding):采用"小模型快速生成 + 大模型批量验证"的策略,小模型(Draft Model)快速生成候选 Token 序列,再大模型批量验证,确保输出质量不受影响。我们针对 Draft 模型进行了定制化训练,该技术在不牺牲输出质量的前提下,实现了 TPS 指标的显著提升。
通过上述多维度的优化策略,我们在模型推理性能上取得了突破性进展,为用户提供了更快速、更流畅的交互体验。
上下文收集优化:快速准确地获取信息
Qoder NEXT 需要多维度的上下文信息:当前文件的 AST 结构、光标周围的代码片段、项目符号表与依赖关系图,以及语义相关代码的 Embedding 向量。如何快速、准确地收集这些信息,直接影响补全质量和响应速度。
4.1 分层缓存:存储与复用
上下文收集看似简单,但在大型项目中,读取和解析文件可能非常耗时。我们设计了多级缓存来解决这个问题:
| 缓存层级 | 内容 | 命中条件 | TTL | 命中率 |
|---|---|---|---|---|
| L1 内存热缓存 | 当前打开文件的 AST、最近补全的上下文 | 文件未修改 | 会话级 | ~45% |
| L2 项目级缓存 | 文件 AST、符号表、依赖图 | 文件哈希匹配 | 项目打开期间 | ~20% |
| L3 语义向量缓存 | 代码块的语义 Embedding | 置信度判断 | 24 小时 | ~10% |
4.2 异步收集:利用击键间隙
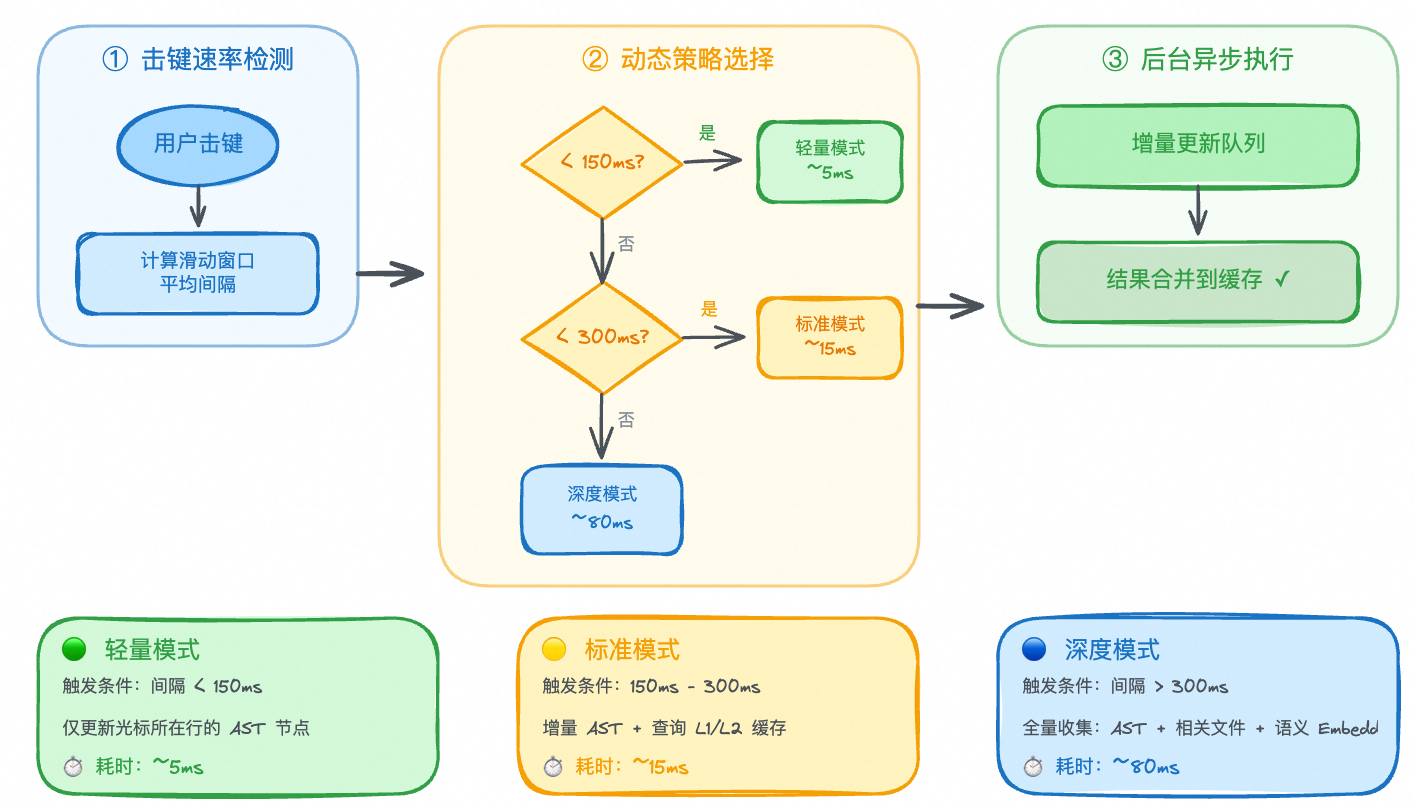
不同类型的上下文收集耗时差异显著。光标附近的 AST、当前文件符号表等轻量级上下文仅需 5-20ms,可以实时收集;而 LSP 依赖关系、语义相关代码等重量级上下文需要跨文件分析或 Embedding 检索,耗时可达 100-300ms。如果等到触发补全时才开始收集重量级上下文,延迟将不可接受。
我们的核心思想是:边打字边收集,重量级上下文提前预加载,用户停下时上下文已就绪。
击键间隔的价值
用户输入动作并非连续不断,而是有自然的节奏:| 打字状态 | 典型间隔 | 可用时间窗口 |
|---|---|---|
| 快速输入 | 80-150ms | 足够更新光标附近的 AST |
| 正常输入 | 150-250ms | 可完成增量解析 + 缓存查询 |
| 思考/停顿 | 250-500ms | 可预取相关文件 + 语义分析 |
| 长停顿 | > 500ms | 可完成全量上下文收集 |
动态调整策略
我们根据用户的实时击键速率,动态调整上下文收集的深度和范围:自适应学习
系统会学习用户的打字习惯,进一步优化收集策略:| 用户特征 | 识别方式 | 策略调整 |
|---|---|---|
| 快速打字者 | 平均间隔 < 120ms | 提高轻量模式阈值至 180ms |
| 边想边打 | 间隔方差大 | 更频繁切换深度模式 |
| 批量粘贴 | 短时间大量输入 | 暂停收集,等待稳定 |
网络传输与流式输出
模型推理完成后,结果需要经过网络传输到达客户端。网络延迟是端到端体验的重要组成部分,尤其对于全球用户而言。我们从传输路径和传输方式两个维度进行优化。
5.1 网络传输优化:降低传输延迟
就近访问:通过全球多地域部署推理服务,用户请求自动路由至最近的服务节点,将网络 RT 从 200ms 降低至 50ms。
全球网络加速:对于跨地域请求,我们接入云厂商的全球加速网络,通过专线传输避免公网拥塞和丢包,进一步降低传输延迟并提升稳定性。
| 优化措施 | 延迟收益 | 说明 |
|---|---|---|
| 就近访问 | -150ms | 请求路由至最近节点 |
| 全球网络加速 | -30ms | 专线传输,避免公网抖动 |
5.2 流式输出:首 Action 优先
传统 HTTP 请求需等待响应完整生成后一次性返回,而我们基于 HTTP/2 Stream 实现流式输出:模型每生成一个 token 即刻推送至客户端,无需等待全部完成。
结合首 Action 优先策略,用户在首个完整代码片段生成后即可决策,无需等待后续内容:
| 方案 | 用户感知延迟 | 说明 |
|---|---|---|
| 传统方案 | 1200ms | 等待全部生成完毕后一次性返回 |
| 流式 + 首 Action 优先 | 300ms | 首包即可决策,后续流式补充 |
结果缓存与复用
6.1 上下文不变时,结果可复用
用户的编辑行为并非总是线性向前。输入回删、撤销重做、光标跳转等场景下,上下文往往与之前高度相似。我们利用这一特点,对补全结果进行短时缓存。
💡 约 23% 的补全请求可命中缓存,首 Action 延迟从 ~300ms 降至 < 10ms。
6.2 缓存生命周期管理
为了平衡命中率和内存占用,我们设计了智能的缓存淘汰策略:
| 策略 | 说明 |
|---|---|
| 时间窗口 | 缓存有效期 30 秒,超时自动失效 |
| 容量限制 | 每个文件最多缓存 10 条结果 |
| 主动失效 | 文件保存、大范围编辑时清空相关缓存 |
| LRU 淘汰 | 容量不足时,优先淘汰最久未命中的缓存 |
📊 整体效果:在内存占用可控的前提下,实现 23% 的结果复用率。
未来优化方向
7.1 模型层面
- 更小尺寸:通过场景定制训练和知识蒸馏,打造更轻量的专用模型,并根据补全复杂度动态选择模型尺寸
- 推理加速:探索稀疏注意力、更激进的量化策略(INT4)以及硬件适配优化,持续压缩推理延迟