
Goal 模式 + 自验证 + 回归守卫,上百小时无人值守迭代
返回
 最近我们上线了 Computer Use:一个让 AI 操作真实电脑界面的能力。比起最终产物,更值得聊的是我们怎么把它做出来的。
Computer Use 让 AI 能看屏幕、点按钮、输入、拖拽,而且在后台运行不打扰用户。难点不只是"动作发出去",而是动作要真的生效、动作后的状态要可读、不能抢走前台。
具体到落地,这个项目有三个非常现实的难点:
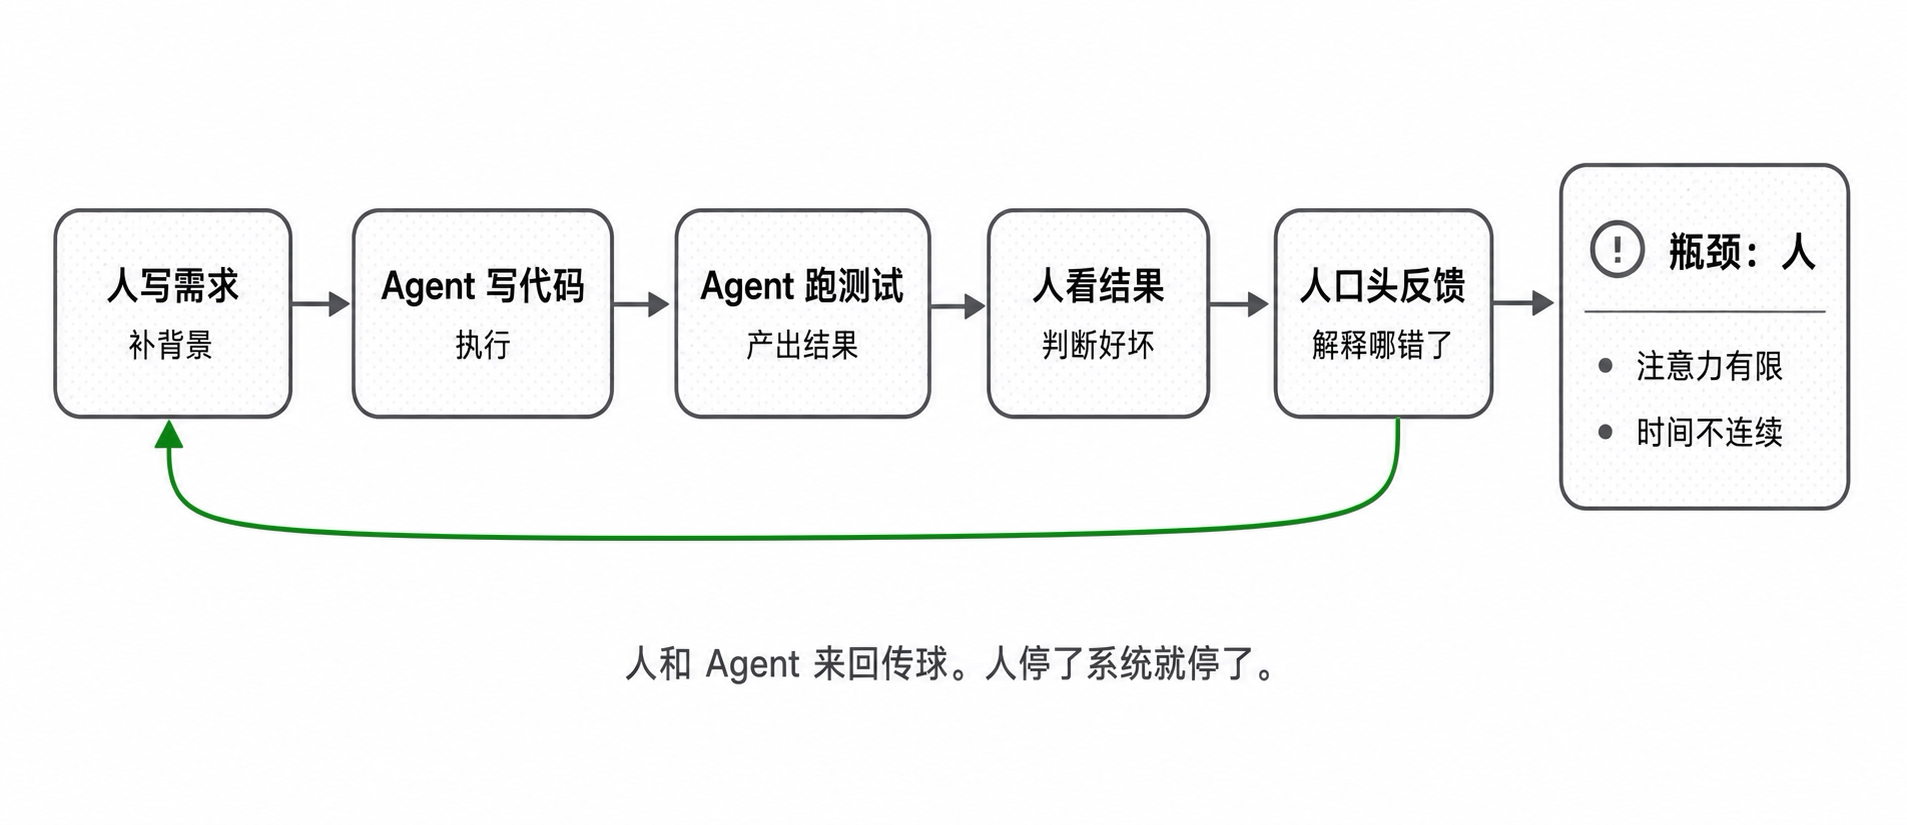
最开始的方式很传统:我写需求,Agent 写代码,我手动跑测试,看结果,再口头反馈。
如果你用过 AI 编程助手就熟悉这个状态——每次对话都从零开始。你得反复解释背景、教它怎么测试、提醒哪些方向已经试过不行。Agent 的能力不差,但没有持续记忆,每一轮都像换了个人。
瓶颈在人。人的注意力是有限、非连续的——人停下来,系统就停了。要持续迭代,就必须让系统在无人值守下自己运转。
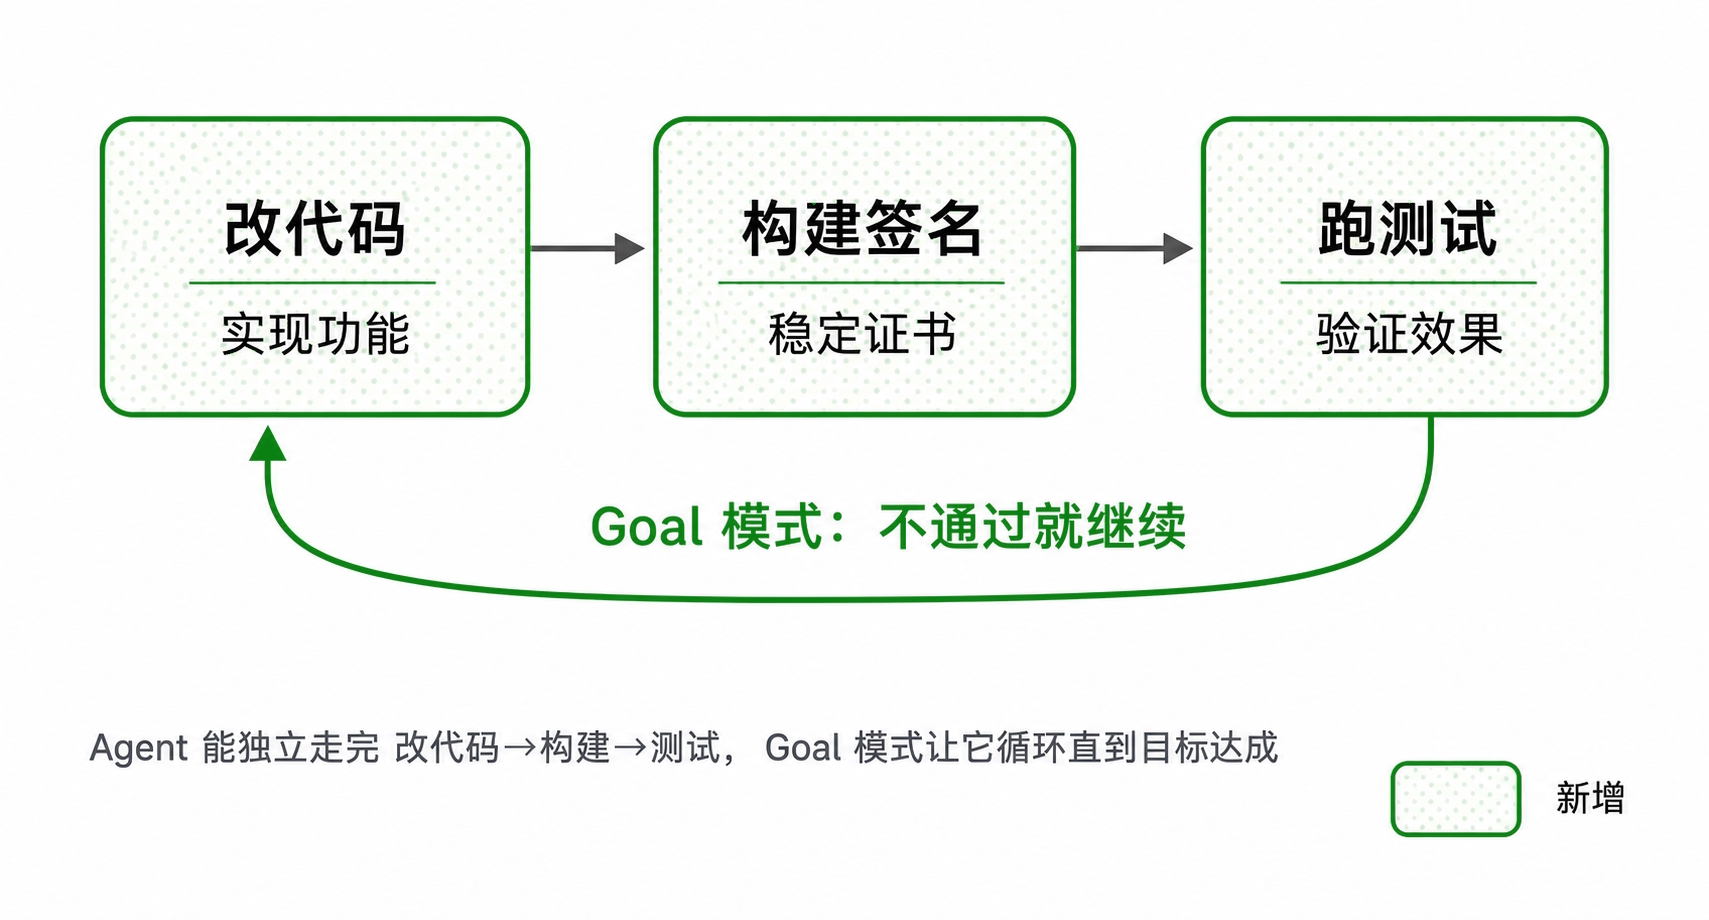
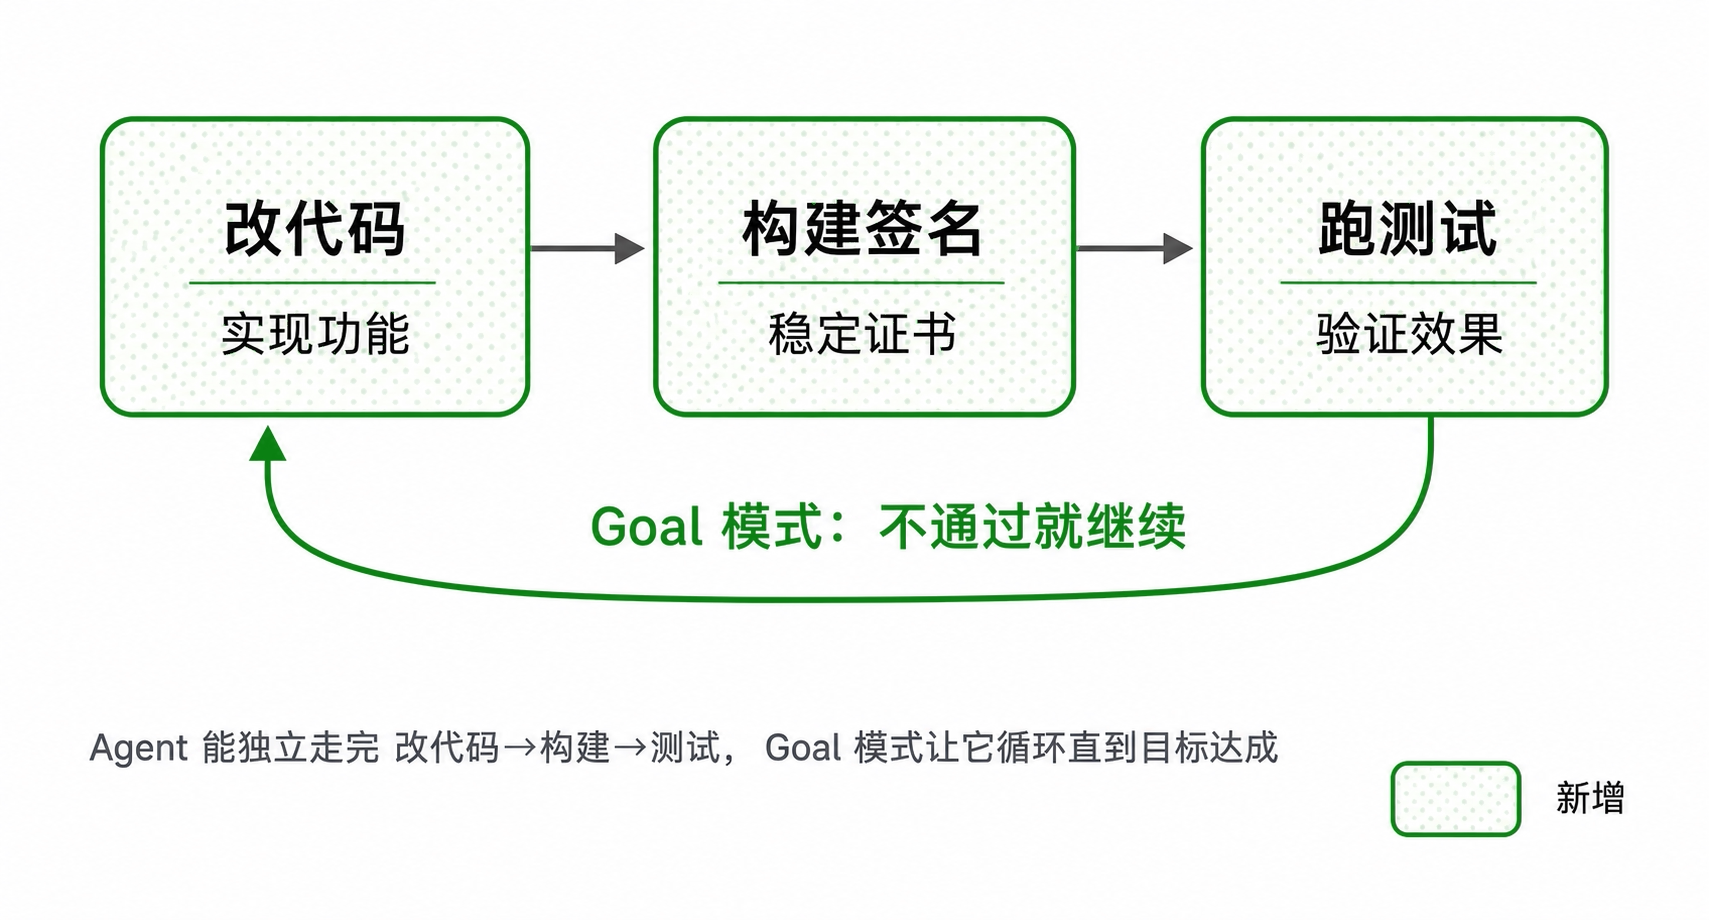
要让 Agent 自主迭代,第一步是搭一条它能独立走通的流水线。
ComputerUse 涉及系统权限——每次构建必须用同一个证书签名,否则 macOS 会把它当成新应用,之前授权的屏幕录制和辅助功能全部失效。我们把"从源码构建 → 稳定签名 → 启动 → 跑测试"这条路径封装好,Agent 一条命令就能走完。它不需要懂签名细节,照着走就能拿到一个行为正确的包。
光能跑还不够。普通 Agent 对话是"一问一答"——任务做完就停。但开发一个工具往往要转好几圈才能收敛:编译过不了、测试通不过、某个应用上行为不对、修了又在别的场景回归……每一圈都让人来启动,效率打回原形。
我们用了 Qoder Goal 模式:给 Agent 一个目标(比如"实现 click 工具,通过端到端测试"),它会围绕这个目标持续推进——实现、测试、失败再改——直到达成或明确卡住需要人决策。不再是"跑一次就停",而是自主循环到收敛。
Agent 能自己跑起来之后,很快暴露一个问题。
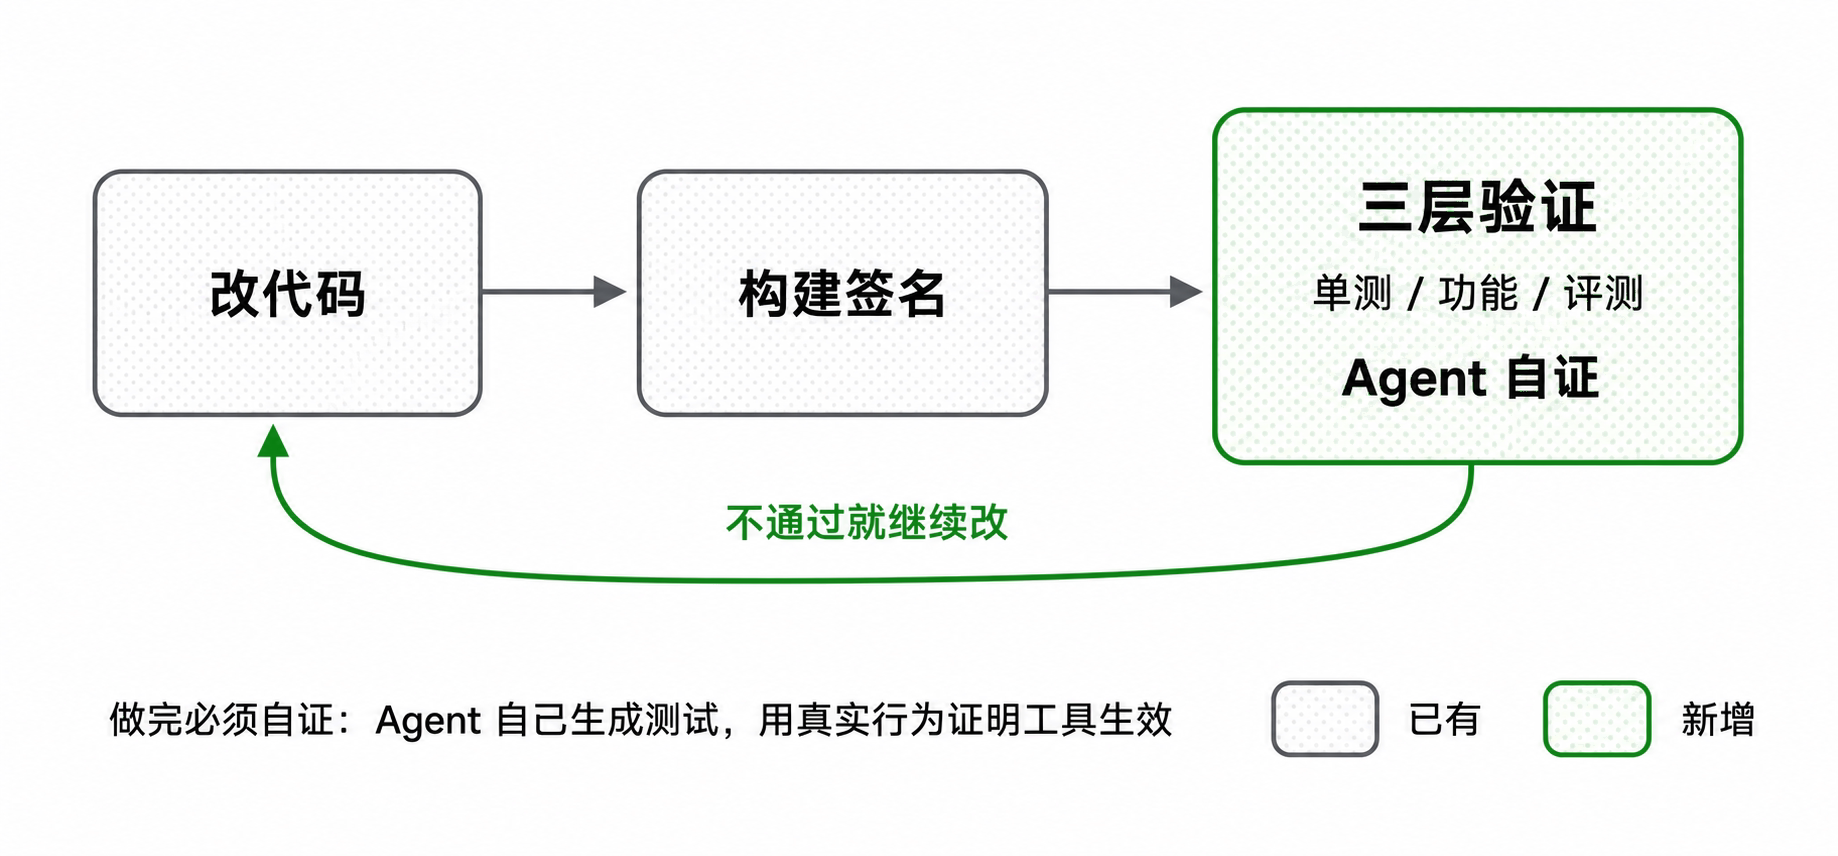
举个例子:让 Agent 实现 click 工具,它跑完测试报告"通过"。手动一看,按钮根本没被按下——它写的测试只检查"调用没报错",没检查"按钮状态变了"。测试维度看是绿的,实际效果完全不对。
问题不是没跑测试,而是测试太弱:只要测试只覆盖最顺的路径,Agent 完全可以写一个什么都不做的实现也能"通过"。我们直接改规则:任何变更必须经过真实而充分的验证才算结束。
具体是三层:
 从单点功能测试到完整流程验收:关键不只是工具返回成功,而是最终效果多维度验证。
有了验证 Agent 能证明当前改动是对的。但还有一种情况防不住。
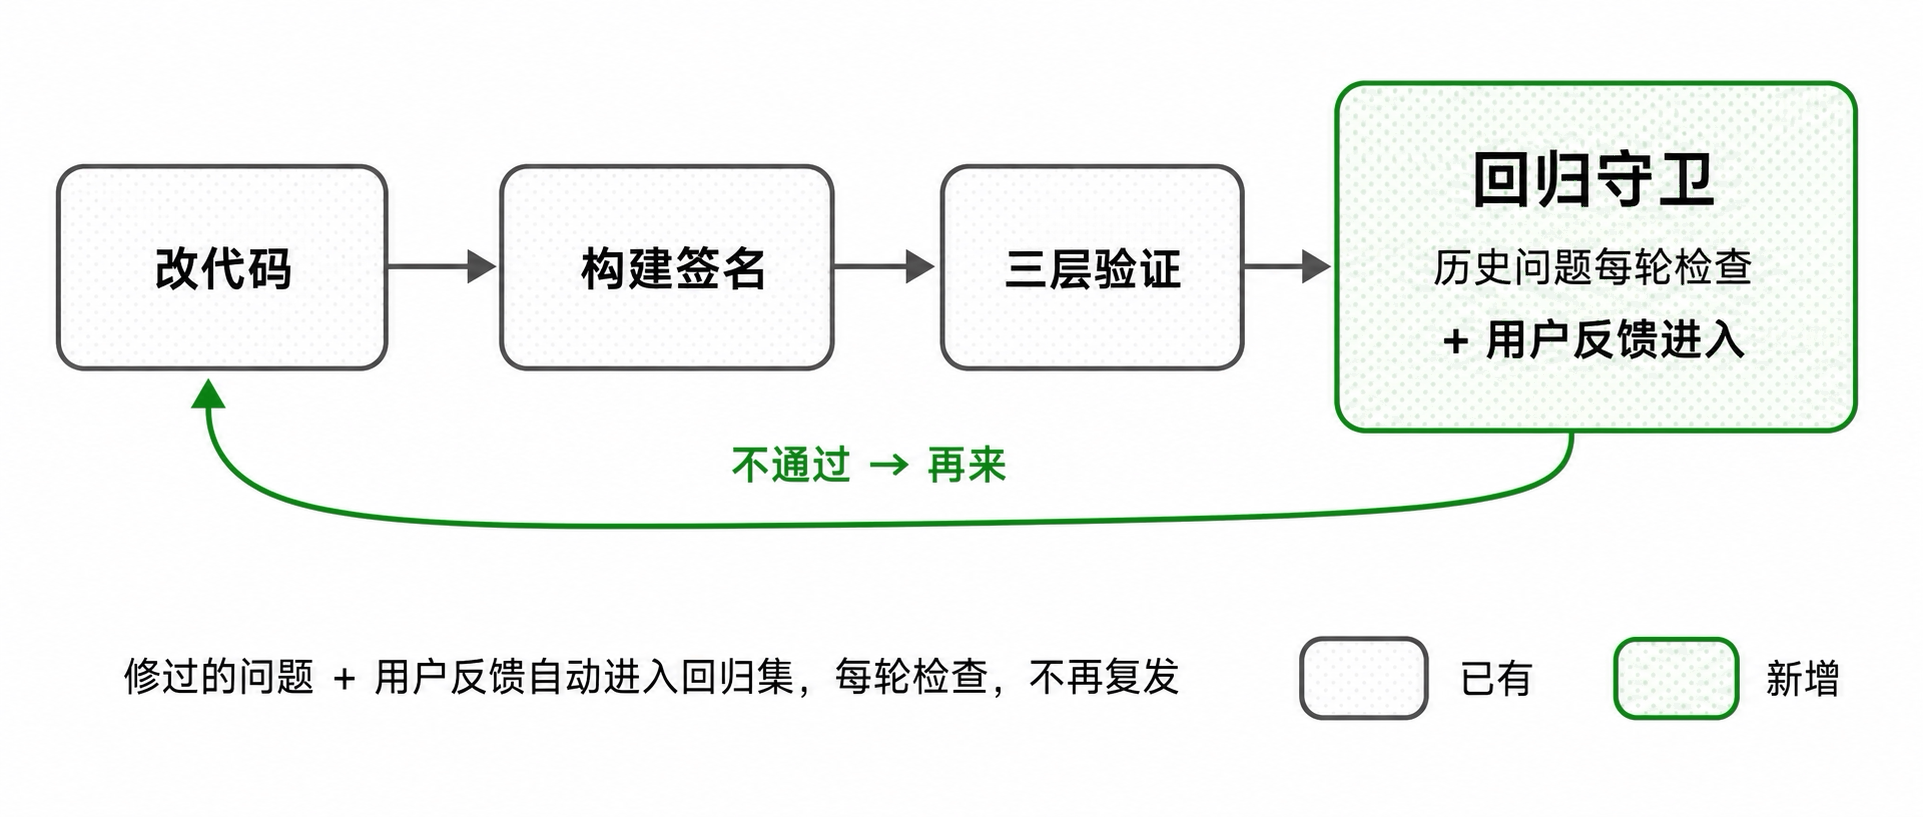
周一修好一个问题:点击按钮偶尔会把焦点抢到前台。周三 Agent 优化另一个功能时,不小心改了相关逻辑,那个问题又复发了——但没人发现,因为它不在当前任务的测试范围里。
做法很直接:每次修过的问题都变成持久的测试用例,以后每轮自动检查。我们多做了一步:不只把开发中发现的 bug 加入回归,真实用户反馈暴露的问题也纳入——"我在某个应用里点击没反应"会被转化成可重复执行的测试场景,永久进入回归集。
出过的问题不能只靠人记住,得变成自动执行的检查。
举两个真实场景:
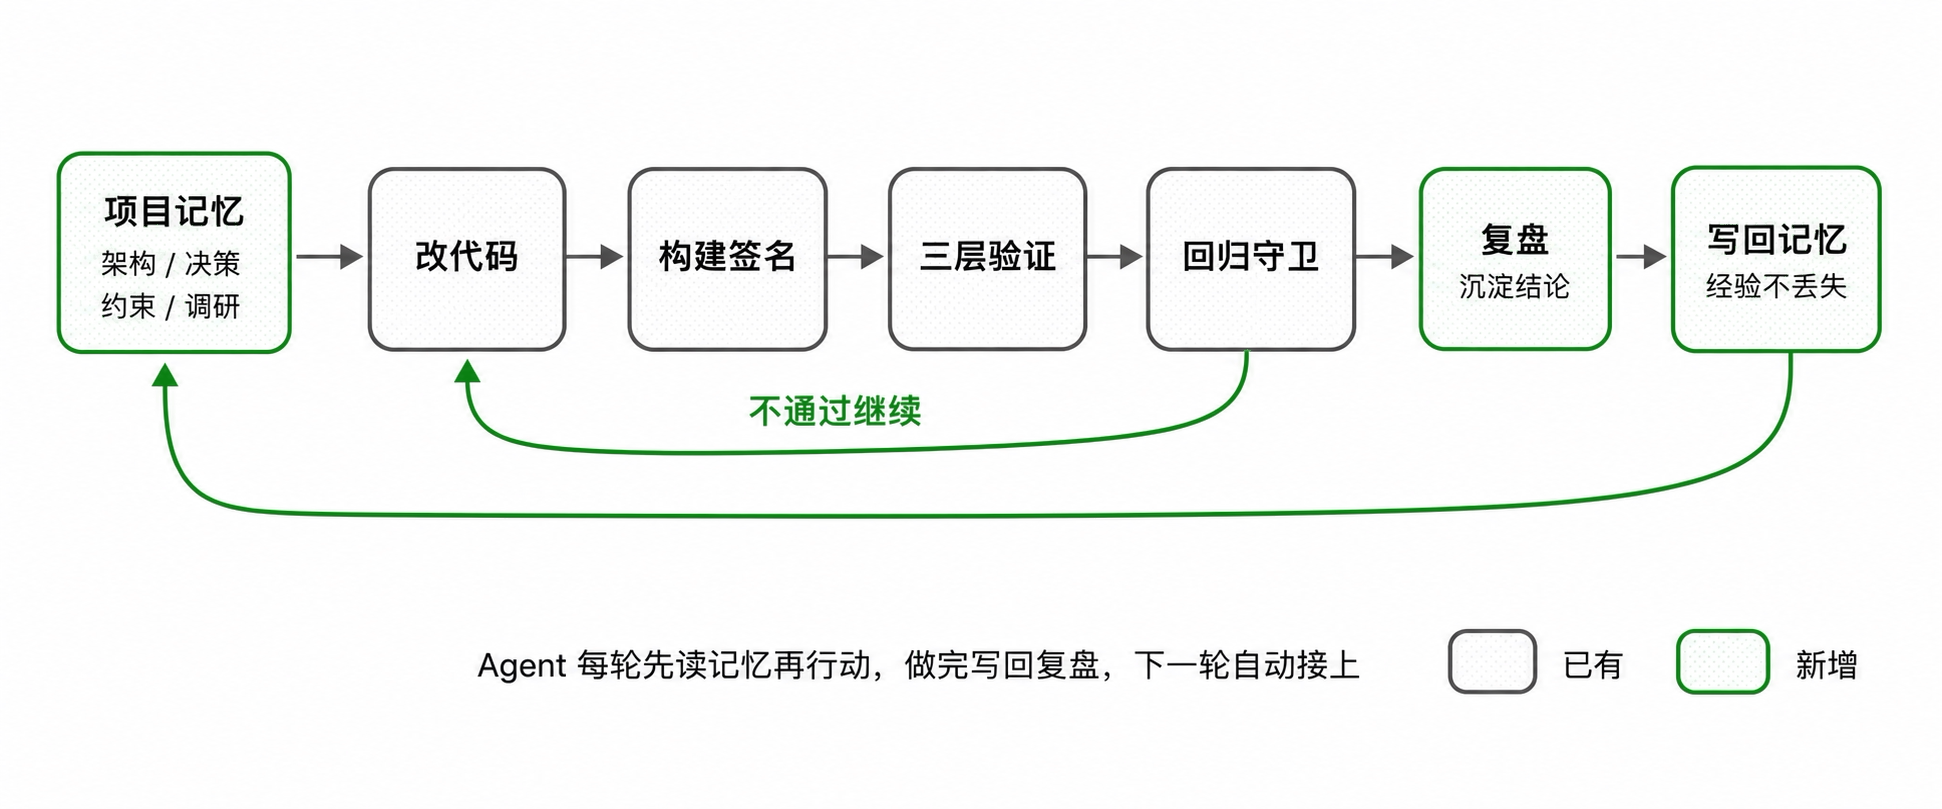
Agent 每轮开始先读项目记忆和上一轮复盘,结束时写回。
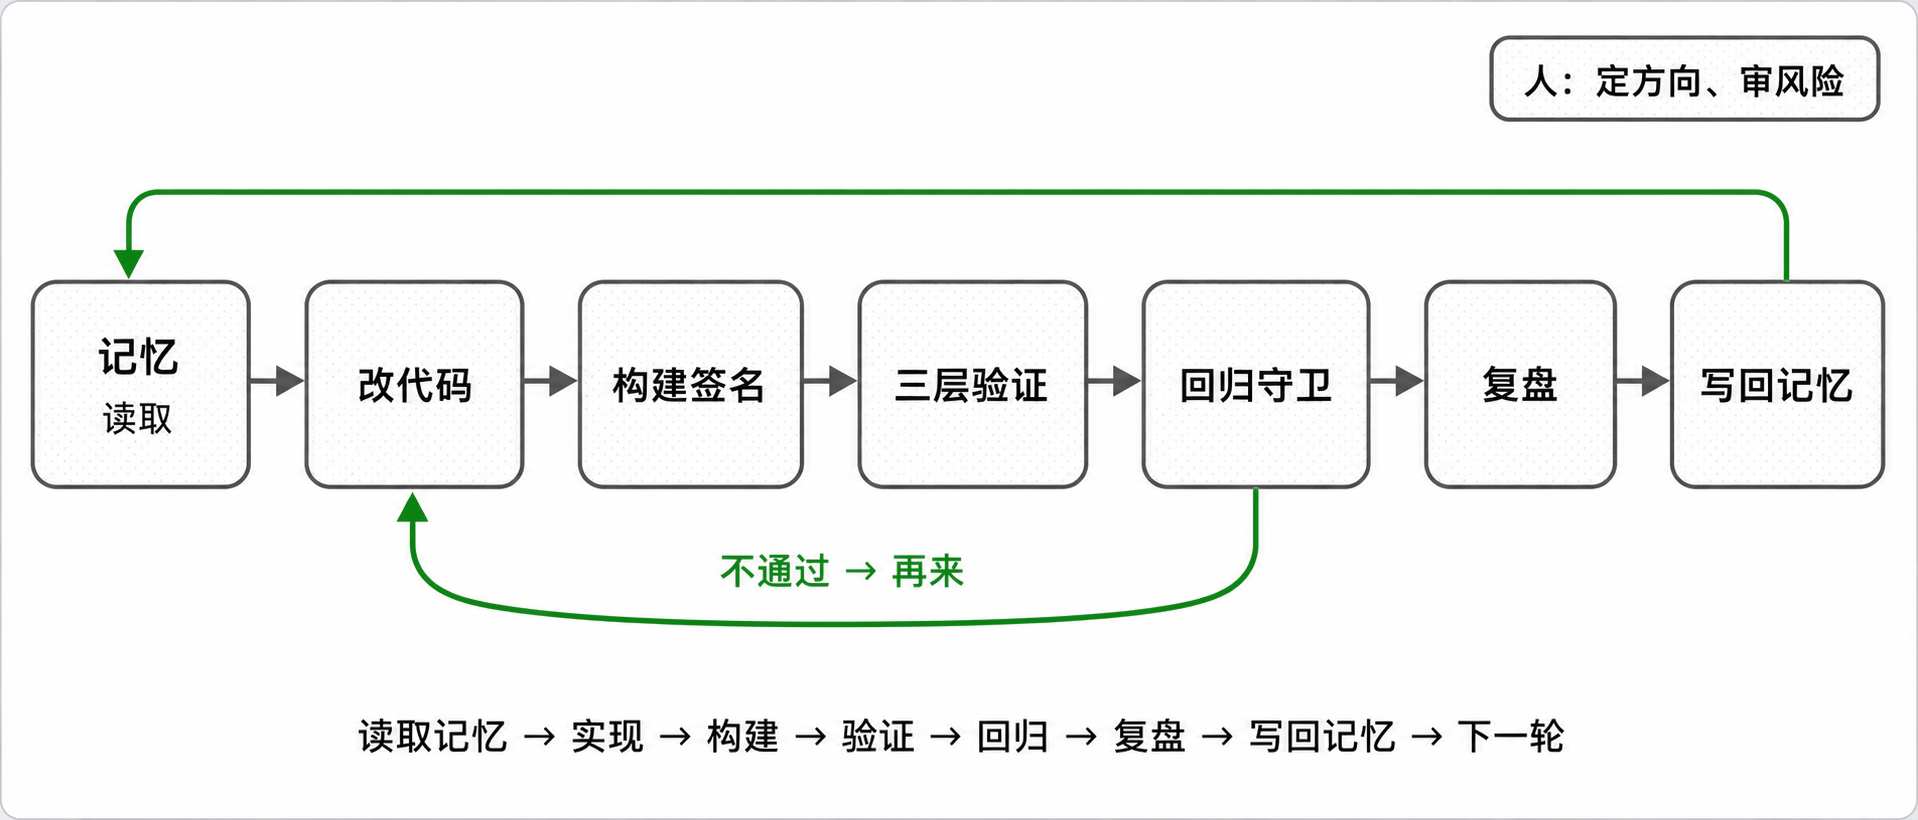
四个环节拼在一起就是一个完整循环:
目标 → 实现 → 验证 → 复盘 → 下一轮目标
每一轮都不是从零开始,而是站在上一轮的肩膀上。
闭环跑通后不需要人实时盯着:
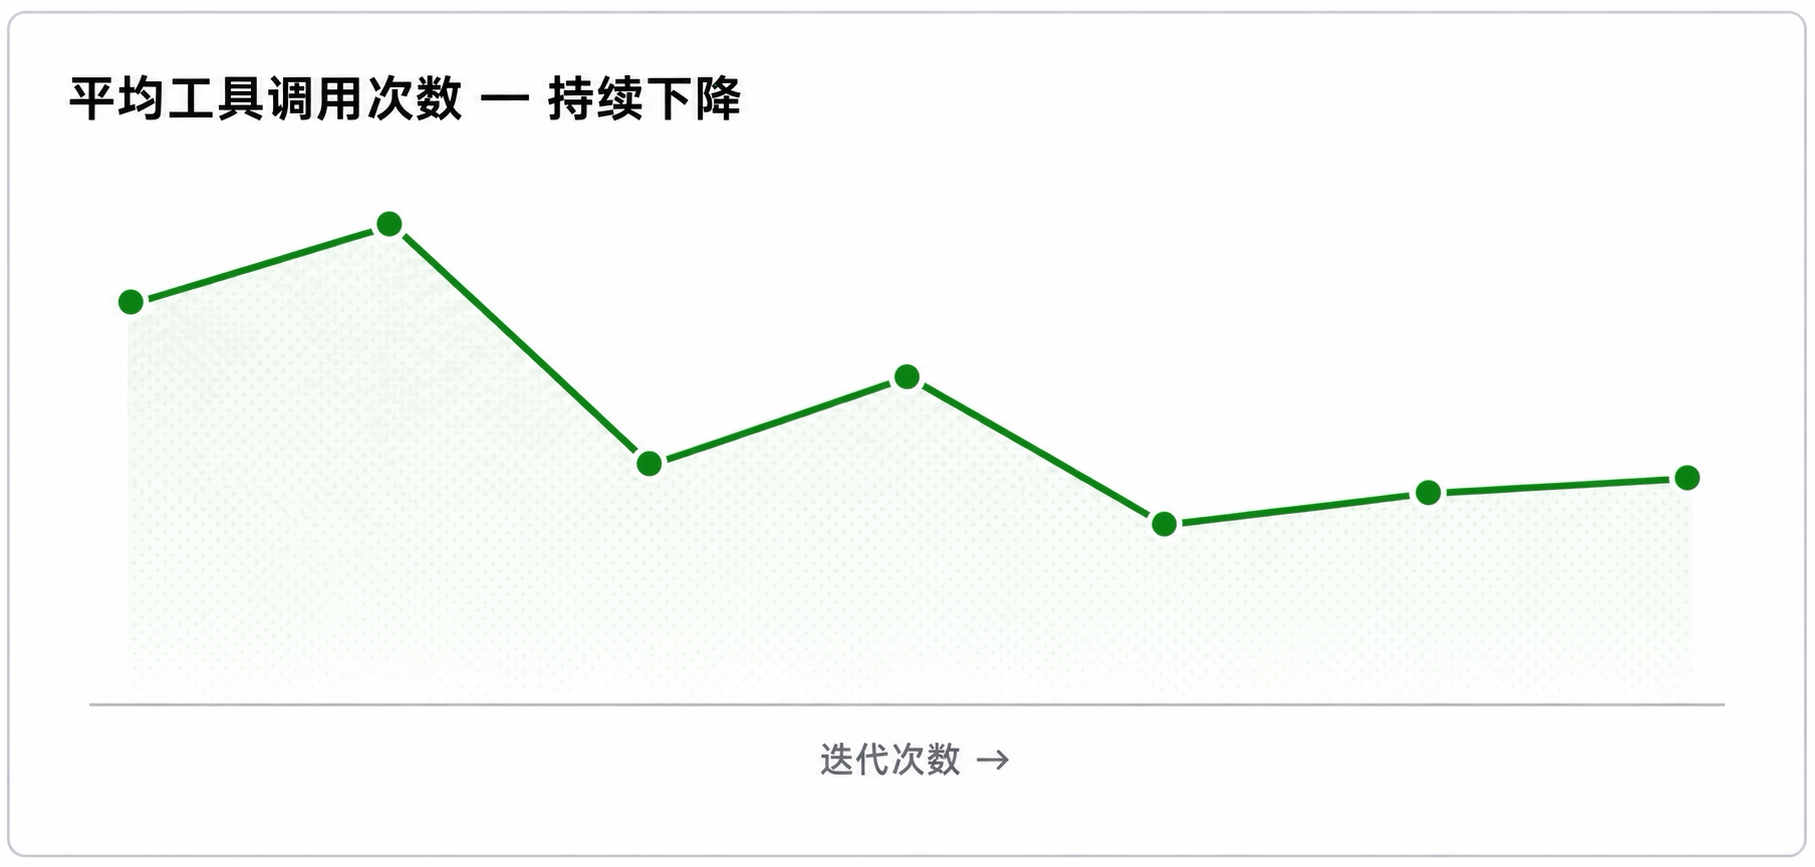
这套系统跑了上百个小时的持续迭代——大量的夜间无人值守。下面两张是实际评测数据。相同的评测集我们可以比Codex得到高14%的分数和少23%的工具调用次数。
回到开头:一个不会 Swift 的人,要交付一个生产级 macOS 原生软件——最终做到了。关键不是 AI 多强,而是我们把验收、测试、记忆、回归搭成了一个系统,AI 在系统里自己跑、自己验、自己积累。
人的工作从"写代码、盯执行"变成"定义标准、设计验证、决定方向"。最近"Loop Engineering"概念开始流行,我们看到的时候意识到——这就是我们在 Qoder 内部一直在用的方法。
当这个闭环跑通,一个研发不需要精通某个技术栈也能交付生产级产物。技术栈不再是壁垒,定义能力和验证能力才是。
目前 Qoder Desktop 已上线 Goal 模式和 Spec 能力,最新升级了 UltraPlan 和 UltraReview,加上 Computer Use、Browser Use 等通用验证工具,可以帮你快速搭建自己的自主迭代系统。
- 技术栈鸿沟。 需要 Swift 和 macOS 原生 API,团队没人熟悉 macOS 开发,我自己也完全不会 Swift。
- 工作量大、人力紧。 一个 Computer Use 涉及语义树操作、屏幕截图、进程间 IPC、权限授权、签名机制、动作回放等一整套系统能力,靠传统人力推进规模根本不够。我们要解决的问题不是"能不能做",而是"怎么用 Qoder 把 AI 的作用最大化,把生产效率提升 N 倍"。
- 效果要求是全球领先。 不是 demo,是要在真实 Agent 场景里好用——任何一个维度掉队都会被立刻放大。
把人从循环里拿出来
最开始的方式很传统:我写需求,Agent 写代码,我手动跑测试,看结果,再口头反馈。
如果你用过 AI 编程助手就熟悉这个状态——每次对话都从零开始。你得反复解释背景、教它怎么测试、提醒哪些方向已经试过不行。Agent 的能力不差,但没有持续记忆,每一轮都像换了个人。
瓶颈在人。人的注意力是有限、非连续的——人停下来,系统就停了。要持续迭代,就必须让系统在无人值守下自己运转。
自动化流水线 + Goal 模式
要让 Agent 自主迭代,第一步是搭一条它能独立走通的流水线。
ComputerUse 涉及系统权限——每次构建必须用同一个证书签名,否则 macOS 会把它当成新应用,之前授权的屏幕录制和辅助功能全部失效。我们把"从源码构建 → 稳定签名 → 启动 → 跑测试"这条路径封装好,Agent 一条命令就能走完。它不需要懂签名细节,照着走就能拿到一个行为正确的包。
光能跑还不够。普通 Agent 对话是"一问一答"——任务做完就停。但开发一个工具往往要转好几圈才能收敛:编译过不了、测试通不过、某个应用上行为不对、修了又在别的场景回归……每一圈都让人来启动,效率打回原形。
我们用了 Qoder Goal 模式:给 Agent 一个目标(比如"实现 click 工具,通过端到端测试"),它会围绕这个目标持续推进——实现、测试、失败再改——直到达成或明确卡住需要人决策。不再是"跑一次就停",而是自主循环到收敛。
自验证体系
Agent 能自己跑起来之后,很快暴露一个问题。
举个例子:让 Agent 实现 click 工具,它跑完测试报告"通过"。手动一看,按钮根本没被按下——它写的测试只检查"调用没报错",没检查"按钮状态变了"。测试维度看是绿的,实际效果完全不对。
问题不是没跑测试,而是测试太弱:只要测试只覆盖最顺的路径,Agent 完全可以写一个什么都不做的实现也能"通过"。我们直接改规则:任何变更必须经过真实而充分的验证才算结束。
具体是三层:
- 单元测试:验证单个逻辑。
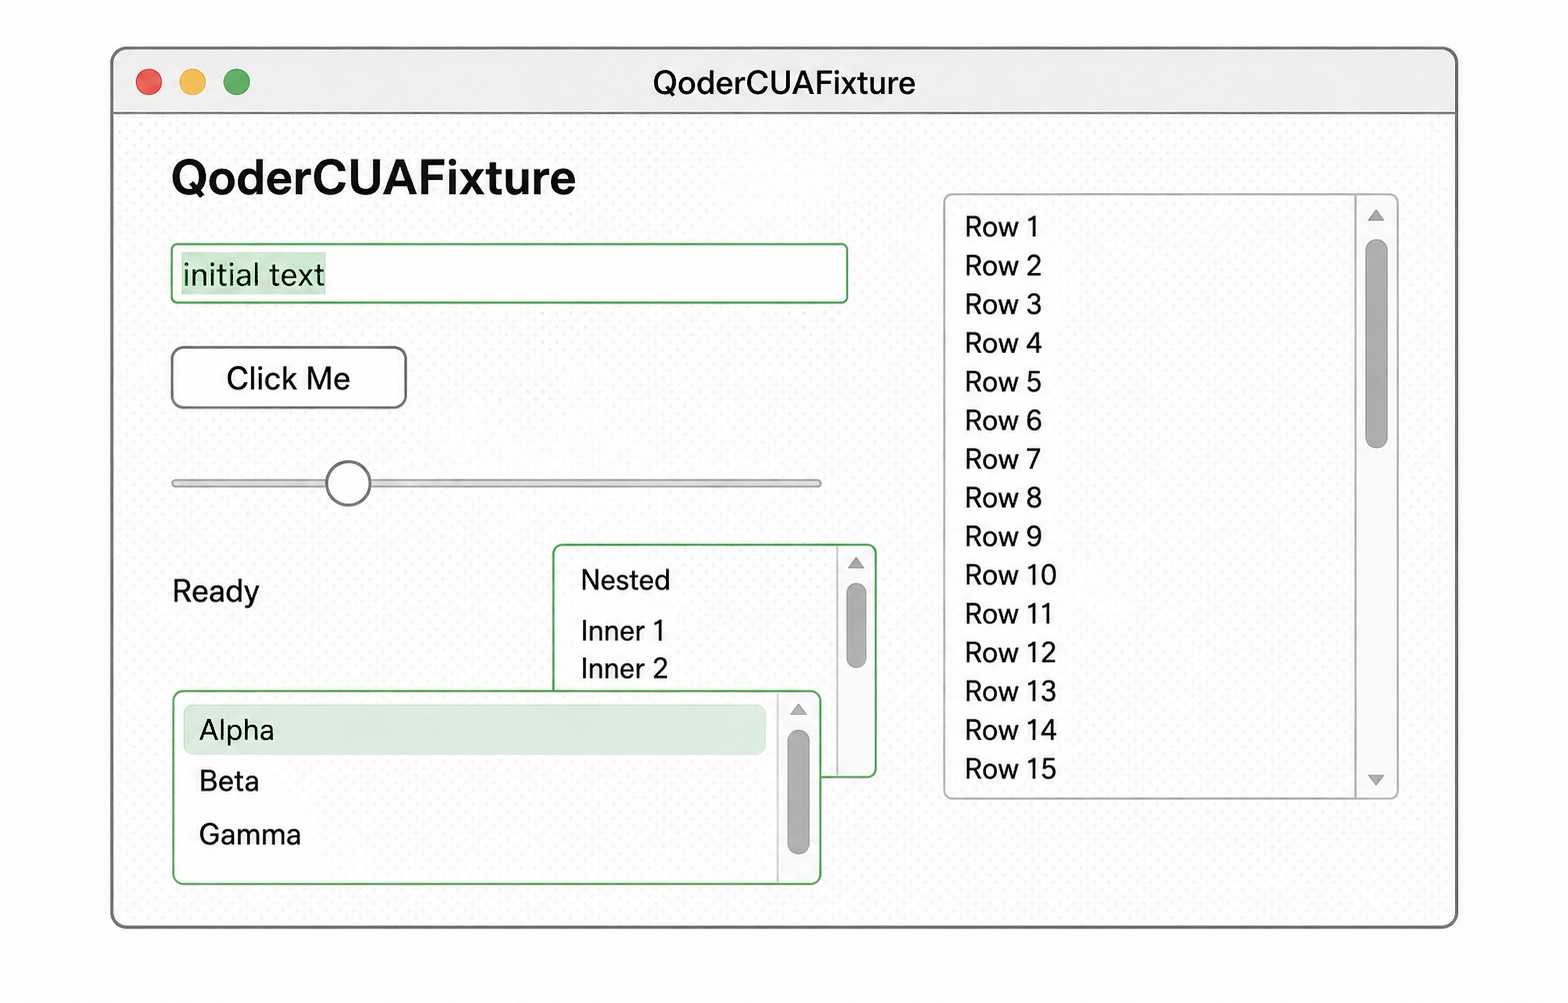
- 功能测试:Agent 自己构造测试应用,端到端跑一遍,验证工具在真实界面上是否生效。
- 评测集:在标准场景跑分,看整体有没有退步。
回归守卫
有了验证 Agent 能证明当前改动是对的。但还有一种情况防不住。
周一修好一个问题:点击按钮偶尔会把焦点抢到前台。周三 Agent 优化另一个功能时,不小心改了相关逻辑,那个问题又复发了——但没人发现,因为它不在当前任务的测试范围里。
做法很直接:每次修过的问题都变成持久的测试用例,以后每轮自动检查。我们多做了一步:不只把开发中发现的 bug 加入回归,真实用户反馈暴露的问题也纳入——"我在某个应用里点击没反应"会被转化成可重复执行的测试场景,永久进入回归集。
出过的问题不能只靠人记住,得变成自动执行的检查。
项目记忆
举两个真实场景:
- 之前定好"必须用稳定证书签名",新一轮 Agent 看到本地有个临时签名脚本就直接用了,权限弹窗又冒出来——前面的约束它根本不知道。
- 上轮 Agent 试过把 scroll 改成系统级 API,发现某些应用不稳定回退了。这个"试过不行"的结论没写下来,下一轮又提议同样方案,重走弯路。
完整闭环
四个环节拼在一起就是一个完整循环:
目标 → 实现 → 验证 → 复盘 → 下一轮目标
每一轮都不是从零开始,而是站在上一轮的肩膀上。
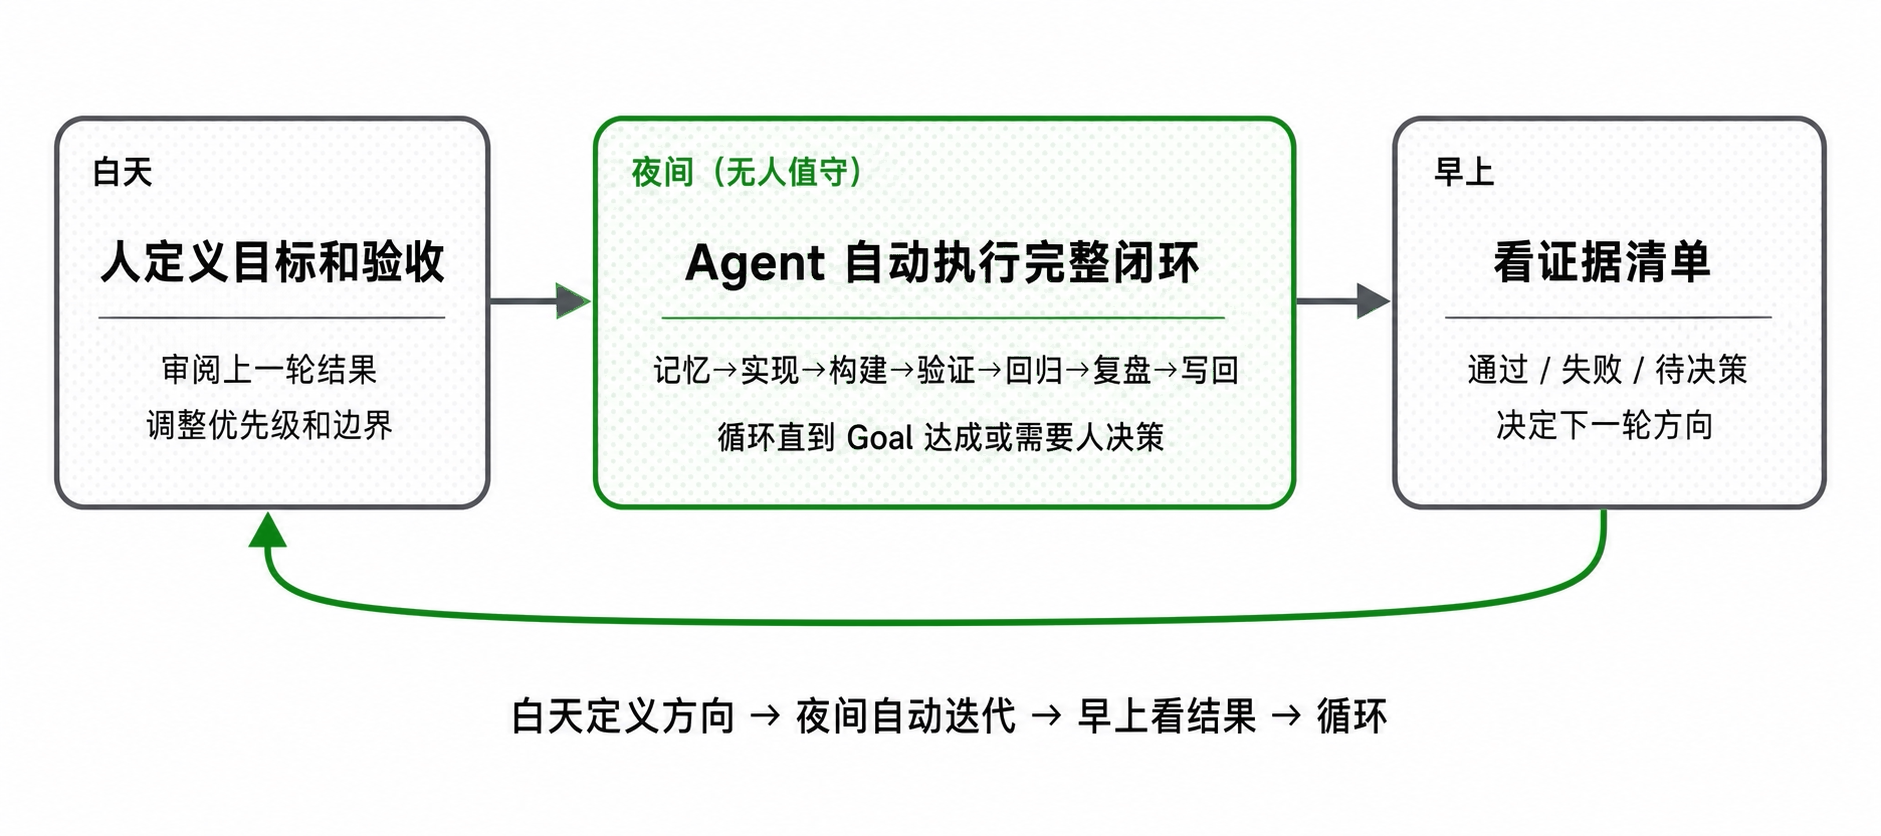
白天定方向,夜间自迭代
闭环跑通后不需要人实时盯着:
- 白天——人定下一轮的目标和验收,审阅上一轮结果
- 夜间——Agent 自动跑:实现 → 测试 → 评测 → 复盘
- 早上——看一份证据清单:哪些通过、哪些失败、哪些要决策
上百小时之后
这套系统跑了上百个小时的持续迭代——大量的夜间无人值守。下面两张是实际评测数据。相同的评测集我们可以比Codex得到高14%的分数和少23%的工具调用次数。
一种新的研发方式
回到开头:一个不会 Swift 的人,要交付一个生产级 macOS 原生软件——最终做到了。关键不是 AI 多强,而是我们把验收、测试、记忆、回归搭成了一个系统,AI 在系统里自己跑、自己验、自己积累。
人的工作从"写代码、盯执行"变成"定义标准、设计验证、决定方向"。最近"Loop Engineering"概念开始流行,我们看到的时候意识到——这就是我们在 Qoder 内部一直在用的方法。
当这个闭环跑通,一个研发不需要精通某个技术栈也能交付生产级产物。技术栈不再是壁垒,定义能力和验证能力才是。
目前 Qoder Desktop 已上线 Goal 模式和 Spec 能力,最新升级了 UltraPlan 和 UltraReview,加上 Computer Use、Browser Use 等通用验证工具,可以帮你快速搭建自己的自主迭代系统。