
记忆感知能力全面升级,更懂开发者
返回
AI 编码工具需要理解开发人员的代码库并提供相关建议。然而在实际应用中,大多数系统依赖通用的嵌入 API 来索引代码片段和文档,这往往导致不理想的体验:嵌入虽然能捕获文本相似性,却忽略了结构关系;索引每隔几分钟才刷新一次,导致开发人员无法获得最新的上下文。
本文介绍我们的代码库感知索引系统。该系统将代码向量、代码图谱和预构建的代码库知识相结合,为 AI 编码工作流程提供准确、安全且实时的上下文。以下各节将概述通用检索面临的挑战,描述我们的混合架构,并解释系统的扩展性、个性化能力和安全保障机制。
传统的检索流程依赖外部 API 计算嵌入,并使用远程向量数据库搜索相似的代码片段。这些流程的更新间隔长达数分钟;当开发人员切换分支或重命名函数时,索引会出现滞后并返回不相关的上下文。即使索引已更新,大型代码库也会产生大量嵌入,传输和查询这些数据会引入明显的延迟。
嵌入向量用于衡量文本相似性,但代码库查询往往需要理解结构关系以及架构设计。例如:调用点与其函数定义之间可能几乎没有词法重叠;文档可能使用代码中不存在的术语;同一算法的跨语言实现看起来可能完全不同。仅依赖嵌入向量会遗漏这些关系和设计知识,导致结果不相关并浪费提示空间。
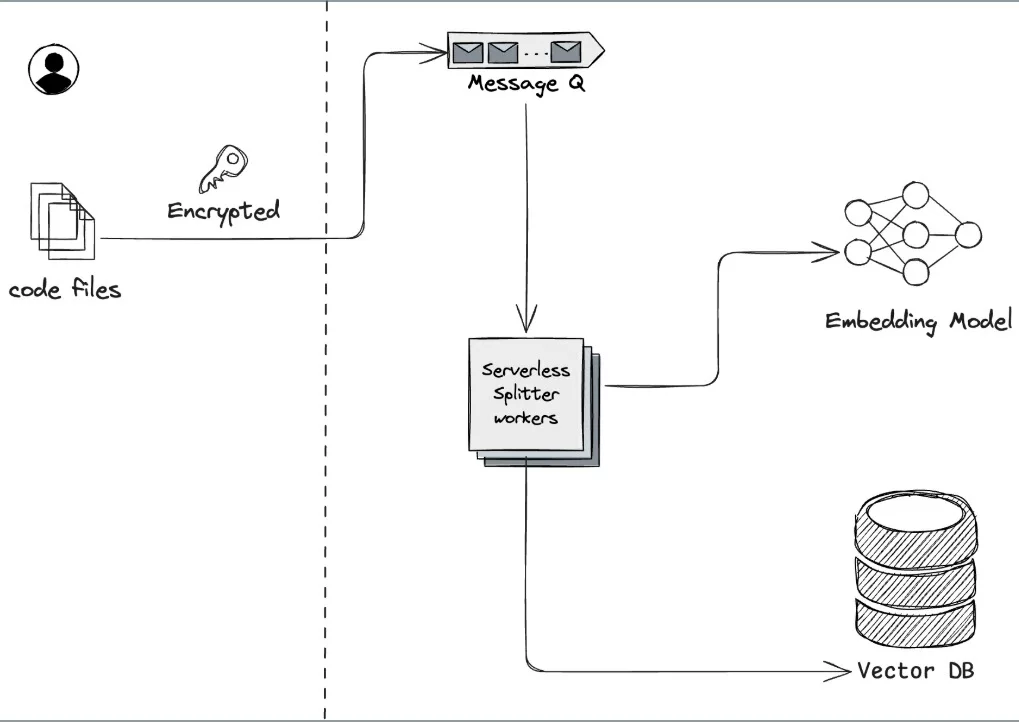
我们在服务端部署了高性能向量索引服务,用于存储代码片段及文档的向量数据。通过使用在代码和领域知识上训练的专属 AI 模型,我们生成的向量能够更好地捕获语义关系,而不仅仅是表面相似性。服务器能够高效处理索引请求,在几秒钟内完成新增或修改文件的索引。
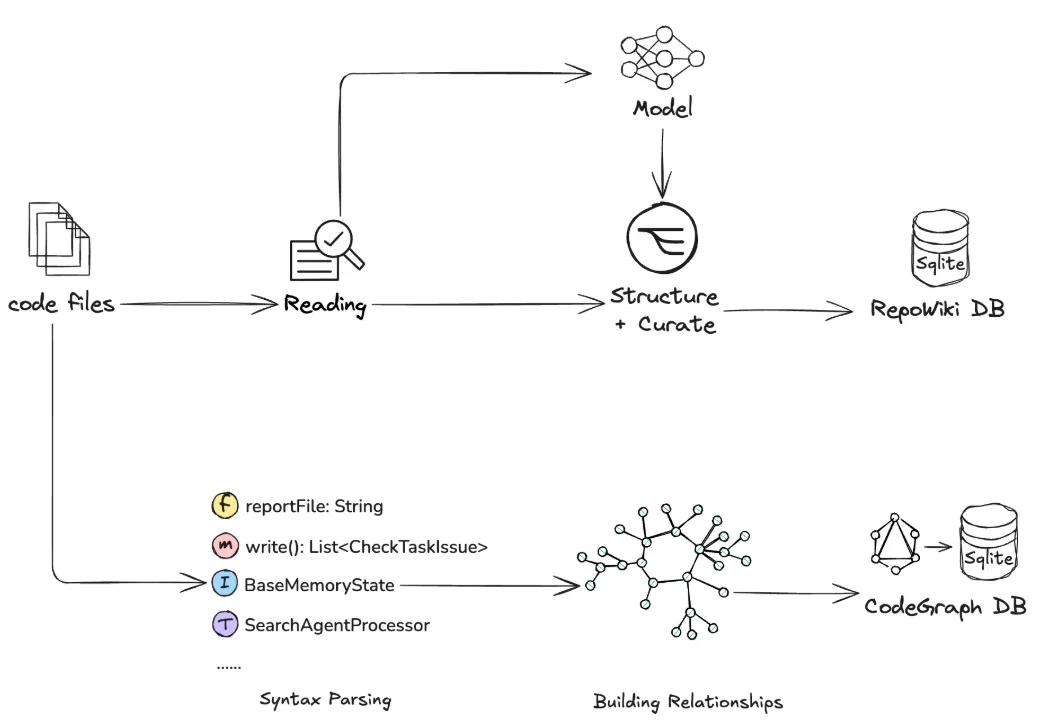
在客户端,我们构建了代码图谱来表示函数、类、模块以及它们之间的关系(例如调用图、继承关系、跨语言链接)。我们还通过 Repo Wiki 智能体生成代码库知识,包括设计文档、架构图、API文档等。代码图谱能够使我们以超低延迟查询代码符号关系,而 Repo Wiki 让我们能更快的找到代码库隐性知识。
当用户发起查询(通过聊天、智能体任务)时,系统执行以下步骤:
每个开发人员都拥有与其当前工作状态相关的个人索引。当你切换分支、编辑文件或执行批量替换操作时,客户端会将更改通知服务器,服务器随即在几秒钟内更新相应的嵌入向量,代码图谱也会同步更新。这种实时同步机制确保建议始终反映代码库的最新状态。
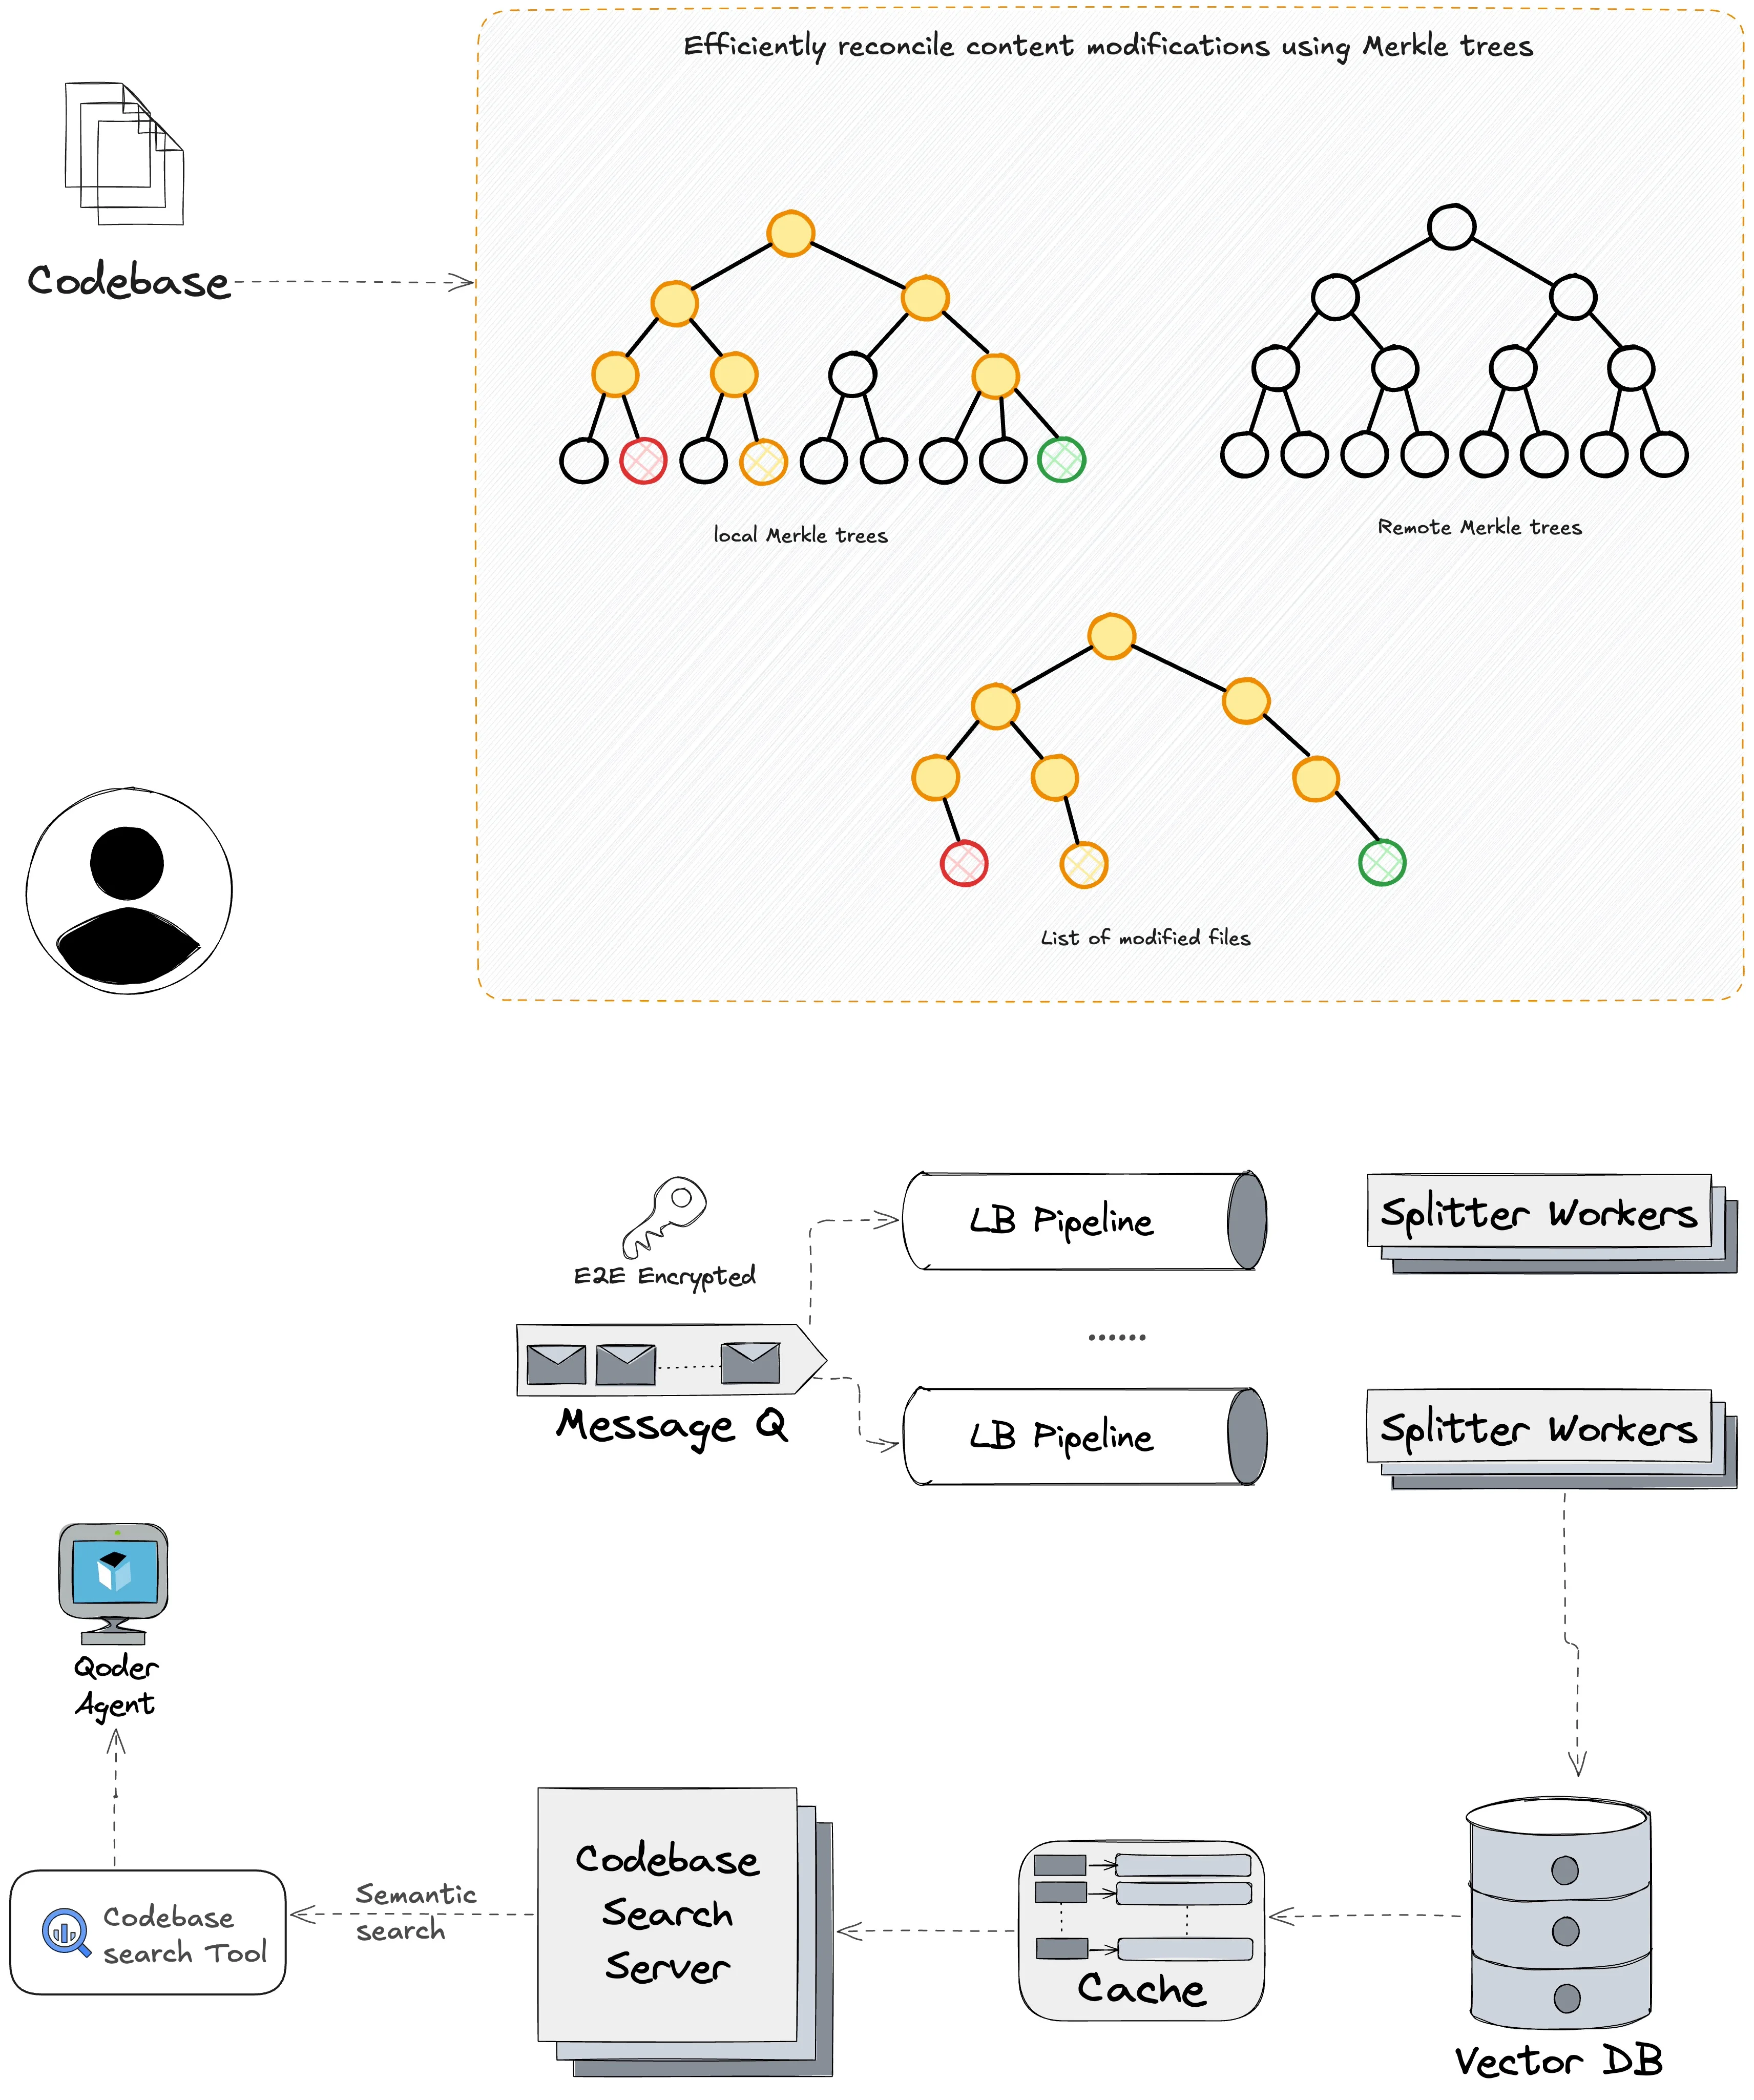
我们的后端专为处理软件开发的高吞吐量而设计。系统每秒可处理数千个文件,并支持水平扩展以适应大型代码仓库。客户端通过缓存代码图谱避免冗余计算,批量更新机制则防止网络拥塞。
我们从不存储原始代码内容,只存储其对应的嵌入向量(一组数值表示)。在检索任何代码段之前,客户端必须通过发送加密哈希来证明拥有文件内容,确保只有授权用户才能访问代码。嵌入在传输和存储时均被加密。
在大型 Monorepo 中工作时,Qoder 需要了解服务如何与下游组件交互。得益于代码图谱和 Repo Wiki,Qoder 代理能够理解整个代码库——不仅搜索具有相似名称的定义,还能找到与该函数相关的调用链、配置文件和设计文档。
在故障发生时,你需要快速识别受故障组件影响的所有代码路径。我们的混合检索系统能够呈现相关的代码模块、测试用例和运维手册(Runbook),使你比使用通用搜索更快地完成问题分析和诊断。
导言
AI 编码工具需要理解开发人员的代码库并提供相关建议。然而在实际应用中,大多数系统依赖通用的嵌入 API 来索引代码片段和文档,这往往导致不理想的体验:嵌入虽然能捕获文本相似性,却忽略了结构关系;索引每隔几分钟才刷新一次,导致开发人员无法获得最新的上下文。
本文介绍我们的代码库感知索引系统。该系统将代码向量、代码图谱和预构建的代码库知识相结合,为 AI 编码工作流程提供准确、安全且实时的上下文。以下各节将概述通用检索面临的挑战,描述我们的混合架构,并解释系统的扩展性、个性化能力和安全保障机制。
通用代码搜索面临的挑战
延迟和过时的上下文
传统的检索流程依赖外部 API 计算嵌入,并使用远程向量数据库搜索相似的代码片段。这些流程的更新间隔长达数分钟;当开发人员切换分支或重命名函数时,索引会出现滞后并返回不相关的上下文。即使索引已更新,大型代码库也会产生大量嵌入,传输和查询这些数据会引入明显的延迟。
缺乏结构感知能力
嵌入向量用于衡量文本相似性,但代码库查询往往需要理解结构关系以及架构设计。例如:调用点与其函数定义之间可能几乎没有词法重叠;文档可能使用代码中不存在的术语;同一算法的跨语言实现看起来可能完全不同。仅依赖嵌入向量会遗漏这些关系和设计知识,导致结果不相关并浪费提示空间。
混合检索架构
服务器端向量搜索
我们在服务端部署了高性能向量索引服务,用于存储代码片段及文档的向量数据。通过使用在代码和领域知识上训练的专属 AI 模型,我们生成的向量能够更好地捕获语义关系,而不仅仅是表面相似性。服务器能够高效处理索引请求,在几秒钟内完成新增或修改文件的索引。
代码图谱和代码库知识
在客户端,我们构建了代码图谱来表示函数、类、模块以及它们之间的关系(例如调用图、继承关系、跨语言链接)。我们还通过 Repo Wiki 智能体生成代码库知识,包括设计文档、架构图、API文档等。代码图谱能够使我们以超低延迟查询代码符号关系,而 Repo Wiki 让我们能更快的找到代码库隐性知识。
向量搜索与图谱检索的融合
当用户发起查询(通过聊天、智能体任务)时,系统执行以下步骤:
- 使用专属模型计算查询的嵌入向量
- 执行向量搜索,检索前 N 个相似的代码段
- 利用代码图谱基于结构关系扩展或优化候选结果(例如,包括调用检索到的代码片段的函数,或引用它的文档)
- 利用 Repo Wiki 查询相关的功能设计知识及其相关文件
- 综合相似性得分、基于图谱的相关性、Repo Wiki 的知识信息,对最终结果进行排序
实时更新和个性化
每个开发人员都拥有与其当前工作状态相关的个人索引。当你切换分支、编辑文件或执行批量替换操作时,客户端会将更改通知服务器,服务器随即在几秒钟内更新相应的嵌入向量,代码图谱也会同步更新。这种实时同步机制确保建议始终反映代码库的最新状态。